آخر تحديث: 20 Aug, 2026
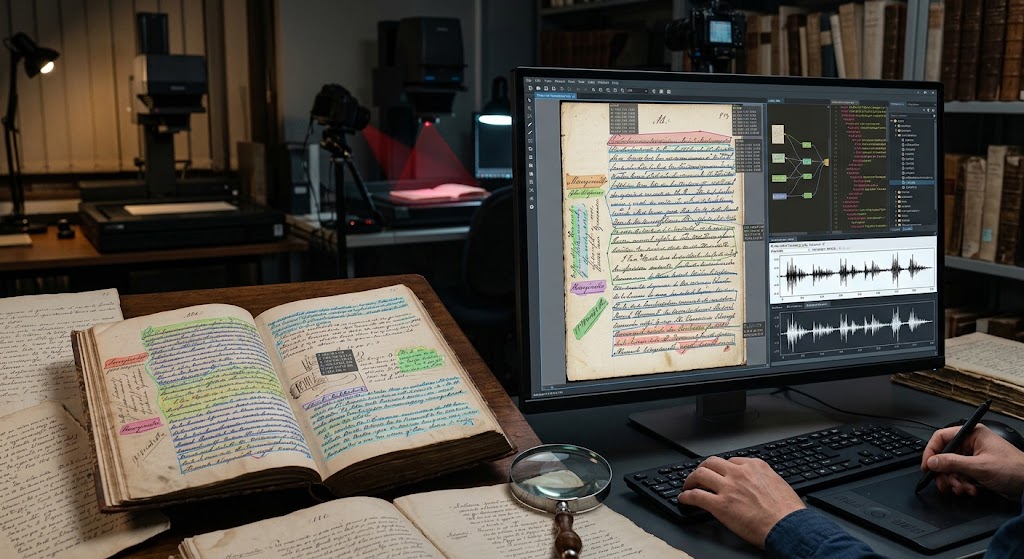
صيغ ملفات OCR للوثائق التاريخية والمكتوبة يدويًا
إن حفظ التراث الثقافي من خلال الرقمنة دخل عصرًا جديدًا. بينما تم تصميم أنظمة التعرف الضوئي على الحروف (OCR) الأولى لمعالجة المستندات الطباعة الآلية النقية من القرن العشرين، تواجه مؤسسات التراث الثقافي الحديثة تحديًا أكثر فوضى وغنى: المخطوطات الوسطى، المراسلات المكتوبة بالخط المتصل من القرن التاسع عشر، الأوراق المضيئة الهشة، والسجلات التي تعود إلى قرن مضى.
لم يعد نسخ الوثائق التاريخية يقتصر فقط على استخراج نص ASCII بسيط. إنه يتطلب التقاط السياق—الهندسة الفيزيائية للصفحة، منحنيات الخط الأساسي، تصحيحات الاختراق، الهوامش، الاختصارات، وعدم اليقين في علم الخطوط القديمة. هذا المجال المتخصص، الذي يُصنّف غالبًا تحت التعرف على النص المكتوب يدويًا (Handwritten Text Recognition (HTR))، يعتمد بشكل كبير على تنسيق الملف المستخدم لتخزين وتبادل كل من إحداثيات الصورة والطبقات النصية.
اختيار المخطط الخاطئ يمكن أن يزيل البيانات الأساسية الحيوية، يخل بتوافقه مع ملفات IIIF (International Image Interoperability Framework) manifests، أو يمنع الحفظ الرقمي طويل الأمد. إليك دليلًا نهائيًا لأهم تنسيقات ملفات OCR وHTR للوثائق التاريخية، نقاط قوتها الهيكلية، وكيفية تحديد الاختيار المناسب لسير عمل الأرشفة الخاص بك.
المعضلة التاريخية: لماذا نص عادي وملفات PDF القياسية تفشل
غالبًا ما ينتج OCR المطبوع آليًا ملفات .txt بسيطة أو ملفات PDF “sandwich” مع طبقات نص مخفية تحت المسح. بالنسبة للمخطوطات التاريخية والكتابة المتصلة، تفشل هذه المخرجات لثلاثة أسباب أساسية:
- نص غير خطي وتخطيطات معقدة: لم يلتزم النسخ التاريخيون بشبكات مستطيلة مرتبة. يتدفق النص إلى الهوامش، يلتف حول الحروف الأولية المضيئة، ينسج بين التصحيحات المتداخلة المدخلة، أو يمتد عمودياً على العمود الفقري.
- خطوط أساسية منحنية ومائلة: نادراً ما يتبع الخط المتصل محورًا أفقيًا صلبًا. تعتمد محركات التعرف على النصوص المكتوبة يدويًا مثل Transkribus و Kraken و eScriptorium على خطوط أساسية متعددة الخطوط بدلاً من الصناديق المحيطة لتفسير الخطوط التي تحتوي على الكثير من الأحرف المتصلة.
- تعقيد علم الخط والبيانات الوصفية: يتطلب البحث الأرشيفي تتبع الاختصارات، واختلافات التهجئة التاريخية، والقراءات المتضررة، ودرجات الثقة على مستوى السطر. تتخلص صيغ المستندات القياسية من هذه الدقة.
للحفاظ على الدقة للقطعة الأصلية، تعتمد المجتمع الأرشيفي على مخططات XML منظمة صُممت للحفاظ على طوبولوجيا التخطيط إلى جانب النص المنقوش.
1. PAGE XML: المعيار الذهبي للتعرف على النص المكتوب يدويًا (HTR)
تم تطويره بواسطة مختبر أبحاث PRImA (التعرف على الأنماط وتحليل الصور)، PAGE XML (عناصر تحليل الصفحات والبيانات الحقيقية) يُعتبر على نطاق واسع الصيغة المتقدمة للتعرف على النص المكتوب يدويًا وتحليل التخطيط المتقدم.
البنية الأساسية
تتعامل PAGE XML مع المستند الفيزيائي كهيكل هرمي:
PcGts(الجذر)Page(أبعاد الصورة والترتيب العام للقراءة)TextRegion(فقرات، عناوين، ملاحظات هامشية، كلمات ربط)TextLineCoords(إحداثيات المضلع حول السطر)Baseline(سلسلة من النقاط تتبع الخط الأساسي الحقيقي للنص)TextEquiv(النص المعترف به، مع مقاييس الثقة الاختيارية)
لماذا يتفوق على المخطوطات التاريخية
- دقة المضلع والخط المتعدد النقاط: بدلاً من إجبار الأحرف داخل صناديق مستطيلة، يستخدم PAGE XML حدودًا متعددة النقاط للمضلعات وخطوط أساسية مستمرة. هذا يمنع تداخل القواعد والذيلات المتصلة المتداخلة من التدخل في التجزيء.
- أنواع هيكلية دقيقة: يمكن تصنيف المناطق بدقة (مثال:
marginalia،drop-capital،signature-mark،header،editorial-note). - نظام برمجيات واسع: يعمل كالمخطط الداخلي والأساسي للتصدير لمنصات HTR الرائدة مثل Transkribus، eScriptorium، و Kraken.
2. ALTO XML: القوة المحركة للمكتبة والأرشيف
ALTO (Analyzed Layout and Text Object) هو معيار XML مفتوح تُديره مكتبة الكونغرس وقد تم تبنيه على نطاق واسع من قبل المكتبات الوطنية، بما في ذلك المكتبة الوطنية الفرنسية (BnF) ومكتبة بريطانيا.
البنية الأساسية
يقوم ALTO بتنظيم التخطيط هرميًا من Page إلى PrintSpace، ثم إلى TextBlock و TextLine و String (كلمات أو رموز فردية). يتم غالبًا حزمها داخل غلاف METS (Metadata Encoding and Transmission Standard) لربط البيانات الوصفية الهيكلية مع الصور الأصلية عالية الدقة.
النقاط القوية وحالات الاستخدام
- مسارات الرقمنة الضخمة: تم تصميم ALTO مع مراعاة الرقمنة الصناعية للصحف والكتب. يقوم بترميز خصائص الخط، إحداثيات مستوى الكلمة، ثقة الأحرف، والمسافات البيضاء بدقة.
- دعم HTR الحديث (ALTO 4): النسخ السابقة من ALTO اعتمدت بشكل كبير على الإحداثيات المستطيلة (
HPOS,VPOS,WIDTH,HEIGHT). ومع ذلك، بدءًا من إصدار ALTO 4، قدم المخطط عناصر<Shape>متعددة الأضلاع وخطوط أساسية متعددة النقاط، مما أغلق الفجوة الوظيفية مع PAGE XML للمواد المكتوبة يدويًا. - الحفظ على المدى الطويل: نظرًا لأنه معيار رسمي مدعوم من قبل اتحادات المكتبات الدولية، يضمن ALTO استقرارًا طويل الأمد وتوافقًا رجعيًا من مستوى الأرشيف.
3. hOCR: المعيار الخفيف الوزن الموجه للويب أولاً
أنشأه توماس برويل، hOCR يتبع نهجًا عمليًا: بدلاً من إنشاء مخطط XML جديد كليًا، يدمج بيانات التخطيط والنص مباشرةً في HTML/XHTML الدلالي باستخدام الميكروصيغ وسمات الفئة.
مثال على بناء الجملة النموذجي
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">المقدمة</span>
      </span>
    </p>
  </div>
</div>
الإيجابيات والسلبيات للمواد التاريخية
- الإيجابيات: يمكن للمتصفحات عرضها أصلاً. يمكن تحويلها بسهولة باستخدام CSS وجافاسكريبت العادي، وهي تنسيق التصدير الهيكلي الافتراضي للمحركات مثل Tesseract.
- السلبيات: الدعم الأصلي للمنحنيات الخطية المتعددة النقاط المعقدة والحرة محدود. بينما هو عملي للأعمال المطبوعة المبكرة (الكتب الأولى أو الصحف النظيفة)، يواجه hOCR صعوبات مع تخطيطات المخطوطات غير المنتظمة والهامش المتعدد الطبقات.
4. TEI-XML: المعيار الأكاديمي والإنسانيات الرقمية
تنسيق Text Encoding Initiative (TEI) ليس بالضرورة تنسيق مخرجات محرك OCR؛ بل هو المعيار الرائد للإصدارات الرقمية النقدية والتمثيل الأكاديمي للنصوص الأدبية والتاريخية.
ربط OCR/HTR بـ TEI
قنوات المعالجة الحديثة نادراً ما تتوقف عند التعرف على الأحرف الخام. يستخدم الباحثون أدوات مثل Transkribus TEI Exporter أو خطوط أنابيب XSLT الآلية لتحويل ملفات PAGE XML أو ALTO إلى XML متوافق مع TEI:
- يتم توسيع الاختصارات (
<choice><abbr>...</abbr><expan>...</expan></choice>). - يتم تصنيف الحذف والإضافات وأيدي النسخ رسمياً (
<add>,<del>,<handShift>). - يتم الحفاظ على بيانات التخطيط إلى جانب التحليل الأدبي عبر عناصر
<facsimile>و<surface>.
إذا كان مشروعك التاريخي يهدف إلى إنشاء نسخة نقدية تفاعلية أو أرشيف أكاديمي قابل للبحث الدلالي، فإن تحويل بيانات OCR/HTR إلى TEI-XML غالباً ما يكون الخطوة النهائية المطلوبة.
مصفوفة مقارنة: صيغ OCR/HTR بنظرة سريعة
| الميزة / المعيار | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| النطاق الأساسي | الخط المتصل HTR & المخطوطات | رقمنة المكتبة الضخمة | التعرف الضوئي على الحروف (OCR) عبر الويب والبحث الخفيف | الإصدارات النقدية العلمية |
| دعم أساسي | الخطوط المتعددة النقاط الأصلية | مدعوم (منذ الإصدار 4.0) | أساسي (انحدار/إزاحة) | عبر رسم الخرائط النسخي |
| مضلعات غير منتظمة | كامل | كامل | محدود | عبر عناصر الإحداثيات |
| نظام الأدوات | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, عارضات الويب | Oxygen, TEI Publisher |
| الهيئة المعيارية | PRImA Group / Open | مكتبة الكونغرس | مواصفة المجتمع | تحالف TEI |
توصيات عملية: اختيار خط أنابيب الأرشفة الخاص بك
لإنشاء خط أنابيب رقمنة فعال ومستقبلي:
- للمخطوطات والوثائق المكتوبة يدويًا النقية: قم بتوحيد عملية النسخ واستخراج التخطيط على PAGE XML. حساب الخط الأساسي وتحديد حدود المضلع الخاص به يتعامل مع الخطوط الكتابية غير القياسية بأقل فقدان للبيانات.
- للمكتبات الضخمة والمجموعات المختلطة: اختر ALTO XML (الإصدار 4.2 أو أعلى) مقترنًا بـ METS. هذا يضمن دمجًا سلسًا في بنى المستودعات الرقمية القياسية وأنظمة إدارة الأصول الرقمية (DAMS).
- لعرض الويب وفهارس البحث النصي الكامل: استخدم hOCR أو استخرج هياكل GeoJSON/تعليقات ويب خفيفة الوزن من PAGE XML لتشغيل عارضات IIIF التفاعلية (مثل Mirador أو Universal Viewer) مع طبقات نصية حية داخل المتصفح.
- لإصدارات علمية والبحث الباليغرافي: أنشئ الحقيقة الأرضية الخاصة بك بصيغة PAGE XML، نفّذ التعرف، ومرّر الناتج عبر محول آلي لتوليد TEI-XML لتعليمات التحرير.
من خلال مطابقة القدرات الهيكلية لهذه الصيغ مع متطلبات البحث الباليغرافي لموادك المصدرية، تضمن أن كل ضربة قلم، واختصار، وتفصيل تاريخي يظل قابلاً للفهم لقرون قادمة.
الأسئلة المتكررة (FAQ)
Q1. ما هو الفرق الأساسي بين OCR القياسي وHTR؟ يتعرف OCR على الطباعة الآلية المتسقة، بينما يستخدم HTR (التعرف على النص المكتوب يدويًا) الشبكات العصبية العميقة لفك شفرة الخط اليدوي البشري المتواصل والمتغير والخطوط القاعدية المنحنية.
Q2. هل يمكن لـ Tesseract OCR إنتاج PAGE XML أو مخرجات ALTO للوثائق التاريخية؟ نعم، يمكن لـ Tesseract توليد ALTO XML الأصلي وإخراج hOCR، ويمكن للغلافات الطرفية الثالثة تحويل هذه النتائج إلى PAGE XML.
Q3. لماذا تعتبر الخطوط القاعدية أكثر أهمية من الصناديق المحيطة في نسخ النصوص المكتوبة يدويًا؟ تتعقب الخطوط القاعدية الخط الطبيعي المتعرج للخط البشري، مما يسمح للبرمجيات بفصل الصاعدين والنازلين المتداخلين الذين يتصادمون داخل الصناديق المحيطة الصلبة.
س4. كيف يتفاعل معيار IIIF مع تنسيقات ملفات OCR هذه؟ يقدم IIIF صورًا عالية الدقة عبر واجهات برمجة تطبيقات ويب مفتوحة، بينما توفر تنسيقات مثل ALTO أو PAGE XML بيانات إحداثيات يمكن تحويلها إلى تعليقات توضيحية للبحث في محتوى IIIF.
س5. أي تنسيق ملف هو الأسهل للتحويل مباشرة إلى PDF قابل للبحث؟ يمكن دمج كل من hOCR و ALTO XML مع صور الصفحات الأصلية لإنشاء ملفات PDF ذات طبقتين قابلة للبحث باستخدام أدوات مثل OCRmyPDF.