آخر تحديث: 30 سبتمبر، 2026
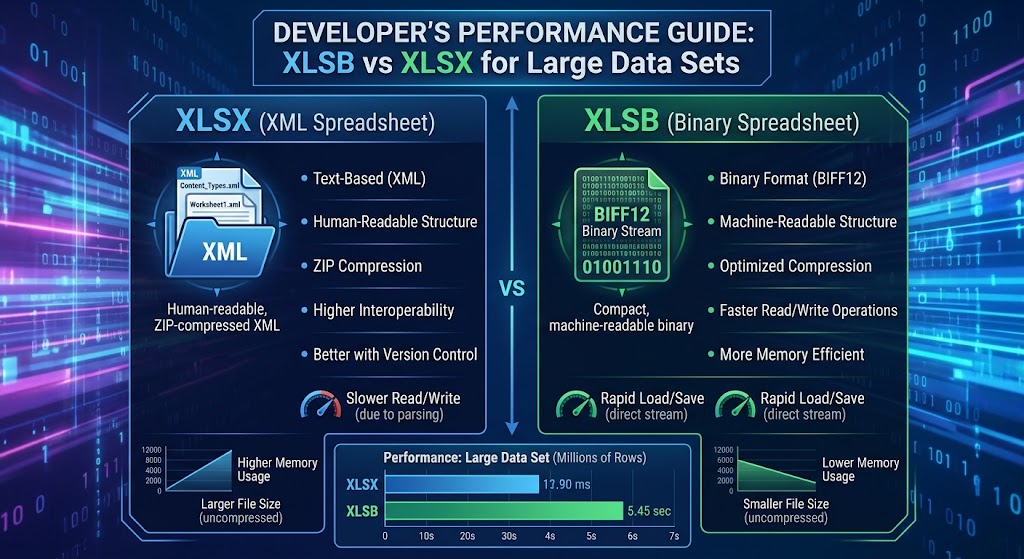
XLSB مقابل XLSX لمجموعات البيانات الكبيرة: دليل الأداء للمطور
إذا كنت تبني خطوط أنابيب البيانات أو محركات التقارير الخلفية أو أدوات التحليل التي تتفاعل مع Microsoft Excel، فمن المحتمل أنك صادفت "العقبة".
يقوم مستخدم بتحميل مصنف يحتوي على 450,000 صف. يقوم خادمك بإنشاء خيوط عمل، وتزداد استهلاك الذاكرة إلى عدة جيجابايت، وتتجمد جمع القمامة وقت التشغيل، وينتهي مهلة التنفيذ. تقوم بفحص الحمولة: إنها ملف .xlsx قياسي.
لحل هذه المشكلة، يقضي المطورون غالبًا أيامًا في تنفيذ التجزئة، أو محللات البث، أو نقل الملفات إلى عمال خلفية. ومع ذلك، أحد أكثر التحسينات فعالية لا يتطلب أي إعادة تصميم معمارية: تغيير امتداد الملف من .xlsx إلى .xlsb.
في هذا الدليل، نغوص تحت غطاء كلا الصيغتين، نفحص لماذا تنتج هياكلهما الداخلية خصائص أداء مختلفة جذريًا، نقارن معايير ملموسة عبر Python و .NET، ونوضح قواعد واضحة لمتى يتم نشر المصنفات الثنائية في بيئة الإنتاج.
1. تحت الغطاء: OpenXML مقابل BIFF12
لفهم لماذا يختلف الأداء بشكل كبير على مجموعات البيانات الضخمة، يجب أن ننظر إلى كيفية تخزين كل صيغة للسجلات على القرص.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
كلا ملفي .xlsx و .xlsb هما حاويات ZIP مضغوطة تتوافق مع اتفاقيات الحزم المفتوحة (OPC). إذا قمت بإعادة تسمية أي من الملفين إلى .zip واستخراجها، سترى بنية دليل مألوفة: _rels، docProps، و xl/worksheets/.
الفرق الحاسم يكمن داخل المجلد xl/worksheets/:
- XLSX يخزن الأوراق كنص XML عادي (
sheet1.xml). - XLSB يخزن الأوراق كتيارات ثنائية مملوكة (
sheet1.bin)، مشفرة باستخدام BIFF12 من مايكروسوفت (Binary Interchange File Format 12).
كيف XLSX يشفّر البيانات (تكلفة XML DOM)
في ورقة عمل XLSX، يتم إعلان كل خلية باستخدام علامات XML صريحة:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
عند قراءة هذا الصف، يجب على بيئة التشغيل الخاصة بك:
- فك ضغط تدفق الـ deflate الخام إلى نص.
- تحليل الرموز وتفكيك أحرف السلسلة إلى شجرة DOM XML أو تدفق أحداث SAX.
- تحقق من صحة علامات الفتح والإغلاق (
<c>,</c>,<v>,</v>). - حل عمليات البحث عن السلاسل من جدول
sharedStrings.xmlمنفصل. - تحليل النص ASCII “98234.55” إلى عدد عائم IEEE 754 بدقة 64 بت.
كل خلية واحدة تتسبب في استهلاك وحدة المعالجة المركزية لعمليات تحليل السلاسل، تخصيص السلاسل، والتحليل اللغوي. إذا ضربنا ذلك على 500,000 صف و30 عمود (15 مليون خلية)، فإن وحدة المعالجة المركزية تقضي دورات أكثر بكثير في تحليل الصياغة مقارنةً بمعالجة قيم المجال.
كيف XLSB يشفّر البيانات (تيار ثنائي BIFF12)
يتخلى BIFF12 عن تسلسل النص تمامًا. بدلاً من ترميز السلاسل، يتم ترتيب البيانات كسلسلة متتابعة من سجلات ثنائية ذات طول متغير:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
الخلية العائمة في BIFF12 لا تستخدم تمثيلات نصية مثل “98234.55”. يتم تمثيلها مباشرةً:
- 2 بايت لمعرّف السجل (مثال:
BrtCellRkأوBrtCellReal) - 4 بايت لمؤشرات العمود/الصف
- 8 بايت تحتوي على البنية الخام للبايت ذات الدقة المزدوجة وفق IEEE 754
عندما يقرأ المحلل الخاص بك ملف XLSB، يتجاوز التحليل اللغوي تمامًا. يقرأ رأس السجل، يلتقط الـ 8 بايت الخام من الذاكرة المؤقتة، ينسخها مباشرة إلى الذاكرة، ويحرك المؤشر إلى الأمام. لا توجد وسوم للتحقق، ولا تحويلات من سلسلة إلى رقم، ولا أي عبء فك ترميز UTF-8 للبيانات العددية.
2. مؤشرات كمية: القرص، الذاكرة، ومعدل النقل
لتوضيح التأثير الواقعي، اعتبر مجموعة بيانات محاكاة تحتوي على 750,000 صفًا و25 عمودًا (مزيج من الطوابع الزمنية، الأعداد العشرية، الأعداد الصحيحة، ورموز الفئات).
الاختبارات أدناه تقيم بيانات جدولة متطابقة محفوظة كملفات XLSX و XLSB.
بيئة الاختبار
- المعالج: AMD Ryzen 9 5900X (12 نواة، 24 خيط)
- الذاكرة العشوائية: 64 جيجابايت DDR4-3600
- التخزين: PCIe 4.0 NVMe SSD
- وقت التشغيل: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
مقاييس الأداء الرئيسية
| المقياس | XLSX (OpenXML) | XLSB (BIFF12) | دلتا / تحسين |
|---|---|---|---|
| حجم الملف على القرص | 128.4 MB | 68.2 MB | ~47% أصغر |
| وقت الحفظ / التسلسل | 42.6 s | 14.1 s | 3.0x أسرع |
| وقت القراءة (محلل DOM بايثون) | 38.2 s | 8.9 s | 4.3x أسرع |
| وقت القراءة (محرك Rust/C) | 6.4 s | 1.9 s | أسرع بـ 3.3 مرة |
| أعلى تخصيص للذاكرة المؤقتة أثناء القراءة | ~1.85 GB | ~510 MB | ~72% انخفاض |
لماذا ملفات XLSB أصغر
بينما يستخدم كلا التنسيقين ضغط ZIP القياسي، فإن تدفقات البيانات الثنائية تضغط بكفاءة أعلى بكثير من نص XML المتضخم:
- تم القضاء على الصياغة الزائدة: يحتوي XML على وسوم متكررة (
<c r="AA1" s="1">) في كل سجل. بينما يقلل ضغط ZIP من السلاسل المتكررة، فإن تدفق البيانات غير المضغوط يكون ضخمًا. - كثافة الأرقام: في XML، الرقم
12345678.9012يتطلب 14 بايت من نص ASCII. في BIFF12، يتم تخزينه كعدد مزدوج 8 بايت (أو يُضغط في سجلRK4 بايت إذا كان يطابق قواعد الدقة المحددة).
3. استهلاك الذاكرة وضغط جمع القمامة
بالنسبة لخدمات الويب والمايكرو سيرفيس التي تتعامل مع طلبات متزامنة، فإن سرعة المعالج هي مجرد نصف المعركة؛ بصمة الذاكرة هي ما يؤدي فعليًا إلى فشل التطبيقات.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
عند معالجة محلل XML لملف XLSX بحجم 100 ميغابايت، يجب عليه إنشاء آلاف الرموز النصية المؤقتة، ومخازن مقاطع السلاسل، وعمليات البحث في القاموس. في اللغات التي تعتمد على جمع القمامة (Java، C#، Go، Node.js، Python)، يسبب ذلك تجزئة شديدة في الكومة ويدفع وقت التشغيل إلى توقفات جمع القمامة (GC) المتكررة.
نظرًا لأن تحليل XLSB يعمل مباشرةً على مقاطع بايت ذات عرض ثابت، يمكن للمحللات قراءة البيانات إلى هياكل مخصصة على المكدس أو مخازن بايت قابلة لإعادة الاستخدام. النتيجة هي تقليل كبير في استهلاك الذاكرة وعدم حدوث أي اضطراب في مخصص وقت التشغيل.
4. أمثلة تنفيذ المطور
دعونا نلقي نظرة على كيفية الاستفادة من XLSB عبر سلاسل أدوات المطورين الشائعة.
Python: الانتقال من OpenPyXL إلى Calamine / PyXLSB
الأمر القياسي pandas.read_excel('data.xlsx') يستخدم openpyxl بشكل افتراضي، والذي يبني شجرة ثقيلة في الذاكرة.
لمعالجة ملفات XLSB الكبيرة بأقصى سرعة، استخدم محرك calamine المدعوم بـ Rust (متاح عبر python-calamine ومدمج في Pandas الحديثة):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
إذا كنت تتنقل عبر مجموعات بيانات ضخمة صفًا بصف دون تحميل المصفوفة بالكامل إلى DataFrame، فإن pyxlsb يوفر مكرّر تدفق خفيف الوزن:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: استيعاب تدفق عالي الأداء
في .NET، المكتبات مثل ClosedXML أو EPPlus ممتازة لإنشاء الملفات القياسي، ولكن لاستيعاب ملفات كبيرة دون استنزاف الذاكرة، فإن ExcelDataReader مع دعم XLSB سريع بشكل استثنائي:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. مقايضات معمارية: متى لا يجب استخدام XLSB
على الرغم من مزاياه الهائلة في الأداء، فإن XLSB ليس حلاً سحريًا. يجب عليك موازنة عدة مقايضات تشغيلية قبل تطبيقه عبر بنيتك التقنية:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. النظام البيئي ودعم المكتبات
- XLSX: عالمي. تقريبًا كل لغة، مكتبة، أداة SaaS (Google Sheets، Airtable، Tableau)، ومحلل ويب يدعم OpenXML بشكل أصلي.
- XLSB: أقل انتشارًا. بينما يدعم Excel وLibreOffice ومكتبات المطورين الناضجة (
ExcelDataReader،pyxlsb،calamine،Aspose) ذلك، فإن العديد من الحزم الخفيفة أو محللات JavaScript المستندة إلى الويب النقية (مثل الإصدارات القديمة منSheetJS) لديها دعم محدود أو للقراءة فقط.
2. Git وإجراء الفروقات في التحكم بالإصدار
- XLSX: لأنه يحتوي على نص XML داخل حاوية ZIP، يمكن لأدوات سطر الأوامر وGit hooks فك الضغط وتنسيق XML لإنشاء اختلافات هيكلية قابلة للقراءة بين الالتزامات.
- XLSB: بيانات ثنائية صافية. تتعامل أنظمة التحكم في الإصدارات معها ككتلة ثنائية غير شفافة تمامًا، مما يلغي أي إمكانية لإجراء اختلافات دقيقة أو دمج على مستوى السطر.
3. عرض عميل الويب
إذا كان بناؤك يعتمد على عرض جداول البيانات مباشرة في المتصفح عبر WebAssembly أو JavaScript من جانب العميل، فإن محللات XLSX أكثر نضجًا بشكل كبير وأقل عرضة لأخطاء العرض في الحالات الحدية مقارنةً بمحللات الثنائي من جانب العميل.
4. خطوط استيعاب الطرف الثالث
إذا كنت تقوم بتصدير ملفات لعملاء مؤسسات خارجيين، فإن العديد من سياسات الأمان الصارمة في الشركات تُعلم عن ملفات .xlsb. نظرًا لأن ملفات BIFF12 يمكنها تخزين ماكرو VBA بشكل مماثل لملفات .xlsm (دون الحاجة إلى امتداد منفصل)، فإن بعض مرشحات البريد ومسحات جدار الحماية تعزل تحميلات .xlsb كتهديدات محتملة تحمل ماكرو.
6. مقارنة ملخصة: أي صيغة تفوز؟
| الميزة | XLSX | XLSB | الفائز |
|---|---|---|---|
| سرعة القراءة / التحليل | متوسط إلى ضعيف | سريع جدًا | XLSB |
| سرعة الكتابة / الإنشاء | مستهلك للمعالج | سريع | XLSB |
| ضغط الملف | جيد | ممتاز (~40-50% أصغر) | XLSB |
| تخصيص الذاكرة | عالي (ضغط جمع القمامة كبير) | منخفض (قراءة بايت مباشرة) | XLSB |
| قابلية التفاعل بين الأدوات | عالمي | عالية، لكن انتقائية | XLSX |
| احتكاك فحص الأمان | قليل | إيجابيات كاذبة أحيانًا | XLSX |
| قدرة الماكرو | لا (.xlsm مطلوب) | نعم (يدعم الماكرو أصليًا) | ربط |
7. حكم المطور
استخدم XLSX عندما:
- الملفات صغيرة إلى متوسطة الحجم (< 50,000 صف).
- يجب أن تُستقبل ملفاتك بواسطة منصات SaaS من طرف ثالث أو تطبيقات المستهلك (مثل Google Sheets).
- لا يمكنك التحكم في بيئة العميل النهائي الذي يقرأ الملف.
تحول إلى XLSB عندما:
- أنت تبني خطوط أنابيب داخلية، وظائف دفعات، أنظمة ETL، أو مهام عامل تتعامل مع استخراج بيانات هائل (> 100,000 صف).
- تواجه خوادمك أخطاء نفاد الذاكرة (OOM) أثناء تسلسل أو إلغاء تسلسل جداول البيانات.
- تحتاج إلى تقليل بصمة تخزين S3/Blob ووقت انتقال الشبكة للنماذج المالية المتكررة الكبيرة أو تصدير البيانات.
التحول إلى XLSB غالبًا ما يكون بسيطًا مثل تغيير سلسلة التكوين في خدمة التصدير الخاصة بك، ومع ذلك يحقق تحسينات في معدل النقل تتراوح بين 3 إلى 5 أضعاف عادةً ما تتطلب أسابيع من تحسين الكود.
الأسئلة المتكررة (FAQ)
**Q1: هل يدعم ملف XLSB نفس حدود الصفوف والأعمدة بالضبط مثل ملف XLSX؟ نعم؛ كلا من XLSB و XLSX يشتركان في نفس الحد الأقصى للشبكة وهو 1,048,576 صفًا بـ 16,384 عمودًا لكل ورقة عمل.
**Q2: هل يمكن لملف XLSB تخزين ماكرو VBA بأمان دون تغيير امتداد الملف؟
نعم، على عكس XLSX (الذي يتطلب الحفظ كـ XLSM لتشغيل الكود)، يدعم XLSB تخزين ماكرو VBA الثنائي أصلاً داخل نفس تنسيق الملف .xlsb.
**Q3: لماذا يؤدي حفظ الملف كـ XLSB إلى تقليل حجمه إذا كان كلا التنسيقين مضغوطين بالفعل باستخدام ZIP؟ يقوم XLSB بإزالة علامات ترميز النص التفصيلية ويُشفّر مواضع الخلايا والسجلات والقيم العددية الخام في تدفقات بايت ثنائية مضغوطة أكثر كثافةً من سلاسل XML العادية.
**Q4: هل يمكن لبرنامج Google Sheets استيراد وتحرير ملفات XLSB مباشرةً؟
لا؛ لا يمكن لـ Google Sheets فتح أو تحويل ملفات .xlsb مباشرةً، لذا يتعين عليك تحويلها إلى .xlsx أو CSV قبل الاستيراد.
**Q5: هل ملفات XLSB أكثر عرضة لتلف البيانات مقارنةً بملفات XLSX؟ في حين يمكن أحيانًا فحص ملفات XML يدويًا أو إصلاحها باستخدام محرر نصوص عندما تكون جزئيًا تالفة، تتطلب تدفقات BIFF12 الثنائية إزاحات بايت دقيقة وتكون صعبة الاستعادة يدويًا إذا تضررت القطاعات الهيكلية.