Son Yenilənmə: 30 Sentyabr, 2026
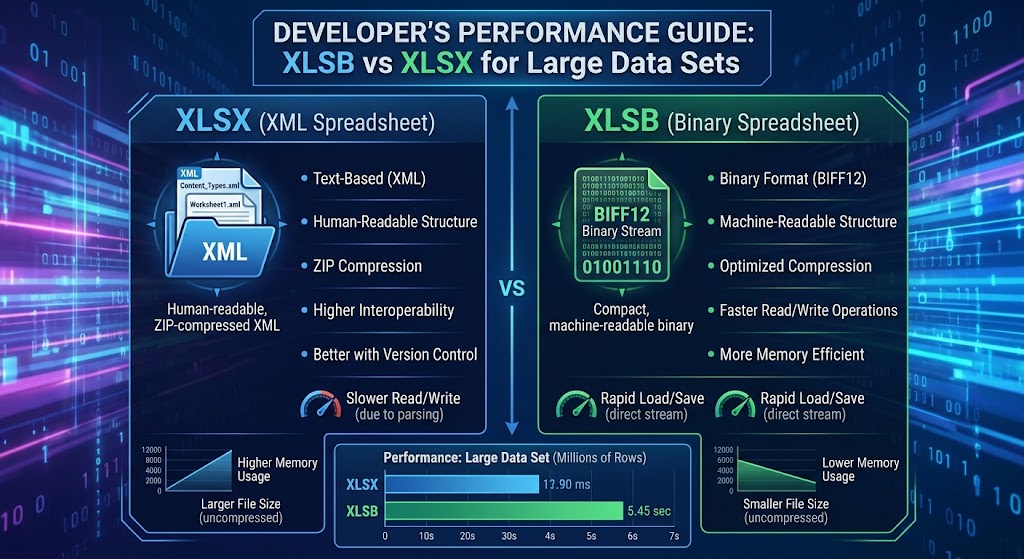
Böyük Məlumat Dəstləri üçün XLSB vs XLSX: Tərtibatçının Performans Bələdçisi
Əgər siz məlumat boru kəmərləri, arxa plan hesabat mühərrikləri və ya Microsoft Excel ilə əlaqə quran analitika alətləri yaradırsınızsa, ehtimal ki, “divara” dəyibsiniz.
İstifadəçi 450,000 sətirlik iş dəftəri yükləyir. Serveriniz işçi iplikləri işə salır, yaddaş istifadəsi gigabaytlara yüksəlir, zibil toplama icra mühitini dondurur və icra müddəti vaxtı aşır. Yükü yoxlayırsınız: bu, standart .xlsx fayldır.
Bunu həll etmək üçün, tərtibatçılar tez-tez chunking, axın parserləri tətbiq etmək və ya faylları arxa plan işçilərinə yükləmək üçün günlər sərf edirlər. Lakin, ən təsirli optimizasiyalardan biri heç bir arxitektur yenidən dizayn tələb etmir: fayl uzantısını .xlsx‑dən .xlsb‑yə dəyişdirmək.
Bu bələdçidə, hər iki formatın daxili strukturlarına dərinləşirik, onların daxili arxitekturasının niyə radikal şəkildə fərqli performans xüsusiyyətləri yaratdığını araşdırırıq, Python və .NET üzrə konkret benchmarkları müqayisə edirik və istehsalda ikili iş dəftərlərinin nə zaman yerləşdirilməli olduğu barədə aydın qaydalar təqdim edirik.
1. Arxa Planda: OpenXML vs. BIFF12
Performansın böyük məlumat dəstlərində niyə bu qədər dramatik şəkildə fərqləndiyini başa düşmək üçün, hər bir formatın qeydləri diskte necə saxladığına baxmalıyıq.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Həm .xlsx həm də .xlsb faylları Open Packaging Conventions (OPC) standartına uyğun sıxılmış ZIP konteynerləridir. Hər hansı bir faylın adını .zip olaraq dəyişdirib çıxartdığınızda, tanış bir qovluq strukturu görəcəksiniz: _rels, docProps və xl/worksheets/.
Əsas fərq xl/worksheets/ qovluğunun içindədir:
- XLSX cədvəlləri sadə XML mətn kimi (
sheet1.xml) saxlayır. - XLSB cədvəlləri özəl ikili axınlar kimi (
sheet1.bin) saxlayır, Microsoft-un BIFF12 (Binary Interchange File Format 12) kodlamasından istifadə edir.
Necə XLSX Məlumatı Kodlayır (XML DOM Yükü)
XLSX iş vərəqində, hər hüceyrə açıq XML teqləri ilə bəyan edilir:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Bu sətri oxuyarkən, icra mühitiniz aşağıdakını etməlidir:
- Xam deflate axınını mətnə sıxılmışdan çıxarın.
- Simvol ardıcıllığını tokenləşdirin və XML DOM və ya SAX hadisə axınına parse edin.
- Açma və bağlama teqlərini doğrulayın (
<c>,</c>,<v>,</v>). - Ayrı
sharedStrings.xmlcədvəlindən sətir axtarışlarını həll edin. - ASCII mətnini
"98234.55"IEEE 754 64-bit üzən nöqtə ədədinə çevirin.
Hər bir hüceyrə sətir təhlili, sətir ayrılması və leksik analiz üçün CPU yükü yaradır. Bunu 500 000 sətir və 30 sütun (15 milyon hüceyrə) üzrə çoxaltsaq, CPU sintaksisin təhlili üçün sahə dəyərlərinin işlənməsindən xeyli daha çox dövrə sərf edir.
Necə XLSB Məlumatı Kodlayır (BIFF12 İkili Axını)
BIFF12 mətn seriyalaşdırmasını tamamilə ləğv edir. Sətir işarələməsi yerinə, məlumat dəyişkən uzunluqlu ikili qeydlərin ardıcıl ardıcıllığı kimi təşkil olunur:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12-də üzən nöqtəli hüceyrə "98234.55" kimi sətir təmsillərindən istifadə etmir. O birbaşa təmsil olunur:
- Qeyd ID üçün 2 bayt (məsələn,
BrtCellRkvə yaBrtCellReal) - Sütun/sətir indeksləri üçün 4 bayt
- 8 bayt xam, IEEE 754 ikiqat dəqiqlikli bayt strukturu
Parseriniz XLSB faylını oxuduqda, leksik təhlili tamamilə ötürür. O, qeyd başlığını oxuyur, buferdən 8 xam baytı götürür, onları birbaşa yaddaşa köçürür və göstəricini irəliyə hərəkət etdirir. Doğrulama üçün heç bir etiket yoxdur, sətir‑rəqəm tip çevrilmələri yoxdur və rəqəmli məlumatlar üçün UTF‑8 dekodlaşdırma yükü sıfırdır.
2. Kəmiyyət Ölçüləri: Disk, Yaddaş və İşləmə sürəti
Real‑dünya təsirini göstərmək üçün, 750,000 sətir və 25 sütun (zaman möhürləri, üzən nöqtəli ədədlər, tam ədədlər və kateqoriya kodlarından ibarət qarışıq) ehtiva edən simulyasiya edilmiş bir məlumat dəstini nəzərə alın.
Aşağıdakı testlər eyni cədvəl məlumatını həm XLSX, həm də XLSB formatında saxlayaraq qiymətləndirir.
Test Mühiti
- CPU: AMD Ryzen 9 5900X (12 nüvə, 24 iplik)
- RAM: 64 GB DDR4-3600
- Storage: PCIe 4.0 NVMe SSD
- Runtime: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Əsas Performans Göstəriciləri
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Təkmilləşdirmə |
|---|---|---|---|
| Diskdə Fayl Ölçüsü | 128.4 MB | 68.2 MB | ~47% daha kiçik |
| Yadda saxlama / Serializasiya vaxtı | 42.6 s | 14.1 s | 3.0x daha sürətli |
| Oxuma vaxtı (Python DOM parser) | 38.2 s | 8.9 s | 4.3x daha sürətli |
| Oxuma Vaxtı (Rust/C Mühərriki) | 6.4 s | 1.9 s | 3.3x daha sürətli |
| Oxuma zamanı pik heap ayrılması | ~1.85 GB | ~510 MB | ~72% azalma |
Niyə XLSB Faylları Daha Kiçikdir
Hər iki format standart ZIP sıxılmasından istifadə etsə də, ikili axınlar şişirdilmiş XML mətnindən çox daha səmərəli sıxılır:
- Lazımsız sintaksis aradan qaldırılır: XML hər bir qeyd üçün təkrarlanan teqləri (
<c r=\"AA1\" s=\"1\">) ehtiva edir. ZIP sıxılması təkrarlanan sətirləri azaltsa da, sıxılmamış məlumat axını çox böyükdür. - Rəqəmsal sıxlıq: XML-də
12345678.9012sayı ASCII mətnində 14 bayt tələb edir. BIFF12-də isə bu, 8 baytlıq double kimi saxlanılır (və ya müəyyən dəqiqlik qaydalarına uyğun gəlirsə 4 baytlıqRKqeydi şəklində paketlənir).
3. Yaddaş İzini və Zibil Toplama Təzyiqi
Veb xidmətləri və mikroservislər eyni anda sorğularla işləyərkən, CPU sürəti yalnız mübarizənin yarısıdır; yaddaş izi isə tətbiqlərin həqiqətən uğursuz olduğu yerdir.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
XML parseri 100 MB ölçülü XLSX faylını işlədikdə, minlərlə müvəqqəti string tokeni, string dilim tamponu və lüğət axtarışları yaratmalıdır. Zibil toplama (garbage collection) olan dillərdə (Java, C#, Go, Node.js, Python) bu, ciddi heap fragmentasiyasına səbəb olur və icra mühitini tez-tez Zibil Toplama (GC) fasilələrinə məcbur edir.
XLSB parsinqi birbaşa sabit eni olan bayt dilimləri üzərində işlədiyi üçün parserlər məlumatı stack‑də ayrılmış strukturlara və ya təkrar istifadə edilə bilən bayt tamponlarına oxuya bilirlər. Nəticədə yaddaş izi xeyli azalır və icra vaxtı ayrıcıda heç bir thrashing baş vermir.
4. Tərtibatçı Tətbiq Nümunələri
Gəlin, ümumi inkişaf etdirici alət zəncirləri üzrə XLSB‑dən necə istifadə etmək olar, baxaq.
Python: OpenPyXL-dən Calamine / PyXLSB-ə Keçid
Standart pandas.read_excel('data.xlsx') varsayılan olaraq openpyxl‑i istifadə edir, bu da yaddaşda ağır bir ağac yaradır.
Böyük XLSB fayllarını maksimum sürətlə emal etmək üçün Rust‑əsaslı calamine mühərrikindən istifadə edin (python-calamine vasitəsilə mövcuddur və müasir Pandas‑a inteqrasiya olunmuşdur):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Əgər bütün matrisi DataFrame‑ə yükləmədən, böyük məlumat dəstlərini sətir‑sətir iterasiya edirsinizsə, pyxlsb yüngül bir axın iteratoru təqdim edir:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Yüksək Performanslı Axın İstifadəsi
.NET‑də ClosedXML və ya EPPlus kimi kitabxanalar standart yaradılış üçün əladır, lakin yaddaşın tükənməməsi üçün böyük faylları oxuyarkən, XLSB dəstəyi olan ExcelDataReader son dərəcə sürətlidir:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Memarlıq Ticarət Qurbanları: XLSB-dən Nə Zaman İstifadə Etməmək
Bütün üstün performans üstünlüklərinə baxmayaraq, XLSB hər şey üçün həll deyil. Onu bütün texnologiya yığınına tətbiq etməzdən əvvəl bir neçə əməliyyat ticarət‑nöqtəsini nəzərə almalısınız:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosistem və Kitabxana Dəstəyi
- XLSX: Ümumi. Praktik olaraq hər bir dil, kitabxana, SaaS aləti (Google Sheets, Airtable, Tableau) və veb parser OpenXML-i yerli olaraq dəstəkləyir.
- XLSB: Daha az yayılmış. Excel, LibreOffice və inkişaf etmiş proqramçı kitabxanaları (
ExcelDataReader,pyxlsb,calamine,Aspose) onu dəstəkləsə də, bir çox yüngül paketlər və ya tamamilə veb-əsaslı JavaScript parserləri (məsələn,SheetJS-in köhnə versiyaları) məhdud və ya yalnız oxumaq üçün dəstək göstərir.
2. Git və Versiya Nəzarəti Fərqləndirməsi
- XLSX: Çünki o, ZIP konteynerində mətn XML-i saxlayır, komanda sətiri alətləri və Git hook-ları ZIP-i açıb XML-i formatlaya bilər, bu da commit-lər arasındakı oxunaqlı struktur fərqlərini yaratmağa imkan verir.
- XLSB: Tamamilə ikili məlumat. Versiya nəzarət sistemləri onu tamamilə şəffaf olmayan ikili obyekt kimi qəbul edir, bu da incə diff-ləmə və ya sətr səviyyəsində birləşdirmə imkanı vermir.
3. Veb Müştəri Renderlənməsi
Əgər arxitekturanız veb brauzerdə WebAssembly və ya müştəri tərəfi JavaScript vasitəsilə cədvəllərin birbaşa renderlənməsinə əsaslanırsa, XLSX parserləri müştəri tərəfi ikili parserlərinə nisbətən əhəmiyyətli dərəcədə daha yetkin və kənar hallarda renderləmə səhvlərinə daha az meyllidir.
4. Üçüncü Tərəf İstifadə Boru Kəmərləri
Əgər xarici müəssisə müştəriləri üçün faylları ixrac edirsinizsə, bir çox sərt korporativ təhlükəsizlik siyasətləri .xlsb fayllarını işarələyir. BIFF12 faylları VBA makrolarını .xlsm faylları kimi eyni şəkildə saxlayabildiyi üçün (ayrı bir uzantı tələb etmədən), bəzi poçt filtrləri və firewall skanerları .xlsb yükləmələrini potensial makro daşıyan təhdidlər kimi karantinə alır.
6. Xülasə Müqayisəsi: Hansı Format Qalib Gəlir?
| Xüsusiyyət | XLSX | XLSB | Qalib |
|---|---|---|---|
| Oxuma / Təhlil Sürəti | Orta ilə Zəif | İnanılmaz Sürətli | XLSB |
| Yazma / Yaratma Sürəti | CPU-Intensiv | Sürətli | XLSB |
| Fayl Sıxılması | Yaxşı | Əla (~40-50% smaller) | XLSB |
| Yaddaş Ayırma | Yüksək (Ağır GC təzyiqi) | Aşağı (Birbaşa bayt oxuma) | XLSB |
| Alət Uyğunluğu | Ümumi | Yüksək, lakin seçici | XLSX |
| Təhlükəsizlik Skaninqi Çətinliyi | Minimum | Bəzən yanlış pozitivlər | XLSX |
| Makro Qabiliyyəti | Xeyr (.xlsm tələb olunur) | Bəli (Makroları yerli olaraq dəstəkləyir) | Bağlama |
7. Tərtibatçının Qərarı
Aşağıdakı hallarda XLSX istifadə edin:
- Fayllar kiçik və ya orta ölçüdədir (< 50,000 sətir).
- Fayllarınız üçüncü tərəf SaaS platformaları və ya istehlakçı tətbiqləri (məsələn, Google Sheets) tərəfindən qəbul edilməlidir.
- Faylı oxuyan son müştərinin mühitini nəzarət edə bilməzsiniz.
Aşağıdakı hallarda XLSB-yə keçin:
- Daxili boru kəmərləri, toplu işlər, ETL sistemləri və ya böyük məlumat çıxarışlarını (> 100,000 sətir) idarə edən işçi tapşırıqları yaradırsınız.
- Serverləriniz cədvəl seriyalaşdırılması və ya deserializasiyası zamanı yaddaşın kifayət etməməsi (OOM) xətaları ilə qarşılaşıb.
- Böyük təkrarlanan maliyyə modelləri və ya məlumat ixracları üçün S3/blob saxlama izlərini və şəbəkə ötürmə vaxtını minimuma endirməlisiniz.
XLSB-ə keçid adətən ixrac xidmətinizdə konfiqurasiya sətirini dəyişdirmək qədər sadədir, lakin bu, adətən kod optimizasiyası üçün həftələr tələb edən 3x‑5x arası ötürmə sürəti artımını təmin edir.
Tez-tez Soruşulan Suallar (FAQ)
**Q1: XLSB faylı, XLSX faylı ilə tam eyni sətir və sütun limitlərini dəstəkləyirmi? Bəli; həm XLSB, həm də XLSX eyni cədvəl limitini – hər iş vərəqi üçün 1 048 576 sətir və 16 384 sütun – paylaşır.
**Q2: XLSB faylı, fayl uzantısını dəyişdirmədən VBA makrolarını təhlükəsiz şəkildə saxlaya bilərmi?
Bəli, XLSX‑dən fərqli olaraq (kodun işləməsi üçün XLSM kimi saxlanmasını tələb edir), XLSB eyni .xlsb fayl formatı daxilində ikili VBA makro saxlamasını təbii olaraq dəstəkləyir.
**Q3: Hər iki format artıq ZIP ilə sıxılmış olduğu halda, faylı XLSB kimi saxlamaq onun ölçüsünü niyə azaldır? XLSB uzun mətn işarələmə etiketlərini aradan qaldırır və hüceyrə mövqelərini, qeydləri və xam ədədi dəyərləri sıx ikili bayt axınlarına kodlayır ki, bu axınlar adi XML sətirlərindən çox daha sıx sıxılır.
**Q4: Google Sheets birbaşa XLSB fayllarını idxal edib redaktə edə bilərmi?
Xeyr; Google Sheets .xlsb fayllarını yerli olaraq birbaşa aça və ya çevirə bilmir, idxal etməzdən əvvəl onları .xlsx və ya CSV formatına çevirməyinizi tələb edir.
**Q5: XLSB faylları XLSX fayllarına nisbətən məlumat korlanmasına daha çox meyllidirmi? XML faylları qismən korlandıqda bəzən mətn redaktoru ilə əl ilə yoxlanıb təmir oluna bilsə də, ikili BIFF12 axınları dəqiq bayt ofsetləri tələb edir və struktur sektorları zədələnərsə əl ilə bərpa etmək çətindir.