Последно актуализирано: 20 авг., 2026
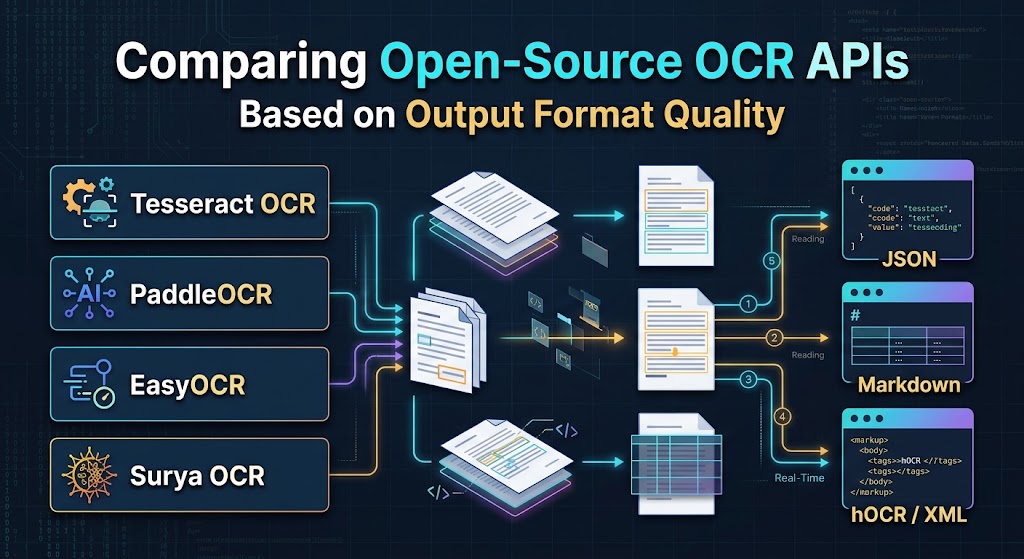
Сравняване на Open-Source OCR API‑та според качеството на изходния формат
Когато инженерите оценяват OCR (Оптично разпознаване на знаци) двигатели, обикновено доминират показателите за процент на грешка в знаците (CER) и процент на грешка в думите (WER). Въпреки че точността на разпознаването е от съществено значение, тя решава само половината от проблема в продукцията.
Ако обработвате сложни многоколоночни PDF файлове, извличате редове от разписки или вкарвате бели книги в LLM вграждане, суровите текстови изходи създават огромно инженерно натоварване. Низ от знаци без осъзнаване на оформлението, логичен ред за четене или координатни данни принуждава вашия екип да пише крехки хевристични парсери.
Истинският диференциатор за съвременните документооборотни процеси е качеството на изходния формат: колко последователно и чисто един двигател предоставя координати, ред за четене, структурна йерархия и таблични данни.
По-долу е сравнение, ориентирано към инженерството, на четири водещи отворен код OCR двигателя—Tesseract, PaddleOCR, EasyOCR, и Surya OCR—оценяващо как техните изходи се държат в автоматизирани конвейери.
Общите изходни формати: Какво наистина се нуждаят инженерите
Всеки OCR API пакетира открития текст по различен начин. Разбирането на тези формати помага да се определи колко следобработване изисква вашият конвейер:
- Plain Text (
.txt): Най-опростеното представяне. Премахва цялата позиционна метаданна и свива многоколоночните оформления в хоризонтално четене, което може да разбърка абзаците. - Archival Standards (
hOCR,ALTO XML): XML/HTML-базирани формати, стандартни в библиотечното архивиране. Те вграждат координати, оценки на шрифта и нива на доверие в DOM възлите. Изключително стабилни за възстановяване на документи, но обемисти за микросервизи. - Structured JSON: По подразбиране избор за съвременни уеб бекендове. Предоставя масиви с координати (граници в кутии или полигони), нива на доверие и йерархични структури блок/ред/дума.
- Markdown (
.md) / HTML Tables: Съвременният стандарт за Retrieval-Augmented Generation (RAG). Запазва семантичните секции (заглавия, списъци, удебелен текст) и табличните матрици без нужда от последващо пространствено възстановяване.
1. Tesseract OCR
Поддържан от Google, Tesseract остава основният двигател на отворения код за OCR. Архитектурата му се опира силно на традиционни алгоритми за сегментация на страници, допълнени от LSTM-базиран характерен двигател.
Нативни формати за изход
- Основни изходи: Обикновен текст, hOCR (HTML), ALTO XML, TSV (стойности, разделени с табулация) и търсим PDF/A.
- Осъзнаване на оформлението: Хевристики, базирани на правила, чрез режими за сегментация на страници (PSM).
Анализ на формати за изход
- Къде се отличава: Експортите
TSVиhOCRна Tesseract са стандартизирани и предвидими. Един единствен TSV експорт връща структурираните колони заlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightиconf. Ако конвертирате хартиени архиви в търсим PDF файлове или се нуждаете от стриктно спазване на институционалните стандарти, Tesseract се справя с това нативно без персонализиран код за свързване. - Къде е слаб: Tesseract няма вграден JSON API. Използването на неговия изход в Python или Node.js изисква парсиране на XML/TSV файлове или използване на обвивки като
pytesseract. Неговият двигател за оформление също се затруднява с нестандартен колонен поток, често смесвайки текста от съседни колони, освен ако не се предоставят ръчно зададени ограничителни изрязвания.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Подкрепен от рамката PaddlePaddle на Baidu, PaddleOCR е спечелил широко приемане благодарение на леките си модели, обширната поддръжка на множество езици и специализирания набор от инструменти за анализ на документи (PP-Structure).
Нативни формати за изход
- Основни изходи: Python списъци/речници, суров JSON, визуализационни наслагвания и структуриран HTML чрез PP-Structure.
- Осъзнаване на оформление: Високо (използвайки модели за дълбоко обучение за парсиране на оформление, класификация на ориентация и възстановяване на таблици).
Анализ на формати за изход
- Къде се отличава: Стандартният PaddleOCR връща 4‑точкови координати на полигон (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) заедно с текстови низове и оценки за увереност. Това обработва наклонен или извит текст плавно. Въпреки това, истинската му сила се крие в пакета PP-Structure, който открива региони на оформление (заглавие, текст, таблица, фигура) и парсира таблици директно в валидни HTML низове (<table>...</table>). Това премахва нуждата от ръчно изчисляване на обхвати на клетки от ограничителни кутии. - Къде е слаб: Базовият API връща вложени масиви, които нямат стандартни ключове за свойства в различните версии. За структурирани приложения разработчиците обикновено пишат междинен адаптер за стандартизиране на имената на полетата (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Изграден върху PyTorch от JaidedAI, EasyOCR е създаден за бързо приемане от разработчиците. Той пакетира CRAFT (Character Region Awareness for Text Detection) с мрежи за разпознаване, базирани на дълбоко обучение, в минимален API.
Нативни формати за изход
- Основни изходи: Python списъци, съдържащи кортежи от координати, разпознати низове и стойности на увереност.
- Осъзнаване на оформлението: Ниско до умерено (само откриване на редове от текст; без структурен парсинг на ниво документ).
Анализ на формати за изход
- Къде се отличава: Простотата на върнатия обект е несравнима:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Съпоставянето на този изход със стандартен REST отговор или сериализирането му директно в GeoJSON/персонализирани схеми изисква само няколко реда код. Той работи надеждно върху текст в естествени сцени, регистрационни номера и отделени откъси от документи.
- Къде се проваля: EasyOCR не извършва цялостен анализ на оформлението на документа. Той не идентифицира таблици, йерархии на заглавия или ред на четене в сложни колони. Използването на EasyOCR върху двуколонен академичен документ често генерира преплетени текстови откъси, освен ако не се комбинира с предходен модел за откриване на оформлението (като YOLO или LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya е съвременна OCR рамка, базирана на дълбоко обучение, проектирана специално за разбиране на сложни документи и LLM ingest pipelines.
Вродени формати за изход
- Основни изходи: JSON структури моделирани с Pydantic, индекси на логически ред на четене, области за ограничаване на оформлението и полигони за откриване на редове.
- Осъзнаване на оформлението: Изключително високо (анализ на оформлението, базиран на дълбоко обучение, и сортиране на реда на четене).
Анализ на формата за изход
- Къде превъзхожда: Surya директно се справя с предизвикателствата на съвременното AI инженерство. Вместо да приема, че документите се четат отгоре надолу, отляво надясно, Surya използва специализиран модел за предсказване на реда на четене. Той групира редовете в логически семантични блокове, естествено обработва многоколоночни обхвати и издава типизирани структури чрез Pydantic. Това прави последващото въвеждане във векторни бази данни и конвертори към Markdown директно и надеждно.
- Къде има недостатъци: Като по-нова и по-тежка рамка, базирана на PyTorch, Surya изисква специализирана GPU изчислителна мощ, за да съответства на пропускателната способност на оптимизирани C++ двигатели като Tesseract или квантизираните модели Paddle. Тя не се насочва към наследени архивни стандарти като hOCR или ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Матрица за сравнение лице в лице
| Възможности / Формат | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Нативен hOCR / ALTO XML | Нативна поддръжка | Само от трети страни | Няма | Няма |
| Геометрия на ограничителната кутия | Ориентиран по оси (x, y, w, h) | Полигон с 4 точки | Полигон с 4 точки | Полигон + блокове за оформление |
| Парсиране на таблици | Само координатен TSV | HTML низове за таблици | Няма | Координатни мрежи на клетки |
| Откриване на реда на четене | Базирано на правила (прекъсва при многоколонен) | ML анализ на оформление | Основно групиране на редове | Посветен модел за реда на четене |
| Прями JSON схеми | Изисква преобразуване | Python Dict / JSON | Python List / JSON | Типизирани Pydantic модели |
| Идеална цел за последваща обработка | Архивни PDF‑файлове, наследени DMS | Данни за формуляри/разписки, ERP системи | Бързи скриптове, Текст от сцена | Въвеждане в LLM, RAG архитектури |
Препоръки за конвейер: Кой да изберете?
- Изберете Tesseract ако вашите изисквания за съответствие изискват стандартизирани
hOCR,ALTO XMLили търсими PDF/A доставяеми продукти за правителствени или архивни записи. - Изберете PaddleOCR ако обработвате оперативни финансови документи (фактури, разписки, данъчни формуляри), съдържащи сложни, безрамкови таблици, които трябва да се конвертират в HTML или електронни таблици.
- Изберете EasyOCR ако ви е нужна лека, Python-ска библиотека за откриване и извличане на текст от естествени изображения, улични знаци или изрязани UI елементи без конфигурационни затруднения.
- Изберете Surya OCR ако подавате неструктурирани бизнес отчети, научни статии и технически ръководства към LLM или векторен търсач, където логичният ред на четене и чистите структурни граници са от съществено значение.
Често задавани въпроси (FAQ)
1. Кой отворен формат за изход на OCR е най-лесен за подаване към големи езикови модели?
JSON‑тата, осъзнаващи реда на четене на Surya OCR, и HTML таблиците на PaddleOCR PP-Structure предоставят най-чистите представяния за контексти на LLM подсказки и RAG индексиране.
2. Може ли Tesseract да генерира JSON отговори нативно без външни инструменти?
Не, Tesseract нативно извежда текст, TSV, PDF и hOCR/ALTO XML; създаването на JSON изисква конвертиране на неговия TSV или hOCR изход чрез междинен парсер.
3. Как се различават координатите на 4‑точков полигон от осово подравнените ограничителни кутии?
Кутии, ориентирани по осите, използват [x, y, width, height], като предполагат плосък текст, докато 4‑точковите полигони предоставят четири двойки координати за точно обхващане на завъртени, наклонени или извити редове текст.
4. Кой двигател изходи таблици директно в код, вместо в свободни координати?
Модулът PP-Structure на PaddleOCR реконструира откритите граници на таблиците в пълни HTML тагове за таблици (<table>, <tr>, <td>), избягвайки персонализирана пространствена математика.
5. Защо стандартният изход на EasyOCR се затруднява с многоколоночни научни статии?
EasyOCR идентифицира редовете от текст въз основа на локална близост, а не на глобална йерархия на оформлението, което кара текстът от съседни колони да се преплитат, освен ако не бъде ограничен от външен двигател за оформление.