Последно актуализирано: 30 септември, 2026
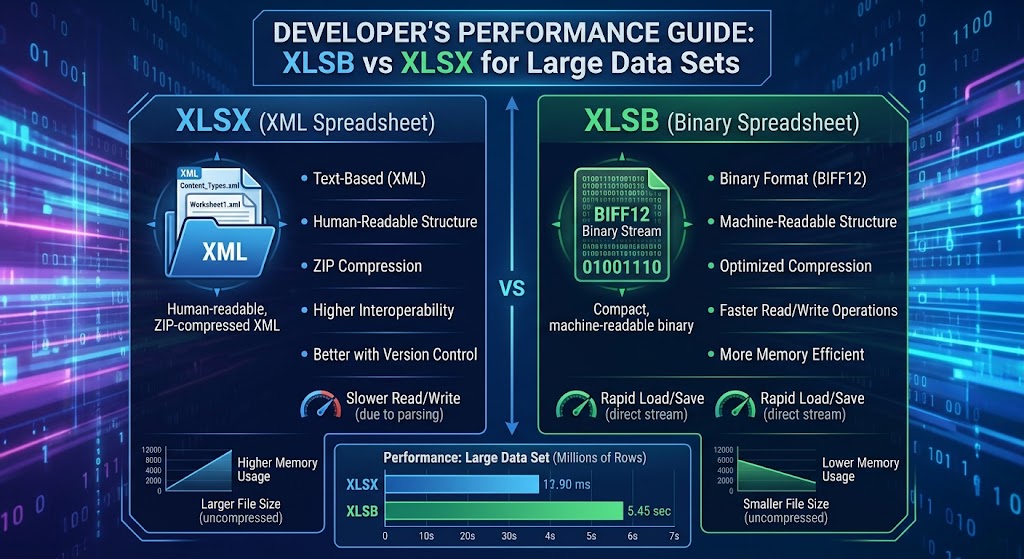
XLSB срещу XLSX за големи набори от данни: Ръководство за производителност за разработчици
Ако създавате данни потоци, бекенд системи за отчитане или аналитични инструменти, които взаимодействат с Microsoft Excel, вероятно сте се сблъскали с "стената".
Потребител качва работна книга с 450 000 реда. Сървърът ви стартира работни нишки, потреблението на памет се изстрелва до гигабайти, събирането на боклук замразява изпълнението, и вашата операция изтича. Преглеждате полезния товар: това е стандартен файл .xlsx.
За да решат това, разработчиците често прекарват дни в имплементиране на парчиране, поточни парсери или прехвърляне на файлове към фонови работници. Въпреки това, една от най-ефективните оптимизации изисква нулево архитектурно преустройство: промяна на разширението на файла от .xlsx на .xlsb.
В това ръководство се задълбочаваме в сърцевината на двата формата, изследваме защо техните вътрешни архитектури създават радикално различни характеристики на производителността, сравняваме конкретни бенчмаркове за Python и .NET и очертаваме ясни правила кога да внедряваме бинарни работни книги в продукция.
1. Под капака: OpenXML срещу BIFF12
За да разберем защо производителността се различава толкова драматично при големи набори от данни, трябва да разгледаме как всеки формат съхранява записите на диска.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
И двата файла .xlsx и .xlsb са компресирани ZIP контейнери, съответстващи на Open Packaging Conventions (OPC). Ако преименувате който и да е файл на .zip и го разархивирате, ще видите позната структура на директориите: _rels, docProps и xl/worksheets/.
Критичната разлика се крие в папката xl/worksheets/:
- XLSX съхранява листовете като прост XML текст (
sheet1.xml). - XLSB съхранява листовете като собственически бинарни потоци (
sheet1.bin), кодирани с BIFF12 (Binary Interchange File Format 12) на Microsoft.
Как XLSX кодира данни (XML DOM натоварване)
В XLSX работен лист всяка клетка е декларирана с явни XML тагове:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
При четене на този ред вашата среда за изпълнение трябва:
- Декомпресирайте суровия deflate поток в текст.
- Токенизирайте и парсирайте символите на низа в XML DOM или SAX поток от събития.
- Провери отварящите и затварящите тагове (
<c>,</c>,<v>,</v>). - Разреши търсене на низове от отделна таблица
sharedStrings.xml. - Парсирайте ASCII текста
"98234.55"в 64-битов плаващ десетичен номер по IEEE 754.
Всяка отделна клетка налага натоварване на процесора за парсиране на низове, разпределяне на низове и лексикален анализ. Умножете това по 500 000 реда и 30 колони (15 млн клетки), и процесорът прекарва далеч повече цикли в парсиране на синтаксис, отколкото в обработка на стойностите на домейна.
Как XLSB кодира данни (BIFF12 двоичен поток)
BIFF12 изцяло премахва сериализацията на текст. Вместо маркиране на низове, данните се подреждат като последователна поредица от бинарни записи с променлива дължина:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Клетка с плаваща запетая в BIFF12 не използва текстови представяния като "98234.55". Тя се представя директно:
- 2 байта за идентификатора на записа (например
BrtCellRkилиBrtCellReal) - 4 байта за индекси на колони/редове
- 8 байта, съдържащи суровата, IEEE 754 двойна точностна байтова структура
Когато вашият парсер чете XLSB файл, той изцяло заобикаля лексическия парсинг. Той чете заглавието на записа, взема 8-те сурови байта от буфера, копира ги директно в паметта и премества указателя напред. Няма етикети за валидиране, няма преобразувания от низ към число и няма никакво натоварване за декодиране на UTF-8 за числови данни.
2. Количествени измервания: Диск, Памет и Пропускателна способност
За да илюстрираме реалното въздействие, разгледайте симулиран набор от данни, съдържащ 750,000 реда и 25 колони (смес от времеви отметки, числа с плаваща запетая, цели числа и кодове на категории).
Тестовете по-долу оценяват идентични таблични данни, запазени както в XLSX, така и в XLSB.
Тестова среда
- CPU: AMD Ryzen 9 5900X (12 ядра, 24 нишки)
- RAM: 64 GB DDR4-3600
- Съхранение: PCIe 4.0 NVMe SSD
- Време за изпълнение: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Ключови показатели за изпълнение
| Метрика | XLSX (OpenXML) | XLSB (BIFF12) | Делта / Подобрение |
|---|---|---|---|
| Размер на файла на диска | 128.4 MB | 68.2 MB | ~47% по-малко |
| Време за запазване / сериализация | 42.6 s | 14.1 s | 3.0x по-бързо |
| Време за четене (Python DOM parser) | 38.2 s | 8.9 s | 4.3x по-бързо |
| Време за четене (Rust/C Engine) | 6.4 с | 1.9 с | 3.3 пъти по-бързо |
| Пиково заделяне на купа по време на четене | ~1.85 GB | ~510 MB | ~72% намаление |
Защо XLSB файловете са по-малки
Докато и двата формата използват стандартно ZIP компресиране, бинарните потоци се компресират много по-ефективно от разтегления XML текст:
- Излишният синтаксис е премахнат: XML съдържа повторяеми тагове (
<c r=\"AA1\" s=\"1\">) във всеки запис. Докато ZIP компресията намалява повторените низове, некондензираният поток от данни е огромен. - Числова плътност: В XML числото
12345678.9012изисква 14 байта ASCII текст. В BIFF12 то се съхранява като 8‑байтов double (или опаковано в 4‑байтовRKзапис, ако отговаря на специфичните правила за точност).
3. Паметен отпечатък и натиск върху събирането на боклука
За уеб услуги и микросервизи, обработващи едновременни заявки, скоростта на процесора е само половината от битката; паметната консумация е мястото, където приложенията всъщност се провалят.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Когато XML парсер обработва 100 MB XLSX файл, той трябва да създаде хиляди преходни токени за низове, буфери за части от низове и справки в речници. В езици с управление на паметта чрез събиране на боклук (Java, C#, Go, Node.js, Python) това създава изключително фрагментиране на купчината и принуждава изпълнителната среда към чести паузи за събиране на боклук (GC).
Тъй като парсирането на XLSB работи директно върху фиксирани по ширина байтови срезове, парсерите могат да четат данните в структури, разположени в стека, или в многократно използваеми байтови буфери. Резултатът е значително намален паметен отпечатък и нулево претоварване на алокатора по време на изпълнение.
4. Примери за имплементация от разработчици
Нека разгледаме как да използваме XLSB в общите инструменти за разработчици.
Python: Преминаване от OpenPyXL към Calamine / PyXLSB
Стандартният pandas.read_excel('data.xlsx') по подразбиране използва openpyxl, който създава тежко дърво в паметта.
За обработка на големи XLSB файлове с максимална скорост, използвайте двигателя calamine, захранван от Rust (достъпен чрез python-calamine и интегриран в съвременния Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Ако обхождате масивни набори от данни ред по ред, без да зареждате цялата матрица в DataFrame, pyxlsb предоставя лек итератор за поточно четене:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Високопроизводително поточно приемане
В .NET библиотеките като ClosedXML или EPPlus са отлични за стандартно генериране, но за вмъкване на големи файлове без изчерпване на паметта, ExcelDataReader с поддръжка на XLSB е изключително бърз:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Архитектурни компромиси: Кога НЕ да се използва XLSB
Въпреки изключителните си предимства по отношение на производителността, XLSB не е чудодейно решение. Трябва да претеглите няколко оперативни компромиса, преди да го наложите в цялата си инфраструктура:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Екосистема и поддръжка на библиотеки
- XLSX: Универсален. Практически всеки език, библиотека, SaaS инструмент (Google Sheets, Airtable, Tableau) и уеб парсер поддържат OpenXML нативно.
- XLSB: По-малко разпространен. Докато Excel, LibreOffice и зрели библиотеките за разработчици (
ExcelDataReader,pyxlsb,calamine,Aspose) го поддържат, много леки пакети или чисто уеб-базирани JavaScript парсери (като по-старите версии наSheetJS) имат ограничена или само за четене поддръжка.
2. Git и сравняване в системата за контрол на версии
- XLSX: Тъй като съдържа текстов XML вътре в ZIP контейнер, командните инструменти и Git hook-овете могат да разархивират и форматират XML, за да генерират четими структурни разлики между комитите.
- XLSB: Чисто бинарни данни. Системите за контрол на версиите го третират стриктно като непрозрачен бинарен обект, премахвайки всяка възможност за детайлно сравнение или сливане на ниво редове.
3. Рендериране в уеб клиент
Ако вашата архитектура разчита на рендиране на електронни таблици директно в браузъра чрез WebAssembly или клиентски JavaScript, XLSX парсерите са значително по-зрели и по-малко податливи на бъгове при рендиране в краен случай в сравнение с клиентските бинарни парсери.
4. Външни конвейери за приемане
Ако експортирате файлове за външни корпоративни клиенти, много строги корпоративни политики за сигурност маркират файловете .xlsb. Тъй като BIFF12 файловете могат да съхраняват VBA макроси идентично като .xlsm файловете (без да се изисква отделно разширение), някои филтри за електронна поща и скенери на защитни стени поставят .xlsb качванията под карантина като потенциални заплахи, съдържащи макроси.
6. Обобщено сравнение: Кой формат печели?
| Функция | XLSX | XLSB | Победител |
|---|---|---|---|
| Скорост на четене / парсиране | Умерена до лоша | Мълниеносна | XLSB |
| Скорост на запис / генериране | Интензивен за процесора | Бързо | XLSB |
| Компресиране на файлове | Добре | Отлично (~40-50% по-малко) | XLSB |
| Разпределяне на паметта | Високо (силно натоварване на GC) | Ниско (директно четене на байтове) | XLSB |
| Интероперативност на инструментите | Универсална | Високо, но селективно | XLSX |
| Трудност при сканиране за сигурност | Минимално | Периодични фалшиви положителни | XLSX |
| Възможност за макроси | Не (.xlsm задължително) | Да (Поддържа макроси нативно) | Връзка |
7. Вердиктът на разработчика
Използвайте XLSX, когато:
- Файловете са с малък до умерен размер (< 50,000 реда).
- Вашите файлове трябва да бъдат обработени от трети SaaS платформи или потребителски приложения (например Google Sheets).
- Не можете да контролирате средата на крайния клиент, който чете файла.
Превключете към XLSB, когато:
- Създавате вътрешни конвейери, партидни задачи, ETL системи или работни задачи, които обработват масивни извлечения на данни (> 100,000 реда).
- Вашите сървъри получават грешки за недостиг на памет (OOM) по време на сериализация или десериализация на електронни таблици.
- Трябва да минимизирате отпечатъците на съхранение в S3/blob и времето за мрежов трансфер за големи периодични финансови модели или експорти на данни.
Преминаването към XLSB често е толкова просто, колкото промяна на низ за конфигурация във вашата услуга за експортиране, но то осигурява подобрения в пропускателната способност от 3х до 5х, които обикновено изискват седмици оптимизация на кода.
Често задавани въпроси (FAQ)
**Q1: Поддържа ли файл XLSB точно същите ограничения за редове и колони като файл XLSX? Да; както XLSB, така и XLSX споделят точно същия максимум на мрежата от 1 048 576 реда по 16 384 колони на работен лист.
**Q2: Може ли файл XLSB безопасно да съхранява VBA макроси без да променя разширението на файла?
Да, за разлика от XLSX (който изисква запазване като XLSM за изпълнение на код), XLSB поддържа нативно съхранение на бинарни VBA макроси в същия формат .xlsb.
**Q3: Защо запазването на файл като XLSB намалява неговия размер, ако и двата формата вече са компресирани с ZIP? XLSB премахва обширните текстови маркери и кодира позициите на клетките, записите и суровите числови стойности в плътни бинарни байтови потоци, които се компресират значително по-гъсто от обикновените XML низове.
**Q4: Може ли Google Sheets да импортира и редактира XLSB файлове директно?
Не; Google Sheets не може нативно да отваря или конвертира .xlsb файлове директно, като изисква да ги конвертирате в .xlsx или CSV преди импортиране.
**Q5: Дали XLSB файловете са по-склонни към повреда на данните в сравнение с XLSX файловете? Докато XML файловете понякога могат да бъдат ръчно преглеждани или поправяни с текстов редактор при частична корупция, бинарните потоци BIFF12 изискват стриктни байтови отмествания и е трудно да се възстановят ръчно, ако структурните сектори са повредени.
Вижте още
- CSV срещу XLSX срещу ODS през 2026 г.: Най-добрият формат за електронни таблици за разработчици
- XLS срещу XLSX срещу XLSM срещу XLSB - Избор на правилния формат за електронни таблици
- Какво е Excel? Ключова информация, която трябва да знаете
- Файлови формати на Excel: XLSX, XLSM, XLS, XLTX, XLTM
- Разлика между XLS и XLSX