সর্বশেষ আপডেট: 20 Aug, 2026
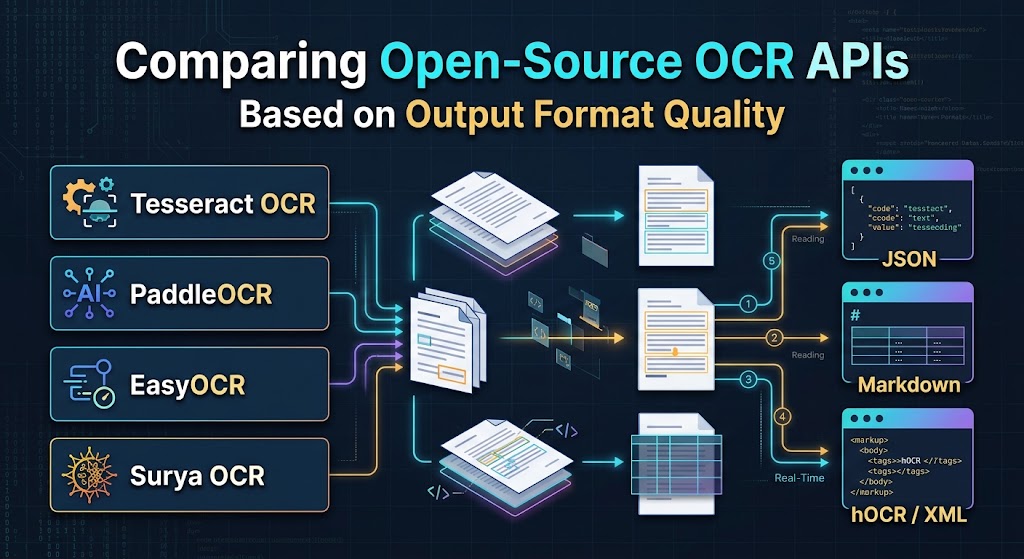
আউটপুট ফরম্যাটের গুণমানের ভিত্তিতে ওপেন-সোর্স OCR API তুলনা
যখন প্রকৌশলীরা অপটিক্যাল ক্যারেক্টার রিকগনিশন (OCR) ইঞ্জিন মূল্যায়ন করে, ক্যারেক্টার ত্রুটি হার (CER) এবং শব্দ ত্রুটি হার (WER) সাধারণত বেঞ্চমার্কগুলোকে প্রাধান্য দেয়। স্বীকৃতির নির্ভুলতা গুরুত্বপূর্ণ হলেও, এটি উৎপাদনে সমস্যার কেবল অর্ধেকই সমাধান করে।
যদি আপনি জটিল বহু-কলাম PDF পার্স করছেন, রসিদ থেকে লাইন আইটেম বের করছেন, অথবা হোয়াইটপেপারকে একটি LLM এমবেডিং পাইপলাইনে ইনজেস্ট করছেন, কাঁচা টেক্সট ডাম্পগুলো বিশাল ইঞ্জিনিয়ারিং ওভারহেড তৈরি করে। লেআউট সচেতনতা, যৌক্তিক রিডিং অর্ডার, অথবা কোঅর্ডিনেট ডেটা ছাড়া অক্ষরের একটি স্ট্রিং আপনার দলকে ভঙ্গুর হিউরিস্টিক পার্সার লিখতে বাধ্য করে।
আধুনিক ডকুমেন্ট ওয়ার্কফ্লোর প্রকৃত পার্থক্যকারী হল আউটপুট ফরম্যাটের গুণমান: একটি ইঞ্জিন কতটা ধারাবাহিক ও পরিষ্কারভাবে কোঅর্ডিনেট, রিডিং অর্ডার, কাঠামোগত হায়ারার্কি এবং ট্যাবুলার ডেটা সরবরাহ করে।
নিচে চারটি শীর্ষস্থানীয় open-source OCR ইঞ্জিনের—Tesseract, PaddleOCR, EasyOCR, এবং Surya OCR—ইঞ্জিনিয়ারিং-কেন্দ্রিক তুলনা দেওয়া হয়েছে, যা স্বয়ংক্রিয় পাইপলাইনের মধ্যে তাদের আউটপুট কীভাবে কাজ করে তা মূল্যায়ন করে।
সাধারণ আউটপুট ফরম্যাটগুলো: ইঞ্জিনিয়াররা আসলে কী প্রয়োজন
প্রতিটি OCR API সনাক্ত করা টেক্সট ভিন্নভাবে প্যাকেজ করে। এই ফরম্যাটগুলো বোঝা আপনার পাইপলাইনের কতটুকু পোস্ট-প্রসেসিং প্রয়োজন তা নির্ধারণে সাহায্য করে:
- সাধারণ টেক্সট (
.txt): সবচেয়ে সহজ উপস্থাপন। এটি সব অবস্থানগত মেটাডেটা সরিয়ে দেয় এবং বহু-কলাম লেআউটকে অনুভূমিক পাঠে সংকুচিত করে, যা অনুচ্ছেদগুলোকে গুলিয়ে দিতে পারে। - সংরক্ষণ মানদণ্ড (
hOCR,ALTO XML): লাইব্রেরি আর্কাইভিং-এ মানক XML/HTML-ভিত্তিক ফরম্যাট। এগুলো কোঅর্ডিনেট, ফন্ট অনুমান এবং কনফিডেন্স রেটিং DOM নোডের মধ্যে এমবেড করে। ডকুমেন্ট পুনর্গঠনের জন্য অত্যন্ত শক্তিশালী, তবে মাইক্রোসার্ভিসের জন্য ভারী। - গঠনযুক্ত JSON: আধুনিক ওয়েব ব্যাকএন্ডের জন্য ডিফল্ট পছন্দ। এটি কোঅর্ডিনেট অ্যারে (বাউন্ডিং বক্স বা পলিগন), কনফিডেন্স রেটিং এবং হায়ারার্কিক্যাল ব্লক/লাইন/শব্দ গঠন সরবরাহ করে।
- মার্কডাউন (
.md) / HTML টেবিল: রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG)-এর আধুনিক মানদণ্ড। সেমান্টিক সেকশন (হেডার, তালিকা, বোল্ড টেক্সট) এবং ট্যাবুলার ম্যাট্রিক্স সংরক্ষণ করে, ডাউনস্ট্রিম স্পেশিয়াল রিকনস্ট্রাকশন প্রয়োজন না করে।
১. Tesseract OCR
গুগল দ্বারা রক্ষণাবেক্ষিত, টেসার্যাক্ট ওপেন-সোর্স OCR-এর ভিত্তিগত কাজের ঘোড়া হিসেবে রয়ে গেছে। এর আর্কিটেকচার প্রচলিত পেজ সেগমেন্টেশন অ্যালগরিদমের উপর ব্যাপকভাবে নির্ভরশীল, যা একটি LSTM-ভিত্তিক ক্যারেক্টার ইঞ্জিন দ্বারা সম্পূরক।
নেটিভ আউটপুট ফরম্যাটগুলি
- প্রাথমিক আউটপুট: সাধারণ টেক্সট, hOCR (HTML), ALTO XML, TSV (Tab-Separated Values), এবং অনুসন্ধানযোগ্য PDF/A।
- লেআউট সচেতনতা: নিয়ম-ভিত্তিক হিউরিস্টিক্স পেজ সেগমেন্টেশন মোড (PSM) এর মাধ্যমে।
আউটপুট ফরম্যাট বিশ্লেষণ
- যেখানে এটি উৎকৃষ্ট: Tesseract-এর
TSVএবংhOCRএক্সপোর্টগুলি মানক এবং পূর্বানুমানযোগ্য। একটি একক TSV এক্সপোর্টlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,height, এবংconfএর জন্য কাঠামোগত কলাম প্রদান করে। যদি আপনি কাগজের আর্কাইভকে অনুসন্ধানযোগ্য PDF-এ রূপান্তর করছেন বা প্রতিষ্ঠানের মানদণ্ডের কঠোর অনুসরণ প্রয়োজন হয়, Tesseract কাস্টম গ্লু কোড ছাড়াই স্বাভাবিকভাবে এটি পরিচালনা করে। - যেখানে এটি কমতি দেখায়: Tesseract-এ নেটিভ JSON API নেই। এর আউটপুটকে Python বা Node.js-এ ব্যবহার করতে XML/TSV ফাইল পার্স করা বা
pytesseractএর মতো র্যাপার ব্যবহার করা প্রয়োজন। এর লেআউট ইঞ্জিনও অ-মানক কলাম ফ্লোতে সমস্যায় পড়ে, প্রায়শই পার্শ্ববর্তী কলাম থেকে টেক্সট মিশ্রিত করে যদি ম্যানুয়াল বাউন্ডিং ক্রপ সরবরাহ না করা হয়।
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
২. PaddleOCR
Baidu-এর PaddlePaddle ফ্রেমওয়ার্ক দ্বারা সমর্থিত, PaddleOCR তার হালকা মডেল, বিস্তৃত বহু-ভাষা কভারেজ, এবং নিবেদিত ডকুমেন্ট বিশ্লেষণ টুলকিট (PP-Structure) এর কারণে ব্যাপক গ্রহণযোগ্যতা অর্জন করেছে।
নেটিভ আউটপুট ফরম্যাটগুলি
- প্রাথমিক আউটপুটস: Python lists/dictionaries, raw JSON, visualization overlays, and structured HTML via PP-Structure.
- লেআউট সচেতনতা: High (using deep learning models for layout parsing, orientation classification, and table recovery).
আউটপুট ফরম্যাট বিশ্লেষণ
- যেখানে এটি উৎকৃষ্ট: Standard PaddleOCR returns 4-point polygon coordinates (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) alongside text strings and confidence scores. This handles skewed or curved text gracefully. However, its real strength lies in the PP-Structure suite, which detects layout regions (title, text, table, figure) and parses tables directly into valid HTML strings (<table>...</table>). This eliminates the need to manually compute cell spans from bounding boxes. - যেখানে এটি কমতি দেখায়: The base API returns nested arrays that lack standard property keys across different versions. For structured applications, developers usually write an intermediate adapter to standardize field names (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
৩. EasyOCR
JaivenAI দ্বারা PyTorch-এ নির্মিত, EasyOCR দ্রুত ডেভেলপার গ্রহণের জন্য তৈরি করা হয়েছে। এটি CRAFT (Character Region Awareness for Text Detection) কে ডিপ লার্নিং রিকগনিশন নেটওয়ার্কের সাথে প্যাকেজ করে একটি ন্যূনতম API-তে।
নেটিভ আউটপুট ফরম্যাটগুলি
- প্রাথমিক আউটপুটস: কোঅর্ডিনেটের টাপল, স্বীকৃত স্ট্রিং এবং আত্মবিশ্বাসের মান সম্বলিত পাইথন লিস্ট।
- লেআউট সচেতনতা: নিম্ন থেকে মাঝারি (শুধুমাত্র টেক্সট-লাইন সনাক্তকরণ; ডকুমেন্ট-স্তরের কাঠামোগত পার্সিং নেই)।
আউটপুট ফরম্যাট বিশ্লেষণ
- যেখানে এটি উৎকৃষ্ট: রিটার্ন অবজেক্টের সরলতা অতুলনীয়:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
এই আউটপুটকে একটি স্ট্যান্ডার্ড REST রেসপন্সে ম্যাপ করা বা সরাসরি GeoJSON/কাস্টম স্কিমাতে সিরিয়ালাইজ করা মাত্র কয়েক লাইনের কোডে সম্ভব। এটি প্রাকৃতিক দৃশ্যের টেক্সট, লাইসেন্স প্লেট এবং বিচ্ছিন্ন ডকুমেন্ট ক্রপে নির্ভরযোগ্যভাবে কাজ করে।
- যেখানে এটি কমপে: EasyOCR সমগ্র ডকুমেন্ট লেআউট বিশ্লেষণ করে না। এটি টেবিল, শিরোনাম হায়ারার্কি বা জটিল কলামের মধ্যে রিডিং অর্ডার সনাক্ত করে না। দুই-কলাম একাডেমিক পেপারে EasyOCR ব্যবহার করলে প্রায়শই টেক্সটের টুকরো টুকরো মিশে যায়, যদি না এটি আপস্ট্রিম লেআউট ডিটেকশন মডেল (যেমন YOLO বা LayoutLM) এর সাথে জোড়া হয়।
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
৪. সূর্য OCR
Surya একটি আধুনিক ডিপ-লার্নিং OCR ফ্রেমওয়ার্ক, যা বিশেষভাবে জটিল ডকুমেন্ট বোঝা এবং LLM ইনজেস্ট পাইপলাইনগুলির জন্য ডিজাইন করা হয়েছে।
স্থানীয় আউটপুট ফরম্যাটগুলি
- প্রাথমিক আউটপুটস: Pydantic-মডেলড JSON স্ট্রাকচার, লজিক্যাল রিডিং অর্ডার ইনডেক্স, লেআউট বাউন্ডিং রিজিয়ন, এবং লাইন ডিটেকশন পলিগন।
- Layout Awareness: অত্যন্ত উচ্চ (ডিপ-লার্নিং-ভিত্তিক লেআউট বিশ্লেষণ এবং রিডিং অর্ডার সোর্টিং)।
আউটপুট ফরম্যাট বিশ্লেষণ
- Where It Excels: Surya সরাসরি আধুনিক AI ইঞ্জিনিয়ারিংয়ের চ্যালেঞ্জগুলিকে সমাধান করে। ডকুমেন্টগুলোকে উপরে-থেকে-নিচে, বাম-থেকে-ডানে পড়া হবে বলে অনুমান করার পরিবর্তে, Surya একটি নিবেদিত মডেল ব্যবহার করে reading order পূর্বাভাস দেয়। এটি লাইনগুলোকে যৌক্তিক সেম্যান্টিক ব্লকে গোষ্ঠীভুক্ত করে, বহু-কলাম স্প্যান স্বাভাবিকভাবে হ্যান্ডেল করে, এবং Pydantic এর মাধ্যমে টাইপড স্ট্রাকচার আউটপুট করে। এটি ভেক্টর ডাটাবেস এবং Markdown কনভার্টারগুলিতে ডাউনস্ট্রিম ইনজেশনকে সরাসরি এবং নির্ভরযোগ্য করে তোলে।
- Where It Falls Short: একটি নতুন, ভারী PyTorch-ভিত্তিক ফ্রেমওয়ার্ক হিসেবে, Surya-কে অপ্টিমাইজড C++ ইঞ্জিন যেমন Tesseract বা কোয়ান্টাইজড Paddle মডেলের থ্রুপুটের সঙ্গে মেলাতে নিবেদিত GPU কম্পিউট দরকার। এটি hOCR বা ALTO এর মতো লিগেসি আর্কাইভাল স্ট্যান্ডার্ডকে লক্ষ্য করে না।
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
হেড-টু-হেড তুলনা ম্যাট্রিক্স
| ক্ষমতা / ফরম্যাট | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| নেটিভ hOCR / ALTO XML | নেটিভ সমর্থন | শুধুমাত্র তৃতীয় পক্ষের | কোনোটি না | কোনোটি না |
| বাউন্ডিং বক্স জ্যামিতি | অক্ষ-সামঞ্জস্যিত (x, y, w, h) | ৪-পয়েন্ট বহুভুজ | ৪-পয়েন্ট বহুভুজ | বহুভুজ + লেআউট ব্লক |
| টেবিল পার্সিং | শুধুমাত্র কোঅর্ডিনেট TSV | HTML টেবিল স্ট্রিংস | কোনোটি না | সেল কোঅর্ডিনেট গ্রিডস |
| পাঠের ক্রম সনাক্তকরণ | নিয়ম-ভিত্তিক (বহু-কলাম এ ব্রেক হয়) | এমএল লেআউট বিশ্লেষণ | মৌলিক লাইন গ্রুপিং | নির্ধারিত রিডিং-অর্ডার মডেল |
| সরাসরি JSON স্কিমা | রূপান্তর প্রয়োজন | Python Dict / JSON | Python List / JSON | টাইপড Pydantic মডেল |
| আদর্শ ডাউনস্ট্রিম টার্গেট | সংরক্ষণীয় PDF, পুরাতন DMS | ফর্ম/রসিদ ডেটা, ইআরপি | দ্রুত স্ক্রিপ্ট, দৃশ্য টেক্সট | এলএলএম ইনজেস্ট, র্যাগ আর্কিটেকচার |
পাইপলাইন সুপারিশ: কোনটি আপনি বেছে নেবেন?
- Choose Tesseract যদি আপনার সম্মতি প্রয়োজনীয়তা মানক
hOCR,ALTO XML, অথবা অনুসন্ধানযোগ্য PDF/A ডেলিভারেবলস সরকারী বা সংরক্ষণাগার রেকর্ডের জন্য দাবি করে। - Choose PaddleOCR যদি আপনি অপারেশনাল আর্থিক ডকুমেন্ট (ইনভয়েস, রসিদ, ট্যাক্স ফর্ম) প্রক্রিয়া করছেন যেগুলোতে জটিল, বর্ডারলেস টেবিল আছে যা HTML বা স্প্রেডশিটে রূপান্তরিত করতে হবে।
- Choose EasyOCR যদি আপনি হালকা, পাইথনিক লাইব্রেরি চান যা কনফিগারেশন ঝামেলা ছাড়াই প্রাকৃতিক ছবি, রাস্তার সাইন, অথবা ক্রপ করা UI উপাদান থেকে টেক্সট সনাক্ত ও বের করতে পারে।
- Choose Surya OCR যদি আপনি অগঠিত ব্যবসায়িক রিপোর্ট, গবেষণা পত্র, এবং প্রযুক্তিগত গাইডগুলোকে একটি এলএলএম বা ভেক্টর সার্চ ইঞ্জিনে ফিড করছেন যেখানে যুক্তিসঙ্গত রিডিং অর্ডার এবং পরিষ্কার কাঠামোগত সীমানা অত্যন্ত গুরুত্বপূর্ণ।
প্রায়শই জিজ্ঞাসিত প্রশ্ন (FAQ)
১. কোন ওপেন-সোর্স OCR আউটপুট ফরম্যাটটি বৃহৎ ভাষা মডেলে ইনপুট দেওয়ার জন্য সবচেয়ে সহজ?
Surya OCR-এর রিডিং-অর্ডার-সচেতন JSON এবং PaddleOCR PP-Structure-এর HTML টেবিলগুলি এলএলএম প্রম্পট কন্টেক্সট এবং র্যাগ ইনডেক্সিংয়ের জন্য সবচেয়ে পরিষ্কার উপস্থাপন প্রদান করে।
২. কি টেসার্যাক্ট তৃতীয় পক্ষের টুল ছাড়া নেটিভভাবে JSON প্রতিক্রিয়া তৈরি করতে পারে?
না, Tesseract স্বাভাবিকভাবে টেক্সট, TSV, PDF এবং hOCR/ALTO XML আউটপুট করে; JSON তৈরি করতে তার TSV বা hOCR আউটপুটকে একটি মধ্যবর্তী পার্সার ব্যবহার করে রূপান্তর করতে হয়।
৩. কীভাবে ৪-পয়েন্ট পলিগন কোঅর্ডিনেটগুলি অক্ষ-সামঞ্জস্য বাউন্ডিং বক্স থেকে ভিন্ন?
অক্ষ-সামঞ্জস্য বক্সগুলি সমতল টেক্সট অনুমান করে [x, y, width, height] ব্যবহার করে, যেখানে ৪-পয়েন্টের পলিগনগুলি ঘূর্ণায়িত, তির্যক বা বক্র টেক্সট লাইনগুলোকে সঠিকভাবে ঘেরার জন্য চারটি কোঅর্ডিনেট জোড়া প্রদান করে।
৪. কোন ইঞ্জিন টেবিলের গঠন সরাসরি কোডে আউটপুট করে, আলগা কোঅর্ডিনেটের পরিবর্তে?
PaddleOCR-এর PP-Structure মডিউল সনাক্ত করা টেবিল সীমানাগুলোকে সম্পূর্ণ HTML টেবিল ট্যাগ (<table>, <tr>, <td>) এ পুনর্গঠন করে, কাস্টম স্পেশিয়াল গণনা এড়িয়ে।
৫. কেন স্ট্যান্ডার্ড EasyOCR আউটপুট বহু-কলাম বৈজ্ঞানিক পত্রিকায় সমস্যায় পড়ে?
EasyOCR স্থানীয় নিকটত্বের ভিত্তিতে টেক্সট লাইনগুলো চিহ্নিত করে, গ্লোবাল লেআউট হায়ারার্কির পরিবর্তে, ফলে পার্শ্ববর্তী কলাম থেকে টেক্সট একে অপরের সাথে মিশে যায় যদি বাহ্যিক লেআউট ইঞ্জিন দ্বারা সীমাবদ্ধ না করা হয়।