সর্বশেষ আপডেট: ৩০ সেপ্টেম্বর, ২০২৬
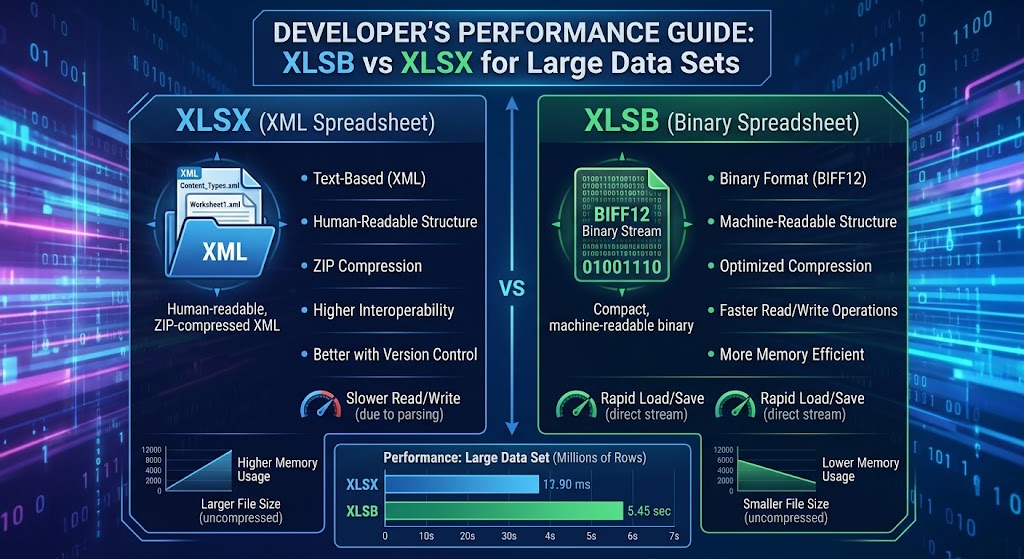
বৃহৎ ডেটা সেটের জন্য XLSB vs XLSX: ডেভেলপারদের পারফরম্যান্স গাইড
যদি আপনি ডেটা পাইপলাইন, ব্যাকএন্ড রিপোর্টিং ইঞ্জিন, অথবা মাইক্রোসফট এক্সেল-এর সাথে ইন্টারফেস করা অ্যানালিটিক্স টুল তৈরি করেন, আপনি সম্ভবত “দেয়াল”-এ পৌঁছেছেন।
একজন ব্যবহারকারী ৪৫০,০০০-সারি বিশিষ্ট একটি ওয়ার্কবুক আপলোড করেন। আপনার সার্ভার ওয়ার্কার থ্রেড চালু করে, মেমরি ব্যবহার গিগাবাইটে বৃদ্ধি পায়, গারবেজ কালেকশন রানটাইমকে হ্যাং করে দেয়, এবং আপনার এক্সিকিউশন টাইমআউট হয়। আপনি পে-লোড পরীক্ষা করেন: এটি একটি স্ট্যান্ডার্ড .xlsx ফাইল।
এটি সমাধান করতে, ডেভেলপাররা প্রায়ই চাঙ্কিং, স্ট্রিমিং পার্সার, অথবা ফাইলগুলোকে ব্যাকগ্রাউন্ড ওয়ার্কারে অফলোড করার কাজ করতে দিন কাটিয়ে দেয়। তবু, সবচেয়ে কার্যকর অপ্টিমাইজেশনগুলোর একটি শূন্য আর্কিটেকচারাল পুনর্নির্মাণের প্রয়োজন হয় না: ফাইল এক্সটেনশনটি .xlsx থেকে .xlsb-এ পরিবর্তন করা।
এই গাইডে, আমরা উভয় ফরম্যাটের অন্তর্নিহিত কাঠামোতে গভীরভাবে প্রবেশ করি, কেন তাদের অভ্যন্তরীণ আর্কিটেকচারগুলি র্যাডিক্যালভাবে ভিন্ন পারফরম্যান্স বৈশিষ্ট্য উৎপন্ন করে তা পরীক্ষা করি, পাইথন এবং .NET-এ নির্দিষ্ট বেঞ্চমার্ক তুলনা করি, এবং প্রোডাকশনে বাইনারি ওয়ার্কবুক ডিপ্লয় করার সময় স্পষ্ট নিয়মগুলো রূপরেখা করি।
১. আভ্যন্তরীণভাবে: OpenXML vs. BIFF12
কেন বড় ডেটাসেটের ক্ষেত্রে পারফরম্যান্স এত নাটকীয়ভাবে বিচ্যুত হয় তা বুঝতে, আমাদের দেখতে হবে প্রতিটি ফরম্যাট কীভাবে ডিস্কে রেকর্ড সংরক্ষণ করে।
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
উভয় .xlsx এবং .xlsb ফাইলই কমপ্রেসড ZIP কন্টেইনার, যা Open Packaging Conventions (OPC) অনুসরণ করে। যদি আপনি কোনো ফাইলের নাম .zip করে পরিবর্তন করেন এবং তা এক্সট্র্যাক্ট করেন, তাহলে আপনি একটি পরিচিত ডিরেক্টরি লেআউট দেখতে পাবেন: _rels, docProps, এবং xl/worksheets/।
xl/worksheets/ ফোল্ডারের ভিতরে গুরুত্বপূর্ণ পার্থক্যটি রয়েছে:
- XLSX শিটগুলোকে সাধারণ XML টেক্সট (
sheet1.xml) হিসেবে সংরক্ষণ করে। - XLSB শিটগুলোকে মালিকানাধীন বাইনারি স্ট্রিম (
sheet1.bin) হিসেবে সংরক্ষণ করে, যা Microsoft-এর BIFF12 (Binary Interchange File Format 12) ব্যবহার করে এনকোড করা হয়।
কিভাবে XLSX ডেটা এনকোড করে (XML DOM ওভারহেড)
একটি XLSX ওয়ার্কশিটে, প্রতিটি সেল স্পষ্ট XML ট্যাগ দিয়ে ঘোষণা করা হয়:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
এই সারি পড়ার সময়, আপনার রানটাইমকে অবশ্যই:
- কাঁচা ডিফ্লেট স্ট্রিমকে টেক্সটে ডিকমপ্রেস করুন।
- স্ট্রিং অক্ষরগুলোকে টোকেনাইজ এবং পার্স করে XML DOM অথবা SAX ইভেন্ট স্ট্রিমে রূপান্তর করুন।
- খোলার এবং বন্ধের ট্যাগগুলি যাচাই করুন (
<c>,</c>,<v>,</v>)। - একটি পৃথক
sharedStrings.xmlটেবিল থেকে স্ট্রিং লুকআপ সমাধান করুন। - ASCII টেক্সট
"98234.55"-কে IEEE 754 64-বিট ফ্লোটিং-পয়েন্ট সংখ্যায় পার্স করুন।
প্রতিটি সেল স্ট্রিং পার্সিং, স্ট্রিং অ্যালোকেশন এবং লেক্সিকাল বিশ্লেষণের জন্য CPU ওভারহেড তৈরি করে। এটি ৫,০০,০০০ সারি এবং ৩০টি কলাম (১৫ মিলিয়ন সেল) জুড়ে গুণ করলে, CPU সিনট্যাক্স পার্সিংয়ে ডোমেইন মান প্রক্রিয়াকরণের তুলনায় অনেক বেশি সাইকেল ব্যয় করে।
কিভাবে XLSB ডেটা এনকোড করে (BIFF12 বাইনারি স্ট্রিম)
BIFF12 সম্পূর্ণভাবে টেক্সট সিরিয়ালাইজেশন বাদ দেয়। স্ট্রিং মার্কআপের পরিবর্তে, ডেটা ভেরিয়েবল-দৈর্ঘ্যের বাইনারি রেকর্ডের ধারাবাহিক ক্রম হিসেবে সাজানো হয়:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12-এ একটি ফ্লোটিং-পয়েন্ট সেল "98234.55" এর মতো স্ট্রিং উপস্থাপন ব্যবহার করে না। এটি সরাসরি উপস্থাপিত হয়:
- রেকর্ড আইডির জন্য ২ বাইট (যেমন,
BrtCellRkঅথবাBrtCellReal) - কলাম/সারি সূচকের জন্য ৪ বাইট
- ৮ বাইট যা কাঁচা, IEEE 754 ডাবল-প্রিসিশন বাইট গঠন ধারণ করে
যখন আপনার পার্সার একটি XLSB ফাইল পড়ে, এটি সম্পূর্ণভাবে লেক্সিক্যাল পার্সিং এড়িয়ে যায়। এটি রেকর্ড হেডার পড়ে, বাফার থেকে ৮টি কাঁচা বাইট নেয়, সেগুলো সরাসরি মেমরিতে কপি করে, এবং পয়েন্টারকে এগিয়ে নিয়ে যায়। যাচাই করার জন্য কোনো ট্যাগ নেই, স্ট্রিং-টু-নাম্বার টাইপ রূপান্তর নেই, এবং সংখ্যাত্মক ডেটার জন্য শূন্য UTF-8 ডিকোডিং ওভারহেড থাকে না।
২. পরিমাণগত বেঞ্চমার্ক: ডিস্ক, মেমরি, এবং থ্রুপুট
নিচের টেস্টগুলো একই ট্যাবুলার ডেটা যা XLSX এবং XLSB উভয় ফরম্যাটে সংরক্ষিত, তা মূল্যায়ন করে।
নিচের টেস্টগুলো একই ট্যাবুলার ডেটা যা XLSX এবং XLSB উভয় ফরম্যাটে সংরক্ষিত, তা মূল্যায়ন করে।
পরীক্ষা পরিবেশ
- CPU: AMD Ryzen 9 5900X (১২ কোর, ২৪ থ্রেড)
- RAM: ৬৪ GB DDR4-3600
- স্টোরেজ: PCIe 4.0 NVMe SSD
- রানটাইম: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
মূল পারফরম্যান্স মেট্রিক্স
| মেট্রিক | XLSX (OpenXML) | XLSB (BIFF12) | ডেল্টা / উন্নতি |
|---|---|---|---|
| ডিস্কে ফাইলের আকার | 128.4 MB | 68.2 MB | ~৪৭% ছোট |
| সংরক্ষণ / সিরিয়ালাইজেশন সময় | ৪২.৬ সেকেন্ড | ১৪.১ সেকেন্ড | ৩.০x দ্রুততর |
| পড়ার সময় (Python DOM পার্সার) | ৩৮.২ সেকেন্ড | ৮.৯ সেকেন্ড | ৪.৩x দ্রুততর |
| পড়ার সময় (Rust/C ইঞ্জিন) | 6.4 s | 1.9 s | ৩.৩x দ্রুততর |
| পড়ার সময় শীর্ষ হিপ বরাদ্দ | ~1.85 GB | ~510 MB | ~৭২% হ্রাস |
কেন XLSB ফাইলগুলো ছোট
উভয় ফরম্যাটই স্ট্যান্ডার্ড ZIP কম্প্রেশন ব্যবহার করলেও, বাইনারি স্ট্রিমগুলি বেলুনের মতো XML টেক্সসের তুলনায় অনেক বেশি কার্যকরভাবে কম্প্রেস করে:
- অপ্রয়োজনীয় সিনট্যাক্স দূর করা হয়: XML-এ প্রতিটি রেকর্ডে পুনরাবৃত্ত ট্যাগ (
<c r=\"AA1\" s=\"1\">) থাকে। যদিও ZIP কম্প্রেশন পুনরাবৃত্ত স্ট্রিংগুলোকে কমিয়ে দেয়, অকম্প্রেসড ডেটা স্ট্রিমটি বিশাল হয়। - সংখ্যাত্মক ঘনত্ব: XML-এ, সংখ্যা
12345678.9012এর জন্য ১৪ বাইট ASCII টেক্সট প্রয়োজন। BIFF12-এ, এটি ৮-বাইট ডাবল হিসেবে সংরক্ষিত হয় (অথবা নির্দিষ্ট নির্ভুলতা নিয়মে ফিট হলে ৪-বাইটRKরেকর্ডে প্যাক করা হয়)।
৩. মেমরি ফুটপ্রিন্ট এবং গারবেজ কালেকশন চাপ
ওয়েব সার্ভিস এবং মাইক্রোসার্ভিসগুলি যখন সমসাময়িক অনুরোধগুলি পরিচালনা করে, তখন CPU গতি কেবল লড়াইয়ের অর্ধেক; মেমরি ফুটপ্রিন্ট হল সেই ক্ষেত্র যেখানে অ্যাপ্লিকেশনগুলো প্রকৃতপক্ষে ব্যর্থ হয়।
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
যখন একটি XML পার্সার ১০০ MB XLSX ফাইল প্রক্রিয়া করে, তখন তাকে হাজার হাজার অস্থায়ী স্ট্রিং টোকেন, স্ট্রিং স্লাইস বাফার এবং ডিকশনারি লুকআপ তৈরি করতে হয়। গার্বেজ-কলেক্টেড ভাষাগুলিতে (Java, C#, Go, Node.js, Python), এটি তীব্র হিপ ফ্র্যাগমেন্টেশন সৃষ্টি করে এবং রানটাইমকে ঘন ঘন গার্বেজ কালেকশন (GC) বিরতিতে ঠেলে দেয়।
কারণ XLSB পার্সিং সরাসরি নির্দিষ্ট-প্রস্থের বাইট স্লাইসের উপর কাজ করে, পার্সারগুলি ডেটা স্ট্যাক-অ্যালোকেটেড স্ট্রাকচার বা পুনরায় ব্যবহারযোগ্য বাইট বাফারে পড়তে পারে। ফলস্বরূপ মেমরি ব্যবহার নাটকীয়ভাবে কমে যায় এবং রানটাইম অ্যালোকেটরের কোনো থ্র্যাশিং হয় না।
৪. ডেভেলপার বাস্তবায়ন উদাহরণ
চলুন দেখি কীভাবে সাধারণ ডেভেলপার টুলচেইনগুলিতে XLSB ব্যবহার করা যায়।
Python: OpenPyXL থেকে Calamine / PyXLSB-এ মাইগ্রেশন
স্ট্যান্ডার্ড pandas.read_excel('data.xlsx') ডিফল্টভাবে openpyxl ব্যবহার করে, যা একটি ভারী ইন-মেমরি ট্রি তৈরি করে।
বড় XLSB ফাইলগুলোকে সর্বোচ্চ গতি দিয়ে প্রক্রিয়া করতে, রাস্ট-চালিত calamine ইঞ্জিন ব্যবহার করুন (যা python-calamine এর মাধ্যমে উপলব্ধ এবং আধুনিক Pandas-এ সংযুক্ত):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
যদি আপনি পুরো ম্যাট্রিক্সকে DataFrame-এ লোড না করে, সারি-দর-সারি বিশাল ডেটাসেটের উপর ইটারেট করছেন, তবে pyxlsb একটি হালকা স্ট্রিমিং ইটারেটর প্রদান করে:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: উচ্চ-প্রদর্শন স্ট্রিম ইনজেশন
.NET-এ, ClosedXML বা EPPlus এর মতো লাইব্রেরিগুলি স্ট্যান্ডার্ড জেনারেশনের জন্য চমৎকার, তবে মেমরি শেষ না হয়ে বড় ফাইল ইনজেস্ট করার জন্য, XLSB সাপোর্টসহ ExcelDataReader অত্যন্ত দ্রুত:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. আর্কিটেকচারাল ট্রেড-অফ: কখন XLSB ব্যবহার করা উচিত নয়
এর বিশাল পারফরম্যান্স সুবিধা সত্ত্বেও, XLSB কোনো চমৎকার সমাধান নয়। আপনার স্ট্যাকে এটি প্রয়োগ করার আগে আপনাকে কয়েকটি অপারেশনাল ট্রেড-অফ বিবেচনা করা উচিত:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
১. ইকোসিস্টেম এবং লাইব্রেরি সাপোর্ট
- XLSX: সর্বজনীন। প্রায় প্রতিটি ভাষা, লাইব্রেরি, SaaS টুল (Google Sheets, Airtable, Tableau), এবং ওয়েব পার্সার নেটিভভাবে OpenXML সমর্থন করে।
- XLSB: কম প্রচলিত। যদিও Excel, LibreOffice, এবং পরিণত ডেভেলপার লাইব্রেরি (
ExcelDataReader,pyxlsb,calamine,Aspose) এটি সমর্থন করে, অনেক হালকা প্যাকেজ বা শুদ্ধ ওয়েব-ভিত্তিক জাভাস্ক্রিপ্ট পার্সার (যেমনSheetJS-এর পুরোনো সংস্করণ) সীমিত বা শুধুমাত্র-পড়া সমর্থন রাখে।
২. গিট ও ভার্সন কন্ট্রোল ডিফিং
- XLSX: কারণ এতে ZIP কন্টেইনারের ভিতরে টেক্সট XML থাকে, কমান্ড-লাইন ইউটিলিটি এবং Git হুকগুলি ZIP আনজিপ করে এবং XML ফরম্যাট করে কমিটের মধ্যে পাঠযোগ্য কাঠামোগত পার্থক্য তৈরি করতে পারে।
- XLSB: সম্পূর্ণ বাইনারি ডেটা। ভার্সন কন্ট্রোল সিস্টেমগুলি এটি কঠোরভাবে একটি অস্বচ্ছ বাইনারি ব্লব হিসেবে বিবেচনা করে, ফলে সূক্ষ্ম পার্থক্য বা লাইন-লেভেল মার্জের কোনো সম্ভাবনা থাকে না।
৩. ওয়েব ক্লায়েন্ট রেন্ডারিং
যদি আপনার আর্কিটেকচার ব্রাউজারে সরাসরি WebAssembly বা ক্লায়েন্ট-সাইড জাভাস্ক্রিপ্টের মাধ্যমে স্প্রেডশিট রেন্ডারিংয়ের উপর নির্ভর করে, তবে XLSX পার্সারগুলি ক্লায়েন্ট-সাইড বাইনারি পার্সারের তুলনায় উল্লেখযোগ্যভাবে বেশি পরিপক্ক এবং এজ-কেস রেন্ডারিং বাগের প্রতি কম সংবেদনশীল।
৪. তৃতীয়-পক্ষ ইনজেশন পাইপলাইন
যদি আপনি বাহ্যিক এন্টারপ্রাইজ ক্লায়েন্টদের জন্য ফাইল রপ্তানি করছেন, অনেক কঠোর কর্পোরেট সিকিউরিটি নীতি .xlsb ফাইলগুলোকে চিহ্নিত করে। কারণ BIFF12 ফাইলগুলো VBA ম্যাক্রোকে .xlsm ফাইলের মতোই সংরক্ষণ করতে পারে (অতিরিক্ত এক্সটেনশন প্রয়োজন না করে), কিছু মেল ফিল্টার এবং ফায়ারওয়াল স্ক্যানার .xlsb আপলোডকে সম্ভাব্য ম্যাক্রো-ধারী হুমকি হিসেবে কোয়ারেন্টাইন করে।
৬. সারাংশ তুলনা: কোন ফরম্যাট জয়ী হয়?
| বৈশিষ্ট্য | XLSX | XLSB | বিজয়ী |
|---|---|---|---|
| পড়া / পার্স গতি | মাঝারি থেকে খারাপ | অত্যন্ত দ্রুত | XLSB |
| লেখা / উৎপাদন গতি | CPU-নিবিড় | দ্রুত | XLSB |
| ফাইল সংকোচন | ভাল | চমৎকার (~40-50% smaller) | XLSB |
| মেমরি বরাদ্দ | উচ্চ (ভারি GC চাপ) | নিম্ন (সরাসরি বাইট রিডিং) | XLSB |
| টুলিং আন্তঃক্রিয়াশীলতা | সার্বজনীন | উচ্চ, তবে নির্বাচনী | XLSX |
| সিকিউরিটি স্ক্যানিং ঘর্ষণ | ন্যূনতম | আকস্মিক মিথ্যা পজিটিভ | XLSX |
| ম্যাক্রো সক্ষমতা | না (.xlsm প্রয়োজন) | হ্যাঁ (ম্যাক্রো নেটিভভাবে সমর্থন করে) | বাঁধা |
৭. ডেভেলপারদের রায়
যখন XLSX ব্যবহার করবেন:
- ফাইলের আকার ছোট থেকে মাঝারি (< ৫০,০০০ সারি)।
- আপনার ফাইলগুলি তৃতীয় পক্ষের SaaS প্ল্যাটফর্ম বা ভোক্তা অ্যাপ (যেমন, Google Sheets) দ্বারা গ্রহণ করা উচিত।
- ফাইলটি পড়া শেষ ক্লায়েন্টের পরিবেশ আপনি নিয়ন্ত্রণ করতে পারবেন না।
যখন XLSB এ পরিবর্তন করবেন:
- আপনি যদি অভ্যন্তরীণ পাইপলাইন, ব্যাচ জব, ETL সিস্টেম, অথবা কর্মী কাজ তৈরি করেন যা বিশাল ডেটা এক্সট্র্যাক্ট (> ১০০,০০০ সারি) পরিচালনা করে।
- আপনার সার্ভারগুলি স্প্রেডশিট সিরিয়ালাইজেশন বা ডেসিরিয়ালাইজেশনের সময় আউট-অফ-মেমরি (OOM) ত্রুটির সম্মুখীন হচ্ছে।
- আপনাকে বড় পুনরাবৃত্তি আর্থিক মডেল বা ডেটা রপ্তানির জন্য S3/ব্লব স্টোরেজের ফুটা প্রিন্ট এবং নেটওয়ার্ক ট্রানজিট সময় কমাতে হবে।
XLSB তে পরিবর্তন করা প্রায়শই আপনার এক্সপোর্ট সার্ভিসের কনফিগারেশন স্ট্রিং পরিবর্তনের মতো সহজ, তবু এটি ৩ গুণ থেকে ৫ গুণ পর্যন্ত থ্রুপুট বৃদ্ধি প্রদান করে, যা সাধারণত কোড অপ্টিমাইজেশনের সপ্তাহের প্রয়োজন হয়।
প্রায়শই জিজ্ঞাসিত প্রশ্ন (FAQ)
**Q1: একটি XLSB ফাইল কি একটি XLSX ফাইলের মতো একই সারি এবং কলাম সীমা সমর্থন করে? হ্যাঁ; উভয়ই XLSB এবং XLSX একই গ্রিড সিলিং শেয়ার করে, যা প্রতি ওয়ার্কশীটে ১,০৪৮,৫৭৬ সারি এবং ১৬,৩৮৪ কলাম।
**Q2: একটি XLSB ফাইল কি ফাইল এক্সটেনশন পরিবর্তন না করে নিরাপদে VBA ম্যাক্রো সংরক্ষণ করতে পারে?
হ্যাঁ, XLSX এর বিপরীতে (যা কোড চালানোর জন্য XLSM হিসেবে সংরক্ষণ প্রয়োজন), XLSB একই .xlsb ফাইল ফরম্যাটের মধ্যে নেটিভভাবে বাইনারি VBA ম্যাক্রো সংরক্ষণ সমর্থন করে।
**Q3: যদি উভয় ফরম্যাটই ইতিমধ্যে ZIP কম্প্রেসড হয়, তবে একটি ফাইলকে XLSB হিসেবে সংরক্ষণ করলে এর আকার কেন কমে যায়? XLSB অপ্রয়োজনীয় টেক্সট মার্কআপ ট্যাগগুলি বাদ দেয় এবং সেল অবস্থান, রেকর্ড এবং কাঁচা সংখ্যামূলক মানগুলোকে টাইট বাইনারি বাইট স্ট্রিমে এনকোড করে, যা সাধারণ XML স্ট্রিংয়ের তুলনায় অনেক বেশি ঘনভাবে কম্প্রেস করে।
**Q4: গুগল শিটস কি সরাসরি XLSB ফাইল ইম্পোর্ট এবং এডিট করতে পারে?
না; গুগল শিটস স্বাভাবিকভাবে .xlsb ফাইল সরাসরি খুলতে বা রূপান্তর করতে পারে না, তাই আপনাকে ইম্পোর্টের আগে সেগুলোকে .xlsx অথবা CSV তে রূপান্তর করতে হবে।
**Q5: XLSB ফাইল কি XLSX ফাইলের তুলনায় ডেটা করাপশনের প্রতি বেশি প্রবণ? যদিও XML ফাইলগুলি কখনও কখনও আংশিকভাবে ক্ষতিগ্রস্ত হলে টেক্সট এডিটর দিয়ে ম্যানুয়ালি পরীক্ষা বা মেরামত করা যায়, বাইনারি BIFF12 স্ট্রিমগুলি কঠোর বাইট অফসেট প্রয়োজন এবং গঠনগত সেক্টর ক্ষতিগ্রস্ত হলে ম্যানুয়ালি পুনরুদ্ধার করা কঠিন।