Poslední aktualizace: 30. září 2026
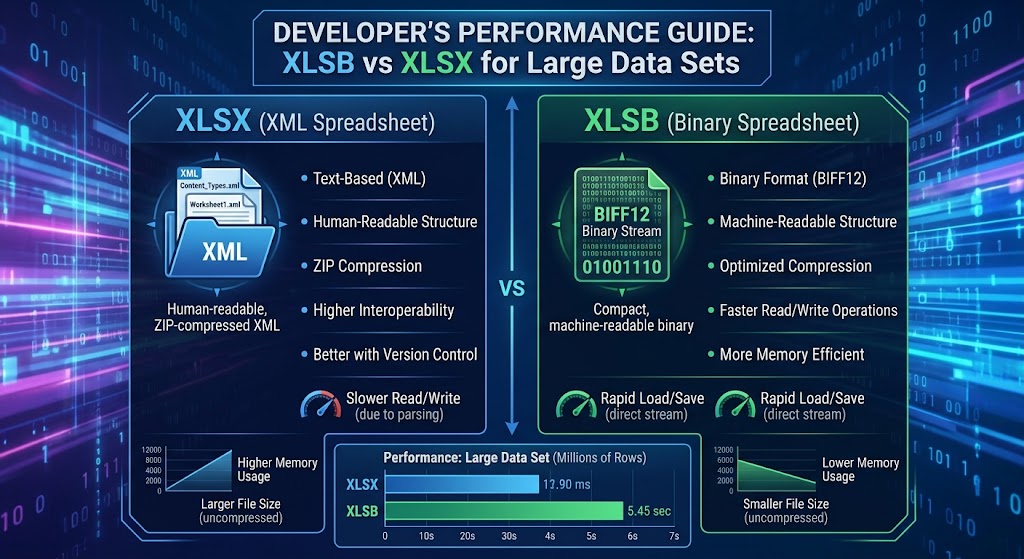
XLSB vs XLSX pro velké datové sady: Průvodce výkonem pro vývojáře
Pokud vytváříte datové pipeline, backendové reportingové enginy nebo analytické nástroje, které komunikují s Microsoft Excel, pravděpodobně jste narazili na “zeď”.
Uživatel nahrá sešit s 450 000 řádky. Váš server spustí pracovní vlákna, spotřeba paměti vystřelí do gigabajtů, garbage collection zmrazí běh, a vaše provedení vyprší časový limit. Prohlédnete si payload: jedná se o standardní soubor .xlsx.
Aby to vyřešili, vývojáři často stráví dny implementací chunkingu, streamovacích parserů nebo přesouváním souborů do background workerů. Přesto jedna z nejúčinnějších optimalizací nevyžaduje žádnou architektonickou redesignaci: změna přípony souboru z .xlsx na .xlsb.
V tomto průvodci se ponoříme pod kapotu obou formátů, prozkoumáme, proč jejich vnitřní architektury vytvářejí radikálně odlišné výkonnostní charakteristiky, porovnáme konkrétní benchmarky v Pythonu a .NET a nastíníme jasná pravidla, kdy nasadit binární sešity do produkce.
1. Pod kapotou: OpenXML vs. BIFF12
Abychom pochopili, proč se výkon tak dramaticky liší u velkých datových sad, musíme se podívat na to, jak každý formát ukládá záznamy na disku.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Oba soubory .xlsx i .xlsb jsou komprimované ZIP kontejnery vyhovující Open Packaging Conventions (OPC). Pokud přejmenujete kterýkoli soubor na .zip a rozbalíte jej, uvidíte známou strukturu adresářů: _rels, docProps a xl/worksheets/.
Klíčový rozdíl se nachází uvnitř složky xl/worksheets/:
- XLSX ukládá listy jako prostý XML text (
sheet1.xml). - XLSB ukládá listy jako proprietární binární proudy (
sheet1.bin), kódované pomocí Microsoft BIFF12 (Binary Interchange File Format 12).
Jak XLSX kóduje data (přetížení XML DOM)
V listu XLSX je každá buňka deklarována pomocí explicitních XML značek:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Při čtení tohoto řádku musí vaše runtime:
- Rozbalit surový deflate stream do textu.
- Tokenizovat a parsovat řetězcové znaky do XML DOM nebo SAX eventového proudu.
- Ověřte otevírací a uzavírací značky (
<c>,</c>,<v>,</v>). - Vyřešte vyhledávání řetězců ze samostatné tabulky
sharedStrings.xml. - Převést ASCII text
"98234.55"na 64bitové číslo s plovoucí desetinnou čárkou podle IEEE 754.
Každá buňka způsobuje zatížení CPU kvůli parsování řetězců, alokaci řetězců a lexikální analýze. Vynásobte to 500 000 řádků a 30 sloupců (15 milionů buněk) a CPU stráví podstatně více cyklů parsováním syntaxe než zpracováním hodnot domény.
Jak XLSB kóduje data (BIFF12 binární proud)
BIFF12 zcela odmítá serializaci textu. Místo značkování řetězců jsou data uspořádána jako sekvenční řada binárních záznamů proměnné délky:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Buňka s plovoucí desetinnou čárkou v BIFF12 nepoužívá řetězcové reprezentace jako "98234.55". Je reprezentována přímo:
- 2 bajty pro ID záznamu (např.
BrtCellRkneboBrtCellReal) - 4 bajty pro indexy sloupců/řádků
- 8 bajtů obsahujících surovou strukturu bajtů IEEE 754 dvojité přesnosti
Když váš parser čte soubor XLSB, zcela obchází lexikální parsování. Přečte hlavičku záznamu, získá 8 surových bajtů z bufferu, zkopíruje je přímo do paměti a posune ukazatel vpřed. Nejsou žádné značky k ověření, žádné konverze typu řetězec‑na‑číslo a nulové zatížení dekódování UTF‑8 pro číselná data.
2. Kvantitativní benchmarky: Disk, paměť a propustnost
Pro ilustraci reálného dopadu zvažte simulovanou datovou sadu obsahující 750 000 řádků a 25 sloupců (směs časových razítek, čísel s plovoucí desetinnou čárkou, celých čísel a kódů kategorií).
Níže uvedené testy hodnotí identická tabulková data uložená jak ve formátu XLSX, tak XLSB.
Testovací prostředí
- CPU: AMD Ryzen 9 5900X (12 jader, 24 vláken)
- RAM: 64 GB DDR4‑3600
- Úložiště: PCIe 4.0 NVMe SSD
- Runtime: Python 3.11 (
openpyxl,pyxlsb,calamine) a .NET 8 (ExcelDataReader,ClosedXML)
Klíčové výkonnostní metriky
| Metrika | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Zlepšení |
|---|---|---|---|
| Velikost souboru na disku | 128.4 MB | 68.2 MB | ~47% menší |
| Uložení / čas serializace | 42.6 s | 14.1 s | 3.0x rychlejší |
| Čas čtení (Python DOM parser) | 38.2 s | 8.9 s | 4.3x rychlejší |
| Čas čtení (Rust/C Engine) | 6.4 s | 1.9 s | 3,3x rychlejší |
| Nejvyšší alokace haldy během čtení | ~1,85 GB | ~510 MB | ~72% snížení |
Proč jsou soubory XLSB menší
Zatímco oba formáty používají standardní ZIP kompresi, binární proudy komprimují mnohem efektivněji než nafouknutý XML text:
- Redundantní syntaxe je odstraněna: XML obsahuje opakující se značky (
<c r="AA1" s="1">) u každého záznamu. Zatímco ZIP komprese zmírňuje opakující se řetězce, nekomprimovaný datový proud je obrovský. - Číselná hustota: V XML číslo
12345678.9012vyžaduje 14 bajtů ASCII textu. V BIFF12 je uloženo jako 8‑bajtové double (nebo zabaleno do 4‑bajtového záznamuRK, pokud splňuje specifická pravidla přesnosti).
3. Paměťová stopa a tlak na garbage collection
Pro webové služby a mikroservisy zpracovávající souběžné požadavky je rychlost CPU jen polovinou boje; paměťová stopa je místo, kde aplikace skutečně selhávají.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Když XML parser zpracovává soubor XLSX o velikosti 100 MB, musí vytvořit tisíce efemérních řetězcových tokenů, bufferů řezů řetězců a vyhledávání ve slovníku. V jazycích s automatickým sběrem paměti (Java, C#, Go, Node.js, Python) to způsobuje extrémní fragmentaci haldy a nutí běhové prostředí k častým pauzám garbage collection (GC).
Protože parsování XLSB operuje přímo na pevně širokých byte slicech, mohou parsery číst data do struktur alokovaných na zásobníku nebo do znovupoužitelných byte bufferů. Výsledkem je dramaticky snížená paměťová stopa a nulové přetěžování alokátoru během běhu.
4. Příklady implementace pro vývojáře
Podívejme se, jak využít XLSB v běžných vývojářských nástrojových řetězcích.
Python: Přechod z OpenPyXL na Calamine / PyXLSB
Standardní pandas.read_excel('data.xlsx') používá jako výchozí openpyxl, který vytváří těžký strom v paměti.
Pro zpracování velkých souborů XLSB s maximální rychlostí použijte engine poháněný Rustem calamine (k dispozici přes python-calamine a integrován do moderního Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Pokud iterujete přes obrovské datové sady řádek po řádku, aniž byste načítali celou matici do DataFrame, pyxlsb poskytuje lehký streamovací iterátor:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Vysoce výkonný příjem streamu
V .NET jsou knihovny jako ClosedXML nebo EPPlus skvělé pro standardní generování, ale pro načítání velkých souborů bez vyčerpání paměti je ExcelDataReader s podporou XLSB mimořádně rychlý:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Architektonické kompromisy: Kdy NEPOUŽÍVAT XLSB
Navzdory svým ohromujícím výkonnostním výhodám není XLSB všelék. Měli byste zvážit několik provozních kompromisů, než jej nasadíte napříč svým stackem:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosystém a podpora knihoven
- XLSX: Univerzální. Prakticky každý jazyk, knihovna, SaaS nástroj (Google Sheets, Airtable, Tableau) a webový parser podporuje OpenXML nativně.
- XLSB: Méně rozšířený. Zatímco Excel, LibreOffice a vyspělé vývojářské knihovny (
ExcelDataReader,pyxlsb,calamine,Aspose) jej podporují, mnoho lehkých balíčků nebo čistě webových JavaScript parserů (například starší verzeSheetJS) má omezenou nebo jen pro čtení podporu.
2. Git a porovnávání verzí
- XLSX: Protože obsahuje textové XML uvnitř ZIP kontejneru, příkazové řádkové nástroje a Git hooky mohou rozbalit a formátovat XML k vytvoření čitelných strukturálních rozdílů mezi commity.
- XLSB: Čistá binární data. Systémy pro správu verzí jej považují za neprůhledný binární blob, což eliminuje jakoukoli možnost detailního porovnání rozdílů nebo sloučení na úrovni řádků.
3. Renderování webového klienta
Pokud vaše architektura spoléhá na vykreslování tabulek přímo v prohlížeči pomocí WebAssembly nebo klientského JavaScriptu, XLSX parsery jsou výrazně vyspělejší a méně náchylné k ohraničeným chybám vykreslování než klientské binární parsery.
4. Ingestní pipeline třetích stran
Pokud exportujete soubory pro externí firemní klienty, mnoho přísných firemních bezpečnostních politik označuje soubory .xlsb. Protože soubory BIFF12 mohou ukládat VBA makra stejně jako soubory .xlsm (bez nutnosti samostatné přípony), některé e‑mailové filtry a skenery firewallu karanténují nahrané soubory .xlsb jako potenciální hrozby obsahující makra.
6. Shrnutí srovnání: Který formát vyhrává?
| Funkce | XLSX | XLSB | Vítěz |
|---|---|---|---|
| Rychlost čtení / parsování | Střední až špatná | Bleskově rychlá | XLSB |
| Rychlost zápisu / generování | Náročné na CPU | Rychlý | XLSB |
| Komprese souboru | Dobré | Vynikající (~40-50% menší) | XLSB |
| Alokace paměti | Vysoká (Vysoký tlak na GC) | Nízká (Přímé čtení bajtů) | XLSB |
| Interoperabilita nástrojů | Univerzální | Vysoká, ale selektivní | XLSX |
| Odpor při bezpečnostním skenování | Minimální | Občasné falešné poplachy | XLSX |
| Možnost maker | Ne (.xlsm vyžadováno) | Ano (Podporuje makra nativně) | Remíza |
7. Verdikt vývojáře
Použijte XLSX, když:
- Soubory jsou malé až středně velké (< 50 000 řádků).
- Vaše soubory musí být načteny platformami SaaS třetích stran nebo spotřebitelskými aplikacemi (např. Google Sheets).
- Nemáte možnost kontrolovat prostředí koncového klienta, který soubor čte.
Přepněte na XLSB, když:
- Vytváříte interní pipeline, dávkové úlohy, ETL systémy nebo pracovní úkoly, které zpracovávají masivní extrakty dat (> 100 000 řádků).
- Vaše servery zaznamenávají chyby nedostatku paměti (OOM) během serializace nebo deserializace tabulky.
- Musíte minimalizovat stopu úložiště S3/blob a dobu přenosu po síti pro velké opakující se finanční modely nebo exporty dat.
Přechod na XLSB je často tak jednoduchý jako změna konfiguračního řetězce ve vaší exportní službě, přesto přináší zisk propustnosti 3‑ až 5‑násobný, který normálně vyžaduje týdny optimalizace kódu.
Často kladené otázky (FAQ)
**Q1: Podporuje soubor XLSB přesně stejné limity řádků a sloupců jako soubor XLSX? Ano; jak XLSB, tak XLSX mají stejný limit mřížky 1 048 576 řádků a 16 384 sloupců na list.
**Q2: Může soubor XLSB bezpečně uložit VBA makra bez změny přípony souboru?
Ano, na rozdíl od XLSX (který vyžaduje uložení jako XLSM pro spuštění kódu), XLSB nativně podporuje binární ukládání VBA maker přímo ve stejném formátu souboru .xlsb.
**Q3: Proč ukládání souboru jako XLSB snižuje jeho velikost, pokud jsou oba formáty již komprimovány pomocí ZIP? XLSB eliminuje objemné textové značky a kóduje pozice buněk, záznamy a surové číselné hodnoty do úsporných binárních bytových toků, které se komprimují mnohem hustěji než prosté XML řetězce.
**Q4: Může Google Sheets importovat a upravovat soubory XLSB přímo?
Ne; Google Sheets nemůže nativně otevřít nebo přímo převést soubory .xlsb, což vyžaduje jejich převod na .xlsx nebo CSV před importem.
**Q5: Jsou soubory XLSB náchylnější k poškození dat než soubory XLSX? Zatímco XML soubory lze někdy ručně prohlížet nebo opravit pomocí textového editoru při částečném poškození, binární proudy BIFF12 vyžadují přesné bytové offsety a jsou obtížně obnovitelné ručně, pokud jsou poškozeny strukturační sektory.