Sidst opdateret: 20 Aug, 2026
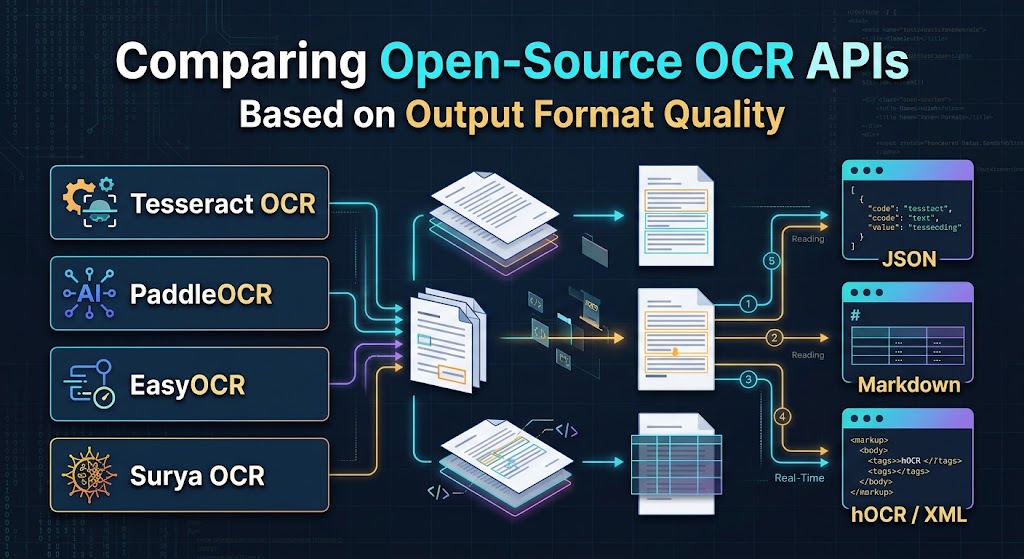
Sammenligning af Open-Source OCR API’er baseret på outputformatkvalitet
Når ingeniører evaluerer Optical Character Recognition (OCR)-motorer, dominerer typisk tegnfejlrate (CER) og ordfejlrate (WER) målingerne. Selvom genkendelsesnøjagtighed er afgørende, løser den kun halvdelen af problemet i produktion.
Hvis du parser komplekse flerkolonne-PDF’er, udtrækker linjeposter fra kvitteringer eller indlæser whitepapers i en LLM-embedningspipeline, skaber rå tekstudtræk store ingeniøroverhead. En streng af tegn uden layoutbevidsthed, logisk læseorden eller koordinatdata tvinger dit team til at skrive skrøbelige heuristiske parsere.
Den egentlige differentierende faktor for moderne dokumentarbejdsgange er outputformatkvalitet: hvor konsistent og rent en motor leverer koordinater, læseorden, strukturelle hierarki og tabeldata.
Nedenfor er en ingeniørfokuseret sammenligning af fire førende open source OCR-motorer—Tesseract, PaddleOCR, EasyOCR og Surya OCR—der evaluerer, hvordan deres output opfører sig i automatiserede pipelines.
De almindelige outputformater: Hvad ingeniører faktisk har brug for
Hver OCR API pakker den registrerede tekst forskelligt. At forstå disse formater hjælper med at afgøre, hvor meget efterbehandling din pipeline kræver:
- Almindelig tekst (
.txt): Den simpleste repræsentation. Den fjerner al positionsmetadata og kollapser flerkolonne‑layout til vandrette læsninger, hvilket kan forvirre afsnit. - Arkivstandarder (
hOCR,ALTO XML): XML/HTML‑baserede formater, der er standard i biblioteksarkivering. De indlejrer koordinater, skrifttypeestimat og tillidsvurderinger i DOM‑noder. Ekstremt robust til dokumentrekonstruktion, men omfangsrig for mikroservices. - Struktureret JSON: Standardvalget for moderne web‑backends. Leverer koordinat‑arrays (begrænsningsbokse eller polygoner), tillidsvurderinger og hierarkiske blok‑/linje‑/ord‑strukturer.
- Markdown (
.md) / HTML‑tabeller: Den moderne standard for Retrieval‑Augmented Generation (RAG). Bevarer semantiske sektioner (overskrifter, lister, fed tekst) og tabel‑matricer uden at kræve efterfølgende rumlig rekonstruktion.
1. Tesseract OCR
Vedligeholdt af Google er Tesseract fortsat den grundlæggende arbejdshest inden for open‑source OCR. Dens arkitektur læner sig tungt på traditionelle side‑segmenteringsalgoritmer suppleret af en LSTM‑baseret tegnmotor.
Indfødte outputformater
- Primære output: Ren tekst, hOCR (HTML), ALTO XML, TSV (Tabulatorseparerede værdier) og søgbart PDF/A.
- Layoutbevidsthed: Regelbaserede heuristikker via Page Segmentation Modes (PSM).
Analyse af outputformat
- Hvor den udmærker sig: Tesseracts
TSV- oghOCR-eksport er standardiseret og forudsigelig. En enkelt TSV-eksport returnerer strukturerede kolonner forlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightogconf. Hvis du konverterer papirarkiver til søgbare PDF’er eller har brug for streng overholdelse af institutionelle standarder, håndterer Tesseract dette indbygget uden brugerdefineret glue‑kode. - Hvor den falder kort: Tesseract har ingen indbygget JSON‑API. Forbrug af dens output i Python eller Node.js kræver parsing af XML/TSV‑filer eller brug af wrappers som
pytesseract. Dens layout‑motor har også problemer med ikke‑standard kolonneflow, og blander ofte tekst fra tilstødende kolonner, medmindre man leverer manuelle afgrænsningsudskæringer.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Støttet af Baidus PaddlePaddle‑framework har PaddleOCR opnået udbredt adoption på grund af sine letvægtsmodeller, omfattende flersprogsdækning og dedikerede dokumentanalyse‑værktøjssæt (PP-Structure).
Indfødte outputformater
- Primære output: Python-lister/ordbøger, rå JSON, visualiseringsoverlejringer og struktureret HTML via PP-Structure.
- Layoutbevidsthed: Høj (ved brug af dyb læringsmodeller til layout‑parsing, orienteringsklassificering og tabelgenoprettelse).
Analyse af outputformat
- Hvor den udmærker sig: Standard PaddleOCR returnerer 4‑punkt polygonkoordinater (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) sammen med tekststrenge og tillids‑scores. Dette håndterer skæv eller buet tekst elegant. Dog ligger dens egentlige styrke i PP-Structure‑pakken, som opdager layoutområder (titel, tekst, tabel, figur) og parser tabeller direkte til gyldige HTML‑strenge (<table>...</table>). Dette fjerner behovet for manuelt at beregne celle‑spænd fra afgrænsningsbokse. - Hvor den falder kort: Basis‑API’en returnerer indlejrede arrays, som mangler standard egenskabstaster på tværs af forskellige versioner. For strukturerede applikationer skriver udviklere typisk en mellemliggende adapter for at standardisere feltnavne (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Bygget på PyTorch af JaidedAI er EasyOCR designet til hurtig udvikleradoption. Det pakker CRAFT (Character Region Awareness for Text Detection) sammen med dyb‑læringsgenkendelsesnetværk i en minimal API.
Indfødte outputformater
- Primære output: Python-lister, der indeholder tuples af koordinater, genkendte strenge og tillidsværdier.
- Layoutbevidsthed: Lav til moderat (kun tekstlinjedetektion; ingen strukturel parsing på dokumentniveau).
Analyse af outputformat
- Hvor den udmærker sig: Enkelheden af returobjektet er uovertruffen:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
At kortlægge dette output til et standard REST-svar eller serialisere det direkte til GeoJSON/tilpassede skemaer kræver kun få linjer kode. Det fungerer pålideligt på naturlig scenetekst, nummerplader og isolerede dokumentudklip.
- Hvor den fejler: EasyOCR udfører ikke holistisk dokumentlayoutanalyse. Den identificerer ikke tabeller, overskriftshierarkier eller læseordrer på tværs af komplekse kolonner. Brug af EasyOCR på et to‑kolonne akademisk papir producerer ofte sammenflettede tekstuddrag, medmindre den kombineres med en upstream layoutdetektionsmodel (såsom YOLO eller LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya er et moderne dyb lærings OCR-rammeværk, designet specifikt til kompleks dokumentforståelse og LLM-indtags pipelines.
Indfødte outputformater
- Primære output: Pydantic-modellerede JSON-strukturer, logiske læseordensindekser, layoutbegrænsningsområder og linjedetektion polygoner.
- Layoutbevidsthed: Ekstremt høj (dybdelæringsbaseret layoutanalyse og sortering af læseorden).
Analyse af outputformat
- Hvor den udmærker sig: Surya adresserer direkte udfordringerne ved moderne AI-ingeniørarbejde. I stedet for at antage, at dokumenter læses top‑til‑bund, venstre‑til‑højre, anvender Surya en dedikeret model til at forudsige læseorden. Den grupperer linjer i logiske semantiske blokke, håndterer naturligt spredning over flere kolonner og udgiver typede strukturer via Pydantic. Dette gør efterfølgende indtagelse i vektordatabaser og Markdown‑konvertere direkte og pålidelig.
- Hvor den falder kort: Som et nyere, tungere PyTorch-baseret framework kræver Surya dedikeret GPU-udregning for at matche gennemstrømningen af optimerede C++‑motorer som Tesseract eller kvantiserede Paddle-modeller. Den sigter ikke mod ældre arkiveringsstandarder som hOCR eller ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Sammenligningsmatrix side om side
| Funktionalitet / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Indfødt hOCR / ALTO XML | Indbygget support | Kun tredjepart | Ingen | Ingen |
| Geometri for afgrænsningsboks | Aksialt justeret (x, y, w, h) | 4-punkts polygon | 4-punkts polygon | Polygon + layoutblokke |
| Tabelparsing | Kun koordinat-TSV | HTML-tabelstrenge | Ingen | Cellekoordinatgitter |
| Detektion af læseorden | Regelbaseret (afbryder ved flere kolonner) | ML layout-analyse | Grundlæggende linjegruppering | Dedikeret læseordensmodel |
| Direkte JSON-skemaer | Kræver konvertering | Python-ordbog / JSON | Python-liste / JSON | Typede Pydantic-modeller |
| Ideelt efterfølgende mål | Arkiverings-PDF’er, ældre DMS | Formular-/kvitteringsdata, ERP’er | Hurtige scripts, scenetekst | LLM-indtag, RAG-arkitekturer |
Pipeline-anbefalinger: Hvilken skal du vælge?
- Vælg Tesseract hvis dine overholdelseskrav kræver standardiseret
hOCR,ALTO XMLeller søgbare PDF/A-leverancer til regeringens eller arkivernes dokumenter. - Vælg PaddleOCR hvis du behandler operationelle finansdokumenter (fakturaer, kvitteringer, skatteformularer) indeholdende komplekse, kantløse tabeller, som skal konverteres til HTML eller regneark.
- Vælg EasyOCR hvis du har brug for et letvægts, Pythonisk bibliotek til at opdage og udtrække tekst fra naturlige billeder, vejskilte eller beskårne UI-elementer uden konfigurationsbesvær.
- Vælg Surya OCR hvis du fodrer ustrukturerede forretningsrapporter, forskningsartikler og tekniske vejledninger ind i en LLM eller vektorsøgemaskine, hvor logisk læseorden og rene strukturelle grænser er altafgørende.
Ofte stillede spørgsmål (FAQ)
1. Hvilket open-source OCR-outputformat er lettest at fodre ind i store sprogmodeller?
Surya OCR’s læseordensbevidste JSON og PaddleOCR PP-Structure’s HTML-tabeller leverer de reneste repræsentationer til LLM-promptkontekster og RAG-indeksering.
2. Kan Tesseract producere JSON-svar nativt uden tredjepartsværktøjer?
Nej, Tesseract leverer tekst, TSV, PDF og hOCR/ALTO XML som standard; at producere JSON kræver konvertering af dens TSV- eller hOCR-output ved hjælp af en mellemliggende parser.
3. Hvordan adskiller 4-punkts polygonkoordinater sig fra aksejusterede afgrænsningsbokse?
Aksialt justerede bokse bruger [x, y, width, height] under antagelse af flad tekst, mens 4-punkts polygoner giver fire koordinatpar for præcist at omslutte roterede, skæve eller buede tekstlinjer.
4. Hvilken motor udskriver tabelstrukturer direkte i kode i stedet for løse koordinater?
PaddleOCR’s PP-Structure-modul rekonstruerer detekterede tabelgrænser til komplette HTML-tabel-tags (<table>, <tr>, <td>), hvilket undgår brugerdefineret rumlig matematik.
5. Hvorfor har standard EasyOCR-output svært ved flerkolonne videnskabelige artikler?
EasyOCR identificerer tekstlinjer baseret på lokal nærhed i stedet for global layout-hierarki, hvilket får tekst fra tilstødende kolonner til at blande sig, medmindre de er begrænset af en ekstern layout-motor.