Sidst opdateret: 30 sept., 2026
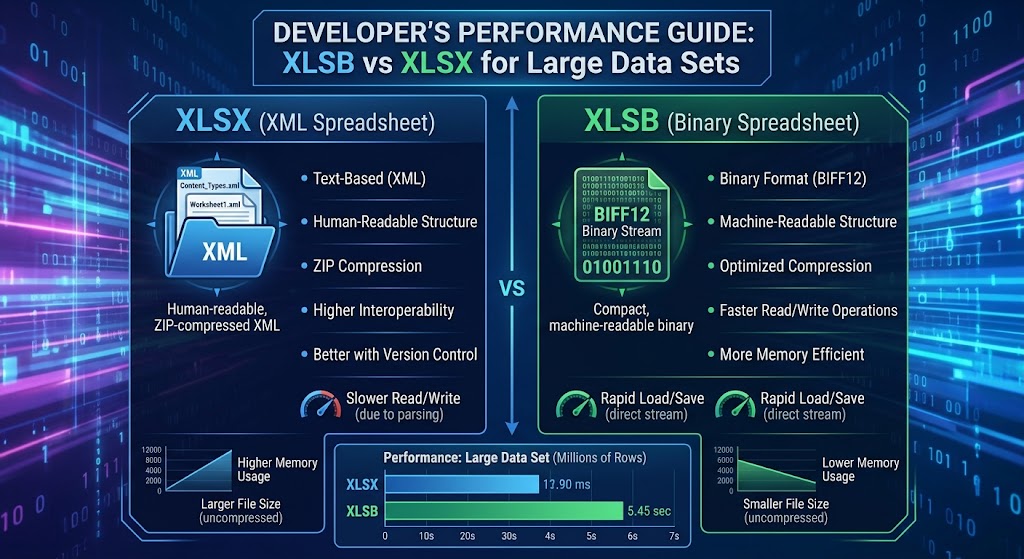
XLSB vs XLSX for store datasæt: En udviklers præstationsguide
Hvis du bygger datapipelines, backend-rapporteringsmotorer eller analyseværktøjer, der interagerer med Microsoft Excel, har du sandsynligvis stødt på “væggen”.
En bruger uploader en 450.000‑rækker arbejdsbog. Din server starter worker‑tråde, hukommelsesforbruget skyder i gigabyte, garbage collection fryser runtime, og din eksekvering får timeout. Du inspicerer payloaden: det er en standard .xlsx-fil.
For at løse dette bruger udviklere ofte dage på at implementere chunking, streaming‑parsers eller at offloade filer til baggrunds‑workers. Alligevel kræver en af de mest effektive optimeringer ingen arkitektonisk redesign: at ændre filendelsen fra .xlsx til .xlsb.
I denne guide dykker vi ned under motorhjelmen på begge formater, undersøger hvorfor deres interne arkitekturer giver radikalt forskellige ydelsesegenskaber, sammenligner konkrete benchmarks på tværs af Python og .NET, og skitserer klare regler for, hvornår man skal implementere binære arbejdsbøger i produktion.
1. Under motorhjelmen: OpenXML vs. BIFF12
For at forstå, hvorfor ydeevnen divergerer så dramatisk på store datasæt, skal vi se på, hvordan hvert format gemmer poster på disken.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Både .xlsx og .xlsb filer er komprimerede ZIP-beholdere, der overholder Open Packaging Conventions (OPC). Hvis du omdøber en af filerne til .zip og udtrækker den, vil du se en velkendt mappeopbygning: _rels, docProps og xl/worksheets/.
Den afgørende forskel ligger i xl/worksheets/ mappen:
- XLSX gemmer ark som ren XML-tekst (
sheet1.xml). - XLSB gemmer ark som proprietære binære strømme (
sheet1.bin), kodet ved hjælp af Microsofts BIFF12 (Binary Interchange File Format 12).
Hvordan XLSX koder data (XML DOM-overhead)
I et XLSX-regneark deklareres hver celle med eksplicitte XML-tags:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Når du læser denne række, skal din runtime:
- Dekomprimer den rå deflate-strøm til tekst.
- Tokeniser og parse tegnstrenge til et XML DOM- eller SAX-hændelsesstrøm.
- Valider åbning- og lukningstags (
<c>,</c>,<v>,</v>). - Løs strengopslag fra en separat
sharedStrings.xml-tabel. - Parse den ASCII-tekst
"98234.55"til et IEEE 754 64-bit flydende-komma tal.
Hver enkelt celle påfører CPU-overhead for strengparsing, strengallokering og leksikalanalyse. Multiplicer dette over 500.000 rækker og 30 kolonner (15 millioner celler), og CPU’en bruger væsentligt flere cyklusser på at parse syntaks end på at behandle domæneværdier.
Hvordan XLSB koder data (BIFF12 binær strøm)
BIFF12 kasserer tekstserialisering fuldstændigt. I stedet for strengmarkup er data arrangeret som en sekventiel sekvens af variabel-længde binære poster:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
En flydende-komma celle i BIFF12 bruger ikke strengrepræsentationer som "98234.55". Den repræsenteres direkte:
- 2 byte til post-ID (f.eks.
BrtCellRkellerBrtCellReal) - 4 byte til kolonne-/rækkeindekser
- 8 bytes indeholdende den rå, IEEE 754 dobbeltpræcisions byte-struktur
Når din parser læser en XLSB-fil, omgår den fuldstændigt leksikalsk parsing. Den læser posthovedet, henter de 8 rå bytes fra bufferen, kopierer dem direkte ind i hukommelsen og flytter pointeren fremad. Der er ingen tags at validere, ingen streng-til-nummer typekonverteringer, og nul UTF-8-dekodningsomkostning for numeriske data.
2. Kvantitative benchmarks: Disk, hukommelse og gennemstrømning
For at illustrere den virkelige påvirkning, overvej et simuleret datasæt indeholdende 750,000 rækker og 25 kolonner (en blanding af tidsstempler, flydende tal, heltal og kategorikoder).
Testene nedenfor evaluerer identiske tabeldata gemt som både XLSX og XLSB.
Testmiljø
- CPU: AMD Ryzen 9 5900X (12 kerner, 24 tråde)
- RAM: 64 GB DDR4-3600
- Lagring: PCIe 4.0 NVMe SSD
- Kørselstid: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Nøglepræstationsmålinger
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Forbedring |
|---|---|---|---|
| Filstørrelse på disk | 128.4 MB | 68.2 MB | ~47% mindre |
| Gem / Serialiseringstid | 42.6 s | 14.1 s | 3.0x hurtigere |
| Læsetid (Python DOM parser) | 38.2 s | 8.9 s | 4.3x hurtigere |
| Læsetid (Rust/C-motor) | 6.4 s | 1.9 s | 3.3x hurtigere |
| Maksimal heap-allokering under læsning | ~1.85 GB | ~510 MB | ~72% reduktion |
Hvorfor XLSB-filer er mindre
Mens begge formater bruger standard ZIP-komprimering, komprimerer binære strømme meget mere effektivt end oppustet XML-tekst:
- Redundant syntax is eliminated: XML indeholder gentagne tags (
<c r=\"AA1\" s=\"1\">) på hver eneste post. Selvom ZIP-komprimering reducerer gentagne strenge, er den ukomprimerede datastrøm enorm. - Numeric density: I XML kræver tallet
12345678.901214 bytes ASCII-tekst. I BIFF12 gemmes det som en 8-byte double (eller pakket ind i en 4-byteRK-record, hvis det passer til specifikke præcisionsregler).
3. Hukommelsesforbrug og pres på affaldsindsamling
For webtjenester og mikrotjenester, der håndterer samtidige anmodninger, er CPU-hastighed kun halvdelen af kampen; hukommelsesfodaftryk er hvor applikationerne faktisk fejler.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Når en XML-parser behandler en 100 MB XLSX-fil, skal den oprette tusindvis af flygtige streng‑tokens, streng‑slice‑buffere og ordbogs‑opslag. I garbage‑collected sprog (Java, C#, Go, Node.js, Python) skaber dette ekstrem heap‑fragmentering og får runtime til at opleve hyppige Garbage Collection (GC)-pauser.
Fordi XLSB-parsing opererer direkte på faste bredde byte-slices, kan parserne læse data ind i stack-allokerede strukturer eller genanvendelige byte-buffere. Resultatet er et dramatisk reduceret hukommelsesfodaftryk og nul thrashing af runtime-allokatoren.
4. Eksempler på implementering for udviklere
Lad os se på, hvordan vi kan udnytte XLSB på tværs af almindelige udviklerværktøjskæder.
Python: Migrering fra OpenPyXL til Calamine / PyXLSB
Standard pandas.read_excel('data.xlsx') falder tilbage på openpyxl, som bygger et tungt in-memory træ.
For at behandle store XLSB-filer med maksimal hastighed, brug den Rust-drevne calamine-motor (tilgængelig via python-calamine og integreret i moderne Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Hvis du itererer over massive datasæt række for række uden at indlæse hele matrixen i en DataFrame, giver pyxlsb en letvægts streaming-iterator:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Højtydende strømindtag
I .NET er biblioteker som ClosedXML eller EPPlus fremragende til standardgenerering, men til indtagelse af store filer uden hukommelsesudtømning er ExcelDataReader med XLSB-understøttelse usædvanligt hurtig:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Arkitektoniske afvejninger: Hvornår SKAL du IKKE bruge XLSB
På trods af sine overvældende ydelsesfordele er XLSB ikke en sølvkugle. Du bør afveje flere operationelle afvejninger, før du implementerer det på tværs af din stack:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Økosystem og biblioteksunderstøttelse
- XLSX: Universel. Praktisk talt hvert sprog, bibliotek, SaaS‑værktøj (Google Sheets, Airtable, Tableau) og webparser understøtter OpenXML nativt.
- XLSB: Mindre udbredt. Mens Excel, LibreOffice og modne udviklerbiblioteker (
ExcelDataReader,pyxlsb,calamine,Aspose) understøtter det, har mange letvægtspakker eller rene webbaserede JavaScript‑parsere (som ældre builds afSheetJS) begrænset eller kun‑læse support.
2. Git & versionskontrol-diffing
- XLSX: Fordi den indeholder tekst‑XML inde i en ZIP‑container, kan kommandolinjeværktøjer og Git‑hooks udpakke og formatere XML’en for at generere læsbare strukturelle diff‑filer mellem commits.
- XLSB: Ren binær data. Versionskontrolsystemer behandler den strengt som en uigennemsigtig binær blob, hvilket eliminerer enhver mulighed for granular diffing eller linjeniveau‑sammenfletninger.
3. Webklient-gengivelse
Hvis din arkitektur er afhængig af at gengive regneark direkte i browseren via WebAssembly eller klient‑side JavaScript, er XLSX‑parsere betydeligt mere modne og mindre tilbøjelige til kant‑case renderingsfejl end klient‑side binære parsere.
4. Tredjeparts indtags-pipelines
Hvis du eksporterer filer til eksterne virksomhedskunder, markerer mange strenge virksomhedssikkerhedspolitikker .xlsb-filer. Da BIFF12-filer kan gemme VBA-makroer på samme måde som .xlsm-filer (uden at kræve en separat filtype), karantæner nogle mailfiltre og firewall-scannere .xlsb-uploads som potentielle trusler, der indeholder makroer.
6. Sammenfatningssammenligning: Hvilket format vinder?
| Funktion | XLSX | XLSB | Vinder |
|---|---|---|---|
| Læs / Parse-hastighed | Moderat til dårlig | Ekstremt hurtig | XLSB |
| Skriv / Genereringshastighed | CPU-intensiv | Hurtig | XLSB |
| Filkomprimering | God | Fremragende (~40-50% mindre) | XLSB |
| Hukommelsesallokering | Høj (Stor GC-tryk) | Lav (Direkte byte-læsning) | XLSB |
| Værktøjsinteroperabilitet | Universel | Høj, men selektiv | XLSX |
| Friktion ved sikkerhedsscanning | Minimal | Tilfældige falske positiver | XLSX |
| Makrofunktion | Ingen (.xlsm påkrævet) | Ja (understøtter makroer indbygget) | Uafgjort |
7. Udviklerens dom
Brug XLSX når:
- Filer er små til moderate i størrelse (< 50.000 rækker).
- Dine filer skal indlæses af tredjeparts SaaS-platforme eller forbruger‑apps (f.eks. Google Sheets).
- Du kan ikke kontrollere miljøet for den endelige klient, der læser filen.
Skift til XLSB når:
- Du bygger interne pipelines, batch‑jobs, ETL‑systemer eller arbejdsopgaver, der håndterer massive dataudtræk (> 100.000 rækker).
- Dine servere får out-of-memory (OOM) fejl under serialisering eller deserialisering af regneark.
- Du skal minimere S3/blob-lagringsaftryk og netværksoverførselstid for store tilbagevendende finansielle modeller eller dataeksport.
Skiftet til XLSB er ofte så enkelt som at ændre en konfigurationsstreng i din eksportservice, men det leverer den slags 3x til 5x gennemstrømningsforbedringer, som normalt kræver uger med kodeoptimering.
Ofte stillede spørgsmål (FAQ)
**Q1: Understøtter en XLSB fil de nøjagtigt samme række- og kolonnegrænser som en XLSX fil? Ja; både XLSB og XLSX deler den nøjagtige samme gittergrænse på 1,048,576 rækker og 16,384 kolonner pr. regneark.
**Q2: Kan en XLSB-fil sikkert gemme VBA-makroer uden at ændre dens filendelse?
Ja, i modsætning til XLSX (som kræver at gemmes som XLSM for at køre kode), understøtter XLSB binær VBA-makrolagring nativt inden i det samme .xlsb filformat.
**Q3: Hvorfor reducerer gemning af en fil som XLSB dens størrelse, hvis begge formater allerede er ZIP-komprimeret? XLSB eliminerer omstændelige tekstmærknings‑tags og koder cellepositioner, poster og rå numeriske værdier i kompakte binære byte‑strømme, som komprimerer langt tættere end almindelige XML‑strenge.
**Q4: Kan Google Sheets importere og redigere XLSB‑filer direkte?
Nej; Google Sheets kan ikke åbne eller konvertere .xlsb‑filer direkte, så du er nødt til at konvertere dem til .xlsx eller CSV, før du importerer dem.
**Q5: Er XLSB‑filer mere udsatte for datakorruption end XLSX‑filer? Selvom XML‑filer nogle gange kan inspiceres eller repareres manuelt med en teksteditor, når de er delvist korrupte, kræver binære BIFF12‑strømme strenge byte‑offsets og er svære at gendanne manuelt, hvis strukturelle sektorer er beskadigede.