Zuletzt aktualisiert: 20 Aug, 2026
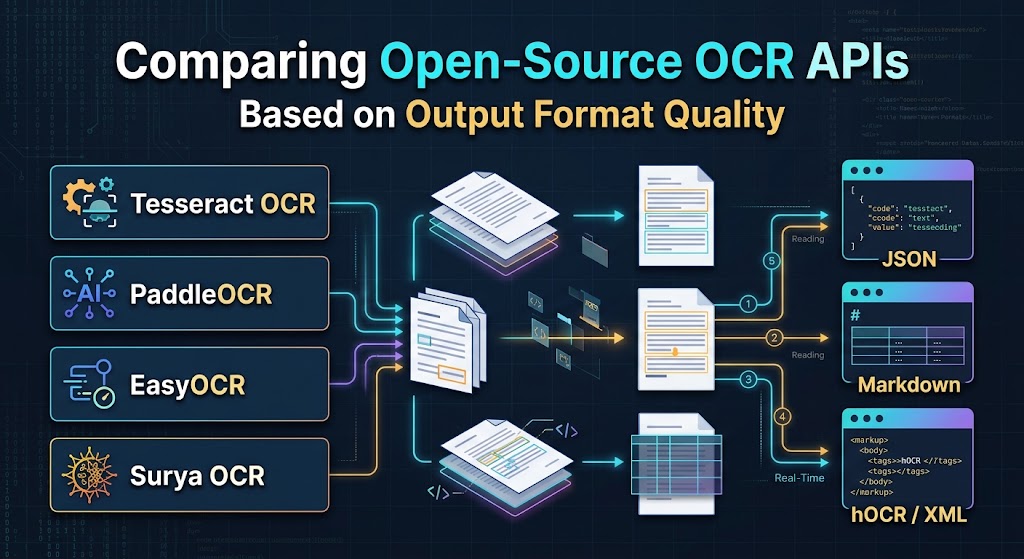
Vergleich von Open-Source-OCR-APIs basierend auf der Qualität der Ausgabeformate
Wenn Ingenieure Optical Character Recognition (OCR)-Engines bewerten, dominieren normalerweise die Zeichenfehlerquote (CER) und die Wortfehlerquote (WER) die Benchmarks. Während die Erkennungsgenauigkeit entscheidend ist, löst sie nur die Hälfte des Problems in der Produktion.
Wenn Sie komplexe mehrspaltige PDFs parsen, Positionen aus Quittungen extrahieren oder Whitepapers in eine LLM-Embedding-Pipeline einlesen, erzeugen rohe Textausgaben einen enormen Engineering-Aufwand. Eine Zeichenkette ohne Layout-Bewusstsein, logische Lesereihenfolge oder Koordinatendaten zwingt Ihr Team, fragile heuristische Parser zu schreiben.
Der wahre Unterschiedsfaktor für moderne Dokumenten-Workflows ist Ausgabeformatqualität: wie konsistent und sauber eine Engine Koordinaten, Lesereihenfolge, strukturelle Hierarchie und Tabellendaten liefert.
Unten finden Sie einen ingenieur-fokussierten Vergleich von vier führenden Open-Source-OCR-Engines—Tesseract, PaddleOCR, EasyOCR und Surya OCR—die bewerten, wie sich ihre Ausgaben innerhalb automatisierter Pipelines verhalten.
Die gängigen Ausgabeformate: Was Ingenieure wirklich benötigen
Jede OCR-API verpackt den erkannten Text unterschiedlich. Das Verständnis dieser Formate hilft dabei, zu bestimmen, wie viel Nachbearbeitung Ihre Pipeline erfordert:
- Plain Text (
.txt): Die einfachste Darstellung. Sie entfernt alle positionsbezogenen Metadaten und reduziert mehrspaltige Layouts zu horizontalen Lesefluss, was Absätze durcheinanderbringen kann. - Archival Standards (
hOCR,ALTO XML): XML/HTML-basierte Formate, die im Bibliotheksarchivierungsbereich Standard sind. Sie betten Koordinaten, Schriftartenschätzungen und Vertrauenswerte in DOM‑Knoten ein. Äußerst robust für die Dokumentrekonstruktion, aber sperrig für Microservices. - Structured JSON: Die Standardwahl für moderne Web‑Backends. Liefert Koordinaten‑Arrays (Bounding‑Boxes oder Polygone), Vertrauenswerte und hierarchische Block‑/Zeilen‑/Wort‑Strukturen.
- Markdown (
.md) / HTML‑Tabellen: Der moderne Standard für Retrieval‑Augmented Generation (RAG). Bewahrt semantische Abschnitte (Überschriften, Listen, Fettschrift) und tabellarische Matrizen, ohne dass eine nachgelagerte räumliche Rekonstruktion erforderlich ist.
1. Tesseract OCR
Von Google gepflegt, bleibt Tesseract das grundlegende Arbeitspferd der Open‑Source‑OCR. Seine Architektur stützt sich stark auf traditionelle Seitensegmentierungs‑Algorithmen, ergänzt durch eine LSTM‑basierte Zeichen‑Engine.
Native Ausgabeformate
- Primäre Ausgaben: Klartext, hOCR (HTML), ALTO XML, TSV (Tab-getrennte Werte) und durchsuchbare PDF/A.
- Layout‑Bewusstsein: Regelbasierte Heuristiken über Seitensegmentierungsmodi (PSM).
Analyse des Ausgabeformats
- Wo es glänzt: Die
TSV- undhOCR-Exporte von Tesseract sind standardisiert und vorhersehbar. Ein einzelner TSV-Export liefert strukturierte Spalten fürlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightundconf. Wenn Sie Papierarchive in durchsuchbare PDFs konvertieren oder strenge Einhaltung institutioneller Standards benötigen, verarbeitet Tesseract dies nativ ohne benutzerdefinierten Glue‑Code. - Wo es schwächelt: Tesseract hat keine native JSON‑API. Die Nutzung seiner Ausgabe in Python oder Node.js erfordert das Parsen von XML/TSV‑Dateien oder die Verwendung von Wrappern wie
pytesseract. Seine Layout‑Engine hat zudem Schwierigkeiten mit nicht‑standardisiertem Spaltenfluss und mischt häufig Text aus benachbarten Spalten, sofern keine manuellen Begrenzungs‑Ausschnitte bereitgestellt werden.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Unterstützt vom PaddlePaddle‑Framework von Baidu, hat PaddleOCR dank seiner leichten Modelle, umfangreichen mehrsprachigen Abdeckung und des dedizierten Dokumentenanalysetoolkits (PP-Structure) breite Akzeptanz gefunden.
Native Ausgabeformate
- Primäre Ausgaben: Python-Listen/Dictionaries, rohes JSON, Visualisierungs-Overlays und strukturiertes HTML über PP-Structure.
- Layout-Bewusstsein: Hoch (unter Verwendung von Deep-Learning-Modellen für Layout-Parsing, Orientierungsklassifizierung und Tabellenerholung).
Analyse des Ausgabeformats
- Wo es glänzt: Standard PaddleOCR gibt 4-Punkt-Polygonkoordinaten (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) zusammen mit Textzeichenketten und Konfidenzwerten zurück. Dies verarbeitet schiefe oder gekrümmte Texte elegant. Die eigentliche Stärke liegt jedoch in der PP-Structure-Suite, die Layout‑Regionen (Titel, Text, Tabelle, Abbildung) erkennt und Tabellen direkt in gültige HTML‑Strings (<table>...</table>) parst. Dadurch entfällt die Notwendigkeit, Zellspannungen manuell aus Begrenzungsrahmen zu berechnen. - Wo es Schwächen hat: Die Basis‑API liefert verschachtelte Arrays, denen in verschiedenen Versionen standardisierte Eigenschaftsschlüssel fehlen. Für strukturierte Anwendungen schreiben Entwickler in der Regel einen Zwischenadapter, um Feldnamen zu standardisieren (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Auf PyTorch von JaidedAI basierend, ist EasyOCR für eine schnelle Entwickler‑Adoption konzipiert. Es bündelt CRAFT (Character Region Awareness for Text Detection) mit Deep‑Learning‑Erkennungsnetzwerken zu einer minimalen API.
Native Ausgabeformate
- Primäre Ausgaben: Python-Listen, die Tupel von Koordinaten, erkannten Zeichenketten und Vertrauenswerten enthalten.
- Layout-Bewusstsein: Niedrig bis moderat (nur Zeilenerkennung; keine strukturelle Analyse auf Dokumentebene).
Analyse des Ausgabeformats
- Wo es glänzt: Die Einfachheit des Rückgabeobjekts ist unübertroffen:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Die Zuordnung dieser Ausgabe zu einer standardmäßigen REST-Antwort oder die direkte Serialisierung in GeoJSON/benutzerdefinierte Schemata erfordert nur wenige Codezeilen. Es funktioniert zuverlässig bei natürlichem Szenentext, Kfz-Kennzeichen und isolierten Dokumentausschnitten.
- Wo es Schwächen hat: EasyOCR führt keine ganzheitliche Dokumentenlayout-Analyse durch. Es erkennt keine Tabellen, Überschriftenhierarchien oder Lesereihenfolgen in komplexen Spalten. Der Einsatz von EasyOCR auf einem zweispaltigen wissenschaftlichen Artikel erzeugt häufig verflochtene Textfragmente, sofern nicht ein vorgelagertes Layout-Erkennungsmodell (wie YOLO oder LayoutLM) verwendet wird.
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya ist ein modernes Deep-Learning-OCR-Framework, das speziell für das Verständnis komplexer Dokumente und LLM‑Ingest‑Pipelines entwickelt wurde.
Native Ausgabeformate
- Primäre Ausgaben: Pydantic-modellierte JSON-Strukturen, logische Lesereihenfolgen‑Indizes, Layout‑Begrenzungsregionen und Linienerkennungs‑Polygone.
- Layout-Bewusstsein: Außerordentlich hoch (deep-learning-basierte Layout-Analyse und Sortierung der Lesereihenfolge).
Analyse des Ausgabeformats
- Wo es glänzt: Surya adressiert direkt die Herausforderungen moderner KI-Entwicklung. Anstatt anzunehmen, dass Dokumente von oben nach unten, von links nach rechts gelesen werden, setzt Surya ein dediziertes Modell ein, um die Lesereihenfolge vorherzusagen. Es gruppiert Zeilen in logische semantische Blöcke, verarbeitet mehrspaltige Bereiche natürlich und gibt typisierte Strukturen über Pydantic aus. Das ermöglicht eine direkte und zuverlässige Weiterverarbeitung in Vektordatenbanken und Markdown-Konvertern.
- Wo es Schwächen hat: Als ein neueres, schwereres PyTorch‑basiertes Framework benötigt Surya dedizierte GPU‑Rechenleistung, um den Durchsatz optimierter C++‑Engines wie Tesseract oder quantisierter Paddle‑Modelle zu erreichen. Es richtet sich nicht an ältere Archivierungsstandards wie hOCR oder ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Direkter Vergleichs-Matrix
| Fähigkeit / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Native hOCR / ALTO XML | Native Unterstützung | Nur Drittanbieter | Keine | Keine |
| Bounding-Box-Geometrie | Achsenbasiert (x, y, w, h) | 4‑Punkte-Polygon | 4‑Punkte-Polygon | Polygon + Layout‑Blöcke |
| Tabellenparsing | Nur Koordinaten-TSV | HTML-Tabellenzeichenketten | Keine | Zellkoordinatengitter |
| Erkennung der Lesereihenfolge | Regelbasiert (bricht bei mehrspaltig) | ML-Layout-Analyse | Einfache Zeilengruppierung | Dediziertes Lese‑Reihenfolgemodell |
| Direkte JSON‑Schemata | Erfordert Konvertierung | Python‑Dict / JSON | Python‑Liste / JSON | Typisierte Pydantic‑Modelle |
| Ideales nachgelagertes Ziel | Archiv‑PDFs, Legacy‑DMS | Formular-/Belegdaten, ERP-Systeme | Schnellskripte, Szenentext | LLM-Einlesung, RAG-Architekturen |
Pipeline-Empfehlungen: Welche sollten Sie wählen?
- Wählen Sie Tesseract wenn Ihre Compliance-Anforderungen standardisierte
hOCR,ALTO XMLoder durchsuchbare PDF/A‑Lieferungen für Regierungs- oder Archivunterlagen verlangen. - Wählen Sie PaddleOCR wenn Sie operative Finanzdokumente (Rechnungen, Belege, Steuerformulare) verarbeiten, die komplexe, randlose Tabellen enthalten, die in HTML oder Tabellenkalkulationen konvertiert werden müssen.
- Wählen Sie EasyOCR wenn Sie eine leichte, pythonische Bibliothek benötigen, um Text aus natürlichen Bildern, Straßenschildern oder zugeschnittenen UI-Elementen ohne Konfigurationsaufwand zu erkennen und zu extrahieren.
- Wählen Sie Surya OCR wenn Sie unstrukturierte Geschäftsberichte, Forschungsarbeiten und technische Handbücher in ein LLM oder eine Vektorsuchmaschine einspeisen, bei denen logische Lesereihenfolge und klare strukturelle Grenzen von größter Bedeutung sind.
Häufig gestellte Fragen (FAQ)
1. Welches Open-Source-OCR-Ausgabeformat lässt sich am einfachsten in Large Language Models einspeisen?
Surya OCRs leseordnungsbewusstes JSON und PaddleOCRs PP‑Structure‑HTML‑Tabellen bieten die saubersten Darstellungen für LLM‑Prompt‑Kontexte und RAG‑Indexierung.
2. Kann Tesseract JSON-Antworten nativ ohne Drittanbieter-Tools erzeugen?
Nein, Tesseract gibt Text, TSV, PDF und hOCR/ALTO XML nativ aus; die Erzeugung von JSON erfordert die Umwandlung seiner TSV- oder hOCR-Ausgabe mittels eines Zwischenschritts‑Parsers.
3. Wie unterscheiden sich 4-Punkt-Polygonkoordinaten von achsenbasierten Begrenzungsrahmen?
Achsenparallel ausgerichtete Rechtecke verwenden [x, y, width, height] und gehen von flachem Text aus, während 4‑Punkt‑Polygone vier Koordinatenpaare bereitstellen, um gedrehte, schiefe oder gekrümmte Textzeilen exakt zu umschließen.
4. Welche Engine gibt Tabellenstrukturen direkt in Code aus, anstatt lose Koordinaten?
Das PP‑Structure‑Modul von PaddleOCR rekonstruiert erkannte Tabellengrenzen zu vollständigen HTML‑Tabellen‑Tags (<table>, <tr>, <td>), wodurch benutzerdefinierte räumliche Berechnungen vermieden werden.
5. Warum hat die Standardausgabe von EasyOCR Schwierigkeiten bei mehrspaltigen wissenschaftlichen Papieren?
EasyOCR erkennt Textzeilen anhand lokaler Nähe statt einer globalen Layout‑Hierarchie, wodurch Texte aus benachbarten Spalten miteinander vermischt werden, sofern sie nicht von einer externen Layout‑Engine begrenzt werden.