Zuletzt aktualisiert: 30. Sept, 2026
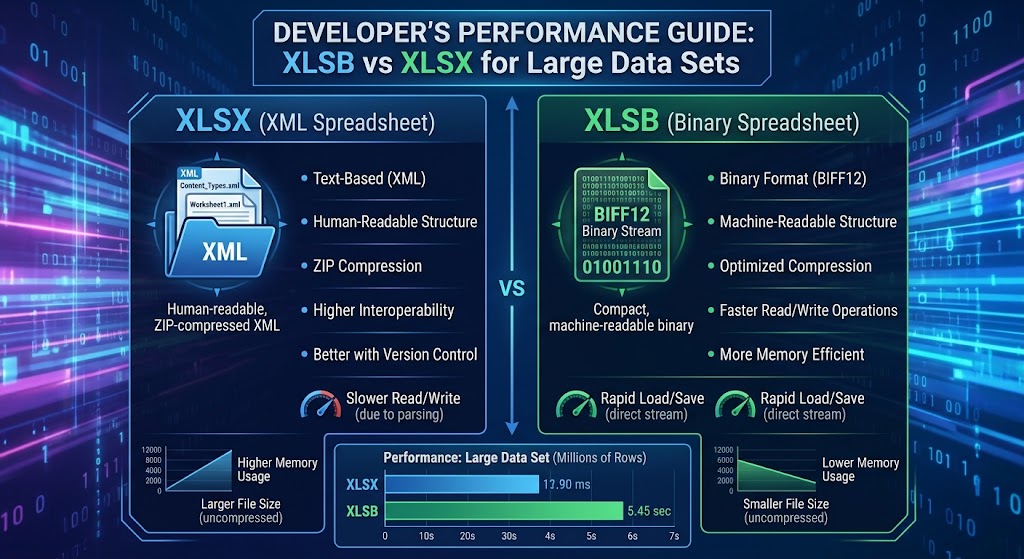
XLSB vs XLSX für große Datensätze: Ein Performance-Leitfaden für Entwickler
Wenn Sie Datenpipelines, Backend-Reporting-Engines oder Analyse-Tools bauen, die mit Microsoft Excel interagieren, sind Sie wahrscheinlich an "die Wand" gestoßen.
Ein Benutzer lädt eine Arbeitsmappe mit 450.000 Zeilen hoch. Ihr Server startet Worker-Threads, der Speicherverbrauch schießt in den Gigabyte‑Bereich, die Garbage Collection friert die Laufzeit ein, und Ihre Ausführung läuft ab. Sie prüfen die Nutzlast: Es ist eine Standard-.xlsx‑Datei.
Um dies zu lösen, verbringen Entwickler oft Tage damit, Chunking, Streaming‑Parser zu implementieren oder Dateien in Hintergrund‑Worker auszulagern. Dennoch erfordert eine der effektivsten Optimierungen keinerlei architektonische Neugestaltung: das Ändern der Dateierweiterung von .xlsx zu .xlsb.
In diesem Leitfaden tauchen wir unter die Haube beider Formate, untersuchen, warum ihre internen Architekturen radikal unterschiedliche Leistungsmerkmale erzeugen, vergleichen konkrete Benchmarks für Python und .NET und skizzieren klare Regeln dafür, wann binäre Arbeitsmappen in der Produktion eingesetzt werden sollten.
1. Hinter den Kulissen: OpenXML vs. BIFF12
Um zu verstehen, warum die Leistung bei großen Datensätzen so dramatisch divergiert, müssen wir betrachten, wie jedes Format Datensätze auf der Festplatte speichert.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Sowohl .xlsx- als auch .xlsb-Dateien sind komprimierte ZIP-Container, die den Open Packaging Conventions (OPC) entsprechen. Wenn Sie eine der Dateien in .zip umbenennen und extrahieren, sehen Sie eine vertraute Verzeichnisstruktur: _rels, docProps und xl/worksheets/.
Der entscheidende Unterschied liegt im Ordner xl/worksheets/:
- XLSX speichert Tabellenblätter als reinen XML-Text (
sheet1.xml). - XLSB speichert Tabellenblätter als proprietäre Binärströme (
sheet1.bin), codiert mit Microsofts BIFF12 (Binary Interchange File Format 12).
Wie XLSX Daten kodiert (XML DOM Overhead)
In einem XLSX-Arbeitsblatt wird jede Zelle mit expliziten XML-Tags deklariert:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Beim Lesen dieser Zeile muss Ihre Laufzeit:
- Den rohen Deflate-Stream in Text dekomprimieren.
- Die Zeichenkette tokenisieren und in einen XML-DOM oder SAX-Ereignisstrom parsen.
- Validieren Sie Öffnungs- und Schließtags (
<c>,</c>,<v>,</v>). - Lösen Sie String‑Nachschlagen aus einer separaten
sharedStrings.xml‑Tabelle. - Parsen Sie den ASCII‑Text
"98234.55"in eine IEEE‑754‑64‑Bit‑Gleitkommazahl.
Jede einzelne Zelle verursacht CPU‑Overhead für das Parsen von Zeichenketten, die Speicherzuweisung von Zeichenketten und die lexikalische Analyse. Multipliziert man das über 500.000 Zeilen und 30 Spalten (15 Millionen Zellen), verbraucht die CPU bei weitem mehr Zyklen für das Parsen der Syntax als für die Verarbeitung von Domänenwerten.
Wie XLSB Daten kodiert (BIFF12 Binary Stream)
BIFF12 verwirft die Textserialisierung vollständig. Anstelle von String‑Markup werden Daten als sequenzielle Folge variabler Binärdatensätze angeordnet:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Eine Gleitkommazelle in BIFF12 verwendet keine String‑Darstellungen wie "98234.55". Sie wird direkt dargestellt:
- 2 Byte für die Record‑ID (z. B.
BrtCellRkoderBrtCellReal) - 4 Byte für Spalten‑/Zeilen‑Indizes
- 8 Bytes, die die rohen, IEEE‑754‑Double‑Precision‑Byte‑Struktur enthalten
Wenn Ihr Parser eine XLSB‑Datei liest, umgeht er die lexikalische Analyse vollständig. Er liest den Record‑Header, holt die 8 rohen Bytes aus dem Puffer, kopiert sie direkt in den Speicher und verschiebt den Zeiger nach vorne. Es gibt keine Tags zu validieren, keine String‑zu‑Zahl‑Typkonvertierungen und keinen UTF‑8‑Dekodierungsaufwand für numerische Daten.
2. Quantitative Benchmarks: Festplatte, Speicher und Durchsatz
Um die reale Auswirkung zu veranschaulichen, betrachten Sie einen simulierten Datensatz, der 750.000 Zeilen und 25 Spalten enthält (eine Mischung aus Zeitstempeln, Gleitkommazahlen, Ganzzahlen und Kategoriekodes).
Die nachfolgenden Tests bewerten identische tabellarische Daten, die sowohl als XLSX als auch als XLSB gespeichert wurden.
Testumgebung
- CPU: AMD Ryzen 9 5900X (12 Kerne, 24 Threads)
- RAM: 64 GB DDR4‑3600
- Speicher: PCIe 4.0 NVMe SSD
- Laufzeit: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Wichtige Leistungskennzahlen
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Verbesserung |
|---|---|---|---|
| Dateigröße auf Festplatte | 128.4 MB | 68.2 MB | ~47% kleiner |
| Speichern / Serialisierungszeit | 42.6 s | 14.1 s | 3,0‑fach schneller |
| Lesezeit (Python DOM‑Parser) | 38.2 s | 8.9 s | 4,3‑fach schneller |
| Lesezeit (Rust/C-Engine) | 6.4 s | 1.9 s | 3,3‑fach schneller |
| Spitzen-Heap-Allocation während des Lesens | ~1.85 GB | ~510 MB | ~72 % Reduktion |
Warum XLSB-Dateien kleiner sind
Während beide Formate die Standard‑ZIP‑Kompression verwenden, komprimieren Binärströme viel effizienter als aufgeblähter XML‑Text:
- Redundante Syntax wird eliminiert: XML enthält wiederholende Tags (
<c r="AA1" s="1">) in jedem einzelnen Datensatz. Während die ZIP‑Kompression wiederholte Zeichenketten reduziert, ist der unkomprimierte Datenstrom enorm. - Numerische Dichte: In XML benötigt die Zahl
12345678.901214 Bytes ASCII‑Text. In BIFF12 wird sie als 8‑Byte‑Double gespeichert (oder in einen 4‑Byte‑RK‑Record gepackt, wenn sie den spezifischen Präzisionsregeln entspricht).
3. Speicherverbrauch und Garbage-Collection-Druck
Für Web‑Services und Microservices, die gleichzeitige Anfragen bearbeiten, ist die CPU‑Geschwindigkeit nur die halbe Miete; Speicherverbrauch ist der Punkt, an dem Anwendungen tatsächlich scheitern.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Wenn ein XML‑Parser eine 100 MB‑XLSX‑Datei verarbeitet, muss er Tausende flüchtiger String‑Token, String‑Slice‑Puffer und Wörterbuch‑Lookups erzeugen. In garbage‑collected Sprachen (Java, C#, Go, Node.js, Python) führt dies zu extremer Heap‑Fragmentierung und zwingt die Laufzeit zu häufigen Garbage‑Collection‑(GC‑)Pausen.
Da die XLSB‑Analyse direkt auf festbreiten Byte‑Slices arbeitet, können Parser Daten in stack‑zugewiesene Strukturen oder wiederverwendbare Byte‑Puffer einlesen. Das Ergebnis ist ein dramatisch reduzierter Speicherverbrauch und kein Thrashing des Laufzeit‑Allocators.
4. Entwickler-Implementierungsbeispiele
Betrachten wir, wie man XLSB in gängigen Entwickler‑Toolchains nutzt.
Python: Migration von OpenPyXL zu Calamine / PyXLSB
Standard pandas.read_excel('data.xlsx') verwendet standardmäßig openpyxl, das einen schweren In‑Memory‑Baum aufbaut.
Um große XLSB‑Dateien mit maximaler Geschwindigkeit zu verarbeiten, verwenden Sie die Rust‑basierte calamine‑Engine (verfügbar über python-calamine und in moderne Pandas integriert):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Wenn Sie massive Datensätze zeilenweise iterieren, ohne die gesamte Matrix in ein DataFrame zu laden, bietet pyxlsb einen leichtgewichtigen Streaming‑Iterator:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Hochleistungs-Stream-Einlesung
In .NET sind Bibliotheken wie ClosedXML oder EPPlus hervorragend für die Standard‑Erzeugung, aber zum Einlesen großer Dateien ohne Speichererschöpfung ist ExcelDataReader mit XLSB‑Unterstützung außergewöhnlich schnell:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Architektonische Kompromisse: Wann man XLSB NICHT verwenden sollte
Trotz seiner überwältigenden Leistungsvorteile ist XLSB kein Allheilmittel. Sie sollten mehrere betriebliche Kompromisse abwägen, bevor Sie es in Ihrem gesamten Stack einsetzen:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ökosystem- und Bibliotheksunterstützung
- XLSX: Universell. Praktisch jede Sprache, Bibliothek, SaaS‑Tool (Google Sheets, Airtable, Tableau) und Web‑Parser unterstützen OpenXML nativ.
- XLSB: Weniger verbreitet. Während Excel, LibreOffice und etablierte Entwicklerbibliotheken (
ExcelDataReader,pyxlsb,calamine,Aspose) es unterstützen, haben viele leichtgewichtige Pakete oder reine webbasierte JavaScript‑Parser (wie ältere Builds vonSheetJS) nur eingeschränkte oder Nur‑Lese‑Unterstützung.
2. Git- & Versionskontroll-Diffing
- XLSX: Da es Text‑XML in einem ZIP‑Container enthält, können Befehlszeilen‑Werkzeuge und Git‑Hooks das ZIP entpacken und das XML formatieren, um lesbare strukturelle Unterschiede zwischen Commits zu erzeugen.
- XLSB: Reine Binärdaten. Versionskontrollsysteme behandeln es strikt als undurchsichtigen Binärblob, wodurch jede Möglichkeit für feinkörnige Diffs oder Zeilen‑Level‑Merges entfällt.
3. Web-Client-Rendering
Wenn Ihre Architektur darauf angewiesen ist, Tabellenkalkulationen direkt im Browser über WebAssembly oder client‑seitiges JavaScript zu rendern, sind XLSX‑Parser deutlich ausgereifter und weniger anfällig für Randfall‑Rendering‑Fehler als client‑seitige Binär‑Parser.
4. Drittanbieter-Einlesepipelines
Wenn Sie Dateien für externe Unternehmensklienten exportieren, kennzeichnen viele strenge Unternehmenssicherheitsrichtlinien .xlsb-Dateien. Da BIFF12-Dateien VBA-Makros genauso wie .xlsm-Dateien speichern können (ohne eine separate Erweiterung zu benötigen), quarantänisieren einige Mailfilter und Firewall-Scanner .xlsb-Uploads als potenzielle makrohaltige Bedrohungen.
6. Zusammenfassender Vergleich: Welches Format gewinnt?
| Funktion | XLSX | XLSB | Gewinner |
|---|---|---|---|
| Lese- / Analysegeschwindigkeit | Mäßig bis schlecht | Blitzschnell | XLSB |
| Schreib- / Generierungsgeschwindigkeit | CPU-intensiv | Schnell | XLSB |
| Dateikomprimierung | Gut | Ausgezeichnet (~40-50% kleiner) | XLSB |
| Speicherzuweisung | Hoch (Starker GC-Druck) | Niedrig (Direktes Byte-Lesen) | XLSB |
| Tooling Interoperabilität | Universell | Hoch, aber selektiv | XLSX |
| Sicherheits-Scanning-Reibung | Minimal | Gelegentliche Fehlalarme | XLSX |
| Makro-Fähigkeit | Nein (.xlsm erforderlich) | Ja (unterstützt Makros nativ) | Unentschieden |
7. Das Urteil des Entwicklers
Verwenden Sie XLSX, wenn:
- Dateien sind klein bis mittelgroß (< 50.000 Zeilen).
- Ihre Dateien müssen von Drittanbieter‑SaaS‑Plattformen oder Verbraucher‑Apps (z. B. Google Sheets) verarbeitet werden.
- Sie können die Umgebung des Endkunden, der die Datei liest, nicht kontrollieren.
Wechseln Sie zu XLSB, wenn:
- Sie erstellen interne Pipelines, Batch‑Jobs, ETL‑Systeme oder Worker‑Aufgaben, die massive Datenextrakte (> 100.000 Zeilen) verarbeiten.
- Ihre Server stoßen während der Serialisierung oder Deserialisierung von Tabellenkalkulationen auf Out-of-Memory (OOM)-Fehler.
- Sie müssen den Speicherplatzverbrauch von S3/Blob-Speicher und die Netzwerkübertragungszeit für große wiederkehrende Finanzmodelle oder Datenexporte minimieren.
Der Wechsel zu XLSB ist oft so einfach wie das Ändern einer Konfigurationszeichenfolge in Ihrem Exportservice, liefert jedoch Durchsatzsteigerungen von 3‑ bis 5‑fach, die normalerweise Wochen an Code‑Optimierung erfordern.
Häufig gestellte Fragen (FAQ)
**Q1: Unterstützt eine XLSB Datei exakt dieselben Zeilen- und Spaltenbeschränkungen wie eine XLSX Datei? Ja; sowohl XLSB als auch XLSX haben dieselbe maximale Rastergröße von 1.048.576 Zeilen und 16.384 Spalten pro Arbeitsblatt.
**Q2: Kann eine XLSB-Datei VBA-Makros sicher speichern, ohne die Dateierweiterung zu ändern?
Ja, im Gegensatz zu XLSX (das zum Ausführen von Code als XLSM gespeichert werden muss), unterstützt XLSB die native Speicherung binärer VBA‑Makros im selben .xlsb‑Dateiformat.
**Q3: Warum reduziert das Speichern einer Datei als XLSB ihre Größe, obwohl beide Formate bereits ZIP-komprimiert sind? XLSB eliminiert ausführliche Textauszeichnungstags und codiert Zellpositionen, Datensätze und rohe numerische Werte in kompakte binäre Bytestreams, die viel dichter komprimieren als einfache XML‑Zeichenketten.
**Q4: Kann Google Sheets XLSB-Dateien direkt importieren und bearbeiten?
Nein; Google Sheets kann .xlsb‑Dateien nicht nativ öffnen oder direkt konvertieren, sodass Sie sie vor dem Import in .xlsx oder CSV umwandeln müssen.
**Q5: Sind XLSB-Dateien anfälliger für Datenkorruption als XLSX-Dateien? Während XML‑Dateien manchmal manuell mit einem Texteditor inspiziert oder repariert werden können, wenn sie teilweise beschädigt sind, erfordern binäre BIFF12‑Streams strenge Byte‑Offsets und sind schwer manuell wiederherzustellen, wenn strukturelle Sektoren beschädigt sind.
Siehe auch
- CSV vs XLSX vs ODS im Jahr 2026: Bestes Tabellenkalkulationsformat für Entwickler
- XLS vs XLSX vs XLSM vs XLSB – Auswahl des richtigen Tabellenkalkulationsformats
- Was ist Excel? Wichtige Informationen, die Sie wissen müssen
- Excel-Dateiformate: XLSX, XLSM, XLS, XLTX, XLTM
- Unterschied zwischen XLS und XLSX