Τελευταία Ενημέρωση: 30 Σεπ, 2026
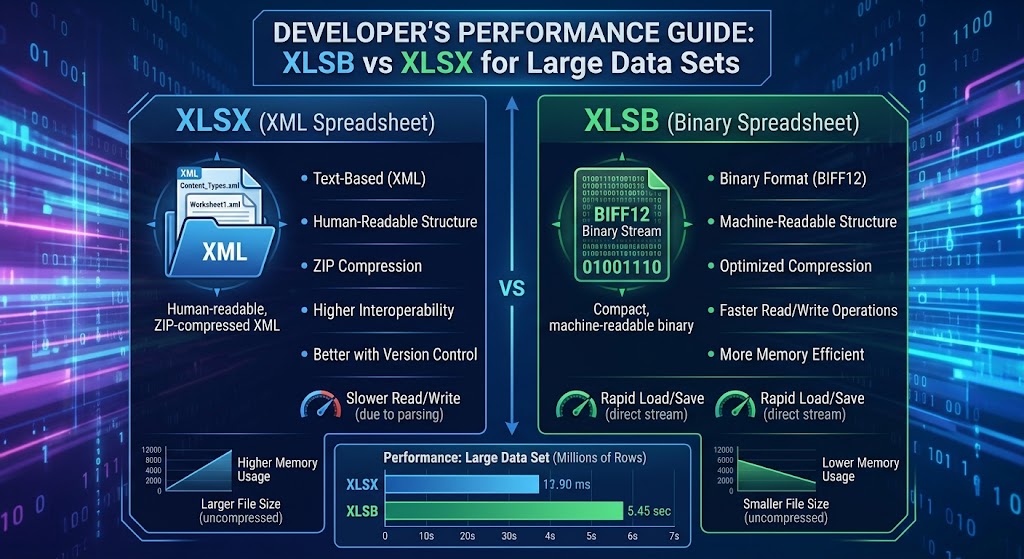
XLSB vs XLSX για Μεγάλα Σύνολα Δεδομένων: Οδηγός Απόδοσης για Προγραμματιστές
Αν δημιουργείτε αγωγούς δεδομένων, μηχανές αναφοράς backend ή εργαλεία ανάλυσης που αλληλεπιδρούν με το Microsoft Excel, πιθανότατα έχετε συναντήσει “το εμπόδιο”.
Ένας χρήστης ανεβάζει ένα βιβλίο εργασίας με 450.000 γραμμές. Ο διακομιστής σας δημιουργεί νήματα εργασίας, η κατανάλωση μνήμης αυξάνεται σε gigabytes, η συλλογή απορριμμάτων παγώνει το runtime, και η εκτέλεσή σας λήγει. Εξετάζετε το payload: είναι ένα τυπικό αρχείο .xlsx.
Για να το λύσετε, οι προγραμματιστές συχνά ξοδεύουν ημέρες υλοποιώντας κατακερματισμό, streaming parsers ή εκχώρηση αρχείων σε background workers. Ωστόσο, μία από τις πιο αποτελεσματικές βελτιστοποιήσεις απαιτεί μηδενική επανασχεδίαση της αρχιτεκτονικής: η αλλαγή της επέκτασης αρχείου από .xlsx σε .xlsb.
Σε αυτόν τον οδηγό, εμβαθύνουμε στην εσωτερική λειτουργία και των δύο μορφών, εξετάζουμε γιατί οι εσωτερικές τους αρχιτεκτονικές παράγουν ριζικά διαφορετικά χαρακτηριστικά απόδοσης, συγκρίνουμε συγκεκριμένα benchmarks μεταξύ Python και .NET, και περιγράφουμε σαφείς κανόνες για το πότε να αναπτύσσετε δυαδικά βιβλία εργασίας στην παραγωγή.
1. Πίσω από τη Σκηνή: OpenXML vs. BIFF12
Για να κατανοήσουμε γιατί η απόδοση αποκλίνει τόσο δραματικά σε μεγάλα σύνολα δεδομένων, πρέπει να εξετάσουμε πώς κάθε μορφή αποθηκεύει εγγραφές στο δίσκο.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Τόσο τα αρχεία .xlsx όσο και τα .xlsb είναι συμπιεσμένα δοχεία ZIP που συμμορφώνονται με τις Open Packaging Conventions (OPC). Αν μετονομάσετε οποιοδήποτε αρχείο σε .zip και το εξαγάγετε, θα δείτε μια γνωστή δομή καταλόγου: _rels, docProps, και xl/worksheets/.
Η κρίσιμη διαφορά βρίσκεται μέσα στο φάκελο xl/worksheets/:
- Το XLSX αποθηκεύει τα φύλλα ως απλό κείμενο XML (
sheet1.xml). - Το XLSB αποθηκεύει τα φύλλα ως ιδιόκτητες δυαδικές ροές (
sheet1.bin), κωδικοποιημένες χρησιμοποιώντας το BIFF12 της Microsoft (Binary Interchange File Format 12).
Πώς το XLSX κωδικοποιεί δεδομένα (Επιβάρυνση XML DOM)
Σε ένα φύλλο εργασίας XLSX, κάθε κελί δηλώνεται με ρητές ετικέτες XML:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Κατά την ανάγνωση αυτής της σειράς, το runtime σας πρέπει:
- Αποσυμπιέστε τη ακατέργαστη ροή deflate σε κείμενο.
- Τονικοποιήστε και αναλύστε τους χαρακτήρες της συμβολοσειράς σε ένα XML DOM ή ροή γεγονότων SAX.
- Επικυρώστε τις εναρκτήριες και κλειστικές ετικέτες (
<c>,</c>,<v>,</v>). - Επιλύστε τις αναζητήσεις συμβολοσειρών από έναν ξεχωριστό πίνακα
sharedStrings.xml. - Αναλύστε το κείμενο ASCII
"98234.55"σε αριθμό κινητής υποδιαστολής 64-bit IEEE 754.
Κάθε μεμονωμένο κελί προκαλεί επιπλέον φόρτο στην CPU για ανάλυση συμβολοσειρών, κατανομή συμβολοσειρών και λεξική ανάλυση. Πολλαπλασιάζοντας αυτό σε 500.000 γραμμές και 30 στήλες (15 εκατομμύρια κελιά), η CPU δαπανά πολύ περισσότερους κύκλους στην ανάλυση σύνταξης παρά στην επεξεργασία των τιμών του τομέα.
Πώς το XLSB κωδικοποιεί δεδομένα (Δυαδική ροή BIFF12)
Το BIFF12 απορρίπτει εντελώς τη σειριοποίηση κειμένου. Αντί για σήμανση συμβολοσειρών, τα δεδομένα οργανώνονται ως μια διαδοχική ακολουθία μεταβλητού μήκους δυαδικών εγγραφών:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Ένα κελί κινητής υποδιαστολής στο BIFF12 δεν χρησιμοποιεί αναπαραστάσεις συμβολοσειρών όπως "98234.55". Αναπαρίσταται άμεσα:
- 2 byte για το αναγνωριστικό εγγραφής (π.χ.,
BrtCellRkήBrtCellReal) - 4 byte για δείκτες στήλης/γραμμής
- 8 byte που περιέχουν τη ακατέργαστη, δομή byte διπλής ακρίβειας IEEE 754
Όταν ο parser σας διαβάζει ένα αρχείο XLSB, παρακάμπτει εντελώς την λεξική ανάλυση. Διαβάζει την κεφαλίδα του εγγραφής, παίρνει τα 8 ακατέργαστα byte από το buffer, τα αντιγράφει απευθείας στη μνήμη και προχωρά τον δείκτη. Δεν υπάρχουν ετικέτες για επικύρωση, δεν γίνονται μετατροπές τύπου string‑to‑number, και δεν υπάρχει καθόλου κόστος αποκωδικοποίησης UTF‑8 για αριθμητικά δεδομένα.
2. Ποσοτικά Benchmarks: Δίσκος, Μνήμη και Απόδοση
Για να απεικονίσετε την πραγματική επίδραση, σκεφτείτε ένα προσομοιωμένο σύνολο δεδομένων που περιέχει 750.000 γραμμές και 25 στήλες (μείγμα χρονικών σημείων, αριθμών κινητής υποδιαστολής, ακεραίων και κωδικών κατηγοριών).
Τα παρακάτω τεστ αξιολογούν ταυτόσκοπες πινάκων δεδομένων αποθηκευμένα τόσο ως XLSX όσο και ως XLSB.
Περιβάλλον Δοκιμής
- CPU: AMD Ryzen 9 5900X (12 πυρήνες, 24 νήματα)
- RAM: 64 GB DDR4-3600
- Αποθήκευση: PCIe 4.0 NVMe SSD
- Χρόνος εκτέλεσης: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Κύρια Μετρικά Απόδοσης
| Μετρική | XLSX (OpenXML) | XLSB (BIFF12) | Διαφορά / Βελτίωση |
|---|---|---|---|
| Μέγεθος Αρχείου στο Δίσκο | 128.4 MB | 68.2 MB | ~47% μικρότερο |
| Αποθήκευση / Χρόνος Σειριοποίησης | 42.6 s | 14.1 s | 3.0x πιο γρήγορο |
| Χρόνος Ανάγνωσης (Python DOM parser) | 38.2 s | 8.9 s | 4.3x πιο γρήγορο |
| Χρόνος Ανάγνωσης (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x πιο γρήγορο |
| Μέγιστη Κατανομή Heap κατά την Ανάγνωση | ~1.85 GB | ~510 MB | ~72% μείωση |
Γιατί τα αρχεία XLSB είναι μικρότερα
Ενώ και οι δύο μορφές χρησιμοποιούν την τυπική συμπίεση ZIP, τα δυαδικά ρεύματα συμπιέζουν πολύ πιο αποδοτικά από το υπερβολικό κείμενο XML:
- Η περιττή σύνταξη αφαιρείται: Το XML περιέχει επαναλαμβανόμενες ετικέτες (
<c r=\"AA1\" s=\"1\">) σε κάθε μεμονωμένη εγγραφή. Ενώ η συμπίεση ZIP μετριάζει τις επαναλαμβανόμενες συμβολοσειρές, το μη συμπιεσμένο ρεύμα δεδομένων είναι τεράστιο. - Πυκνότητα αριθμών: Στο XML, ο αριθμός
12345678.9012απαιτεί 14 bytes κειμένου ASCII. Στο BIFF12, αποθηκεύεται ως διπλό 8-byte (ή συσκευάζεται σε εγγραφήRK4-byte εάν ταιριάζει σε συγκεκριμένους κανόνες ακρίβειας).
3. Χρήση Μνήμης και Πίεση Συλλογής Απορριμμάτων
Για τις υπηρεσίες web και μικροϋπηρεσίες που διαχειρίζονται ταυτόχρονες αιτήσεις, η ταχύτητα του CPU είναι μόνο το ήμισυ του αγώνα· αποτύπωμα μνήμης είναι εκεί που οι εφαρμογές πραγματικά αποτυγχάνουν.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Όταν ένας αναλυτής XML επεξεργάζεται ένα αρχείο XLSX 100 MB, πρέπει να δημιουργήσει χιλιάδες εφήμερα διακριτικά συμβολοσειρών, buffers κομματιών συμβολοσειρών και αναζητήσεις λεξικού. Σε γλώσσες με αυτόματη διαχείριση μνήμης (Java, C#, Go, Node.js, Python), αυτό δημιουργεί ακραίο κατακερματισμό του σωρού και ωθεί το runtime σε συχνές παύσεις Συλλογής Απορριμμάτων (GC).
Δεδομένου ότι η ανάλυση XLSB λειτουργεί απευθείας σε κομμάτια byte σταθερού πλάτους, οι αναλυτές μπορούν να διαβάζουν δεδομένα σε δομές κατανεμημένες στη στοίβα ή σε επαναχρησιμοποιήσιμες προσωρινές μνήμες byte. Το αποτέλεσμα είναι ένα δραματικά μειωμένο αποτύπωμα μνήμης και μηδενική καταπόνηση του εκχωρητή χρόνου εκτέλεσης.
4. Παραδείγματα Υλοποίησης για Προγραμματιστές
Ας δούμε πώς να αξιοποιήσουμε το XLSB σε κοινές αλυσίδες εργαλείων προγραμματιστών.
Python: Μετάβαση από το OpenPyXL στο Calamine / PyXLSB
Η προεπιλογή του τυπικού pandas.read_excel('data.xlsx') είναι το openpyxl, το οποίο δημιουργεί ένα βαρύ δέντρο στη μνήμη.
Για την επεξεργασία μεγάλων αρχείων XLSB με μέγιστη ταχύτητα, χρησιμοποιήστε τη μηχανή calamine που τροφοδοτείται από Rust (διαθέσιμη μέσω python-calamine και ενσωματωμένη στη σύγχρονη Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Εάν επαναλαμβάνετε τεράστια σύνολα δεδομένων γραμμή-γραμμή χωρίς να φορτώνετε ολόκληρο τον πίνακα σε DataFrame, το pyxlsb παρέχει έναν ελαφρύ επαναλήπτη ροής:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Υψηλής Απόδοσης Κατανάλωση Ροής
Στο .NET, βιβλιοθήκες όπως το ClosedXML ή το EPPlus είναι εξαιρετικές για τυπική δημιουργία, αλλά για την ανάγνωση μεγάλων αρχείων χωρίς εξάντληση μνήμης, το ExcelDataReader με υποστήριξη XLSB είναι εξαιρετικά γρήγορο:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Αρχιτεκτονικοί Συμβιβασμοί: Πότε ΔΕΝ πρέπει να χρησιμοποιήσετε XLSB
Παρά τα εντυπωσιακά πλεονεκτήματα απόδοσής του, το XLSB δεν είναι μαγική λύση. Θα πρέπει να ζυγίσετε αρκετές λειτουργικές ανταλλαγές πριν το εφαρμόσετε σε όλη τη στοίβα σας:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Οικοσύστημα και Υποστήριξη Βιβλιοθηκών
- XLSX: Καθολικό. Σχεδόν κάθε γλώσσα, βιβλιοθήκη, SaaS εργαλείο (Google Sheets, Airtable, Tableau) και web parser υποστηρίζουν το OpenXML εγγενώς.
- XLSB: Λιγότερο διαδεδομένο. Ενώ το Excel, το LibreOffice και ώριμες βιβλιοθήκες προγραμματιστών (
ExcelDataReader,pyxlsb,calamine,Aspose) το υποστηρίζουν, πολλά ελαφριά πακέτα ή καθαρά web‑based JavaScript parsers (όπως παλαιότερες εκδόσεις τουSheetJS) έχουν περιορισμένη ή μόνο ανάγνωση υποστήριξη.
2. Git & Διαφορές Ελέγχου Έκδοσης
- XLSX: Επειδή περιέχει κείμενο XML μέσα σε ένα αρχείο ZIP, τα εργαλεία γραμμής εντολών και τα Git hooks μπορούν να αποσυμπιέσουν και να μορφοποιήσουν το XML για να δημιουργήσουν αναγνώσιμα δομικά diffs μεταξύ των commits.
- XLSB: Καθαρά δυαδικά δεδομένα. Τα συστήματα ελέγχου εκδόσεων το αντιμετωπίζουν αυστηρά ως ένα αδιαφανές δυαδικό blob, εξαλείφοντας οποιαδήποτε δυνατότητα λεπτομερούς diffing ή συγχωνεύσεων σε επίπεδο γραμμής.
3. Απόδοση Web Client
Αν η αρχιτεκτονική σας βασίζεται στην απόδοση λογιστικών φύλλων απευθείας στο πρόγραμμα περιήγησης μέσω WebAssembly ή client‑side JavaScript, οι αναλυτές XLSX είναι σημαντικά πιο ώριμοι και λιγότερο επιρρεπείς σε σφάλματα απόδοσης σε ακραίες περιπτώσεις σε σύγκριση με τους client‑side δυαδικούς αναλυτές.
4. Διαδρομές Κατανάλωσης Τρίτων
Εάν εξάγετε αρχεία για εξωτερικούς επιχειρηματικούς πελάτες, πολλές αυστηρές εταιρικές πολιτικές ασφαλείας επισημαίνουν τα αρχεία .xlsb. Δεδομένου ότι τα αρχεία BIFF12 μπορούν να αποθηκεύουν μακροεντολές VBA με τον ίδιο τρόπο όπως τα αρχεία .xlsm (χωρίς να απαιτείται ξεχωριστή επέκταση), ορισμένα φίλτρα αλληλογραφίας και σαρωτές τείχους προστασίας θέτουν σε απομόνωση τις μεταφορτώσεις .xlsb ως πιθανές απειλές που περιέχουν μακροεντολές.
6. Σύνοψη Σύγκρισης: Ποια Μορφή Κερδίζει;
| Χαρακτηριστικό | XLSX | XLSB | Νικητής |
|---|---|---|---|
| Ταχύτητα Ανάγνωσης / Ανάλυσης | Μέτρια έως Κακή | Αστραπιαία Γρήγορη | XLSB |
| Ταχύτητα Εγγραφής / Δημιουργίας | Απαιτητικό σε CPU | Γρήγορο | XLSB |
| Συμπίεση Αρχείου | Καλό | Εξαιρετικό (~40-50% μικρότερο) | XLSB |
| Κατανομή Μνήμης | Υψηλή (Βαρύς φόρτος GC) | Χαμηλή (Άμεση ανάγνωση byte) | XLSB |
| Διαλειτουργικότητα Εργαλείων | Καθολική | Υψηλή, αλλά επιλεκτική | XLSX |
| Αντίσταση Σάρωσης Ασφαλείας | Ελάχιστη | Περιστασιακά ψευδή θετικά | XLSX |
| Δυνατότητα Μακροεντολών | Όχι (.xlsm απαιτείται) | Ναι (Υποστηρίζει μακροεντολές εγγενώς) | Ισορροπία |
7. Η Απόφαση του Προγραμματιστή
Χρησιμοποιήστε XLSX όταν:
- Τα αρχεία είναι μικρά έως μεσαίου μεγέθους (< 50.000 γραμμές).
- Τα αρχεία σας πρέπει να εισαχθούν από πλατφόρμες SaaS τρίτων ή καταναλωτικές εφαρμογές (π.χ., Google Sheets).
- Δεν μπορείτε να ελέγξετε το περιβάλλον του τελικού πελάτη που διαβάζει το αρχείο.
Μεταβείτε σε XLSB όταν:
- Κατασκευάζετε εσωτερικές γραμμές επεξεργασίας, παρτίδες εργασιών, συστήματα ETL ή εργασίες εργατών που διαχειρίζονται τεράστιες εξαγωγές δεδομένων (> 100.000 γραμμές).
- Οι διακομιστές σας αντιμετωπίζουν σφάλματα έλλειψης μνήμης (OOM) κατά τη σειριοποίηση ή αποσειριοποίηση του υπολογιστικού φύλλου.
- Πρέπει να ελαχιστοποιήσετε το αποτύπωμα αποθήκευσης S3/blob και το χρόνο μεταφοράς δικτύου για μεγάλα επαναλαμβανόμενα χρηματοοικονομικά μοντέλα ή εξαγωγές δεδομένων.
Η μετάβαση σε XLSB είναι συχνά τόσο απλή όσο η αλλαγή μιας συμβολοσειράς ρύθμισης στο εξαγωγικό σας υπηρεσία, ωστόσο προσφέρει κέρδη απόδοσης της τάξης του 3x έως 5x που κανονικά απαιτούν εβδομάδες βελτιστοποίησης κώδικα.
Συχνές Ερωτήσεις (FAQ)
**Q1: Υποστηρίζει ένα αρχείο XLSB τα ακριβώς ίδια όρια γραμμών και στηλών όπως ένα αρχείο XLSX; Ναι· και τα XLSB και XLSX μοιράζονται το ακριβώς ίδιο ανώτατο όριο πλέγματος των 1,048,576 γραμμών επί 16,384 στηλών ανά φύλλο εργασίας.
**Q2: Μπορεί ένα αρχείο XLSB να αποθηκεύει με ασφάλεια μακροεντολές VBA χωρίς να αλλάζει την επέκταση του αρχείου;
Ναι, σε αντίθεση με το XLSX (που απαιτεί αποθήκευση ως XLSM για την εκτέλεση κώδικα), το XLSB υποστηρίζει εγγενή αποθήκευση δυαδικών μακροεντολών VBA μέσα στην ίδια μορφή αρχείου .xlsb.
**Q3: Γιατί η αποθήκευση ενός αρχείου ως XLSB μειώνει το μέγεθός του εάν και οι δύο μορφές είναι ήδη συμπιεσμένες με ZIP; Το XLSB εξαλείφει τις εκτενείς ετικέτες σήμανσης κειμένου και κωδικοποιεί τις θέσεις κελιών, τις εγγραφές και τις ακατέργαστες αριθμητικές τιμές σε στενά δυαδικά ρεύματα byte που συμπιέζονται πολύ πιο πυκνά από τις απλές συμβολοσειρές XML.
**Q4: Μπορεί το Google Sheets να εισάγει και να επεξεργαστεί αρχεία XLSB απευθείας;
Όχι· το Google Sheets δεν μπορεί εγγενώς να ανοίξει ή να μετατρέψει αρχεία .xlsb απευθείας, απαιτώντας να τα μετατρέψετε σε .xlsx ή CSV πριν την εισαγωγή.
**Q5: Είναι τα αρχεία XLSB πιο επιρρεπή σε διαφθορά δεδομένων από τα αρχεία XLSX; Ενώ τα αρχεία XML μπορούν μερικές φορές να επιθεωρηθούν ή να επισκευαστούν χειροκίνητα με έναν επεξεργαστή κειμένου όταν είναι μερικώς κατεστραμμένα, τα δυαδικά ρεύματα BIFF12 απαιτούν αυστηρές μετατοπίσεις byte και είναι δύσκολο να ανακτηθούν χειροκίνητα εάν οι δομικοί τομείς είναι κατεστραμμένοι.