Última actualización: 20 de ago., 2026
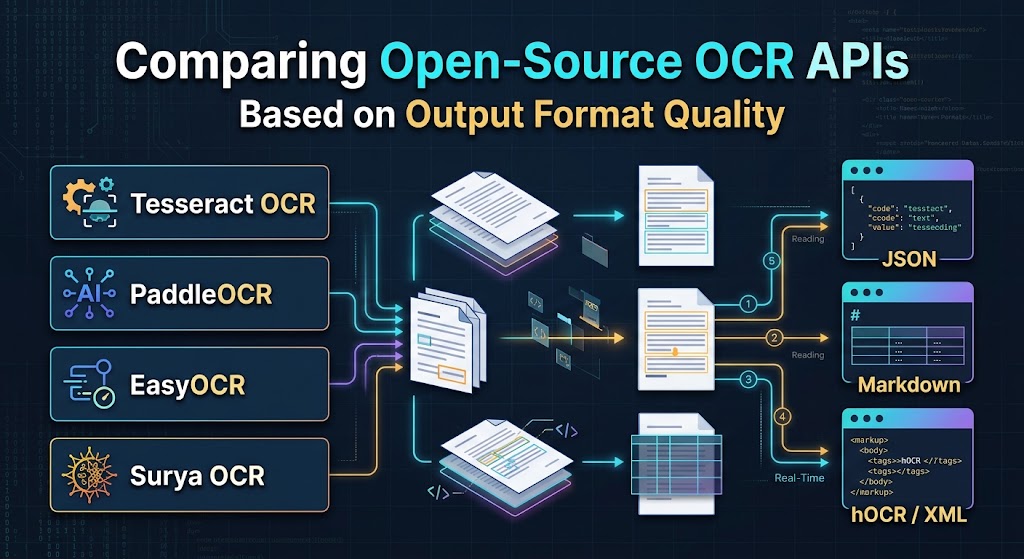
Comparando APIs OCR de código abierto basadas en la calidad del formato de salida
Cuando los ingenieros evalúan los motores de Reconocimiento Óptico de Caracteres (OCR), la tasa de error de caracteres (CER) y la tasa de error de palabras (WER) suelen dominar los benchmarks. Aunque la precisión del reconocimiento es esencial, solo resuelve la mitad del problema en producción.
Si estás analizando PDFs complejos de varias columnas, extrayendo líneas de detalle de recibos, o incorporando documentos técnicos a una canalización de incrustaciones LLM, los volúmenes de texto sin formato generan una enorme sobrecarga de ingeniería. Una cadena de caracteres sin conciencia de diseño, orden de lectura lógico o datos de coordenadas obliga a tu equipo a escribir analizadores heurísticos frágiles.
El verdadero diferenciador para los flujos de trabajo de documentos modernos es la calidad del formato de salida: cuán consistentemente y limpiamente un motor entrega coordenadas, orden de lectura, jerarquía estructural y datos tabulares.
A continuación se muestra una comparación centrada en la ingeniería de cuatro motores líderes de open-source OCR —Tesseract, PaddleOCR, EasyOCR y Surya OCR— evaluando cómo sus salidas se comportan dentro de canalizaciones automatizadas.
Los formatos de salida comunes: lo que los ingenieros realmente necesitan
Cada API de OCR empaqueta el texto detectado de manera diferente. Comprender estos formatos ayuda a determinar cuánto post-procesamiento requiere su canalización:
- Plain Text (
.txt): La representación más simple. Elimina todos los metadatos posicionales y colapsa los diseños de varias columnas en lecturas horizontales, lo que puede desordenar los párrafos. - Archival Standards (
hOCR,ALTO XML): Formatos basados en XML/HTML estándar en el archivo de bibliotecas. Incorporan coordenadas, estimaciones de fuentes y calificaciones de confianza dentro de los nodos DOM. Extremadamente robustos para la reconstrucción de documentos, pero voluminosos para microservicios. - Structured JSON: La opción predeterminada para los backends web modernos. Proporciona matrices de coordenadas (cajas delimitadoras o polígonos), calificaciones de confianza y estructuras jerárquicas de bloque/línea/palabra.
- Markdown (
.md) / HTML Tables: El estándar moderno para Retrieval-Augmented Generation (RAG). Conserva secciones semánticas (encabezados, listas, texto en negrita) y matrices tabulares sin requerir una reconstrucción espacial posterior.
1. Tesseract OCR
Mantenido por Google, Tesseract sigue siendo el caballo de batalla fundamental del OCR de código abierto. Su arquitectura se basa en gran medida en algoritmos tradicionales de segmentación de página complementados con un motor de caracteres basado en LSTM.
Formatos de salida nativos
- Salidas principales: Texto plano, hOCR (HTML), ALTO XML, TSV (Valores separados por tabulaciones), y PDF/A buscable.
- Conciencia de diseño: Heurísticas basadas en reglas mediante los modos de segmentación de página (PSM).
Análisis de formato de salida
- Donde sobresale: Las exportaciones
TSVyhOCRde Tesseract están estandarizadas y son predecibles. Una única exportación TSV devuelve columnas estructuradas paralevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightyconf. Si estás convirtiendo archivos de papel en PDFs buscables o necesitas una estricta adherencia a los estándares institucionales, Tesseract lo maneja de forma nativa sin código de unión personalizado. - Donde falla: Tesseract no tiene una API JSON nativa. Consumir su salida en Python o Node.js requiere analizar archivos XML/TSV o usar envoltorios como
pytesseract. Su motor de diseño también tiene dificultades con flujos columnarios no estándar, mezclando frecuentemente texto de columnas adyacentes a menos que se proporcionen recortes de límites manuales.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Respaldado por el framework PaddlePaddle de Baidu, PaddleOCR ha ganado una adopción generalizada gracias a sus modelos ligeros, amplia cobertura multilingüe y su conjunto de herramientas dedicado al análisis de documentos (PP-Structure).
Formatos de salida nativos
- Resultados principales: listas/diccionarios de Python, JSON sin procesar, superposiciones de visualización y HTML estructurado a través de PP-Structure.
- Conciencia de diseño: Alta (usando modelos de deep learning para el análisis de diseño, clasificación de orientación y recuperación de tablas).
Análisis de formato de salida
- Dónde sobresale: PaddleOCR estándar devuelve coordenadas de polígonos de 4 puntos (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) junto con cadenas de texto y puntuaciones de confianza. Esto maneja texto sesgado o curvo de forma elegante. Sin embargo, su verdadera fortaleza reside en la suite PP-Structure, que detecta regiones de diseño (título, texto, tabla, figura) y analiza tablas directamente en cadenas HTML válidas (<table>...</table>). Esto elimina la necesidad de calcular manualmente los spans de celdas a partir de los cuadros delimitadores. - Dónde falla: La API base devuelve matrices anidadas que carecen de claves de propiedad estándar entre diferentes versiones. Para aplicaciones estructuradas, los desarrolladores suelen escribir un adaptador intermedio para estandarizar los nombres de campos (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Construido sobre PyTorch por JaidedAI, EasyOCR está diseñado para una adopción rápida por parte de los desarrolladores. Empaqueta CRAFT (Conciencia de Región de Caracteres para la Detección de Texto) con redes de reconocimiento de deep learning en una API mínima.
Formatos de salida nativos
- Salidas Principales: Listas de Python que contienen tuplas de coordenadas, cadenas reconocidas y valores de confianza.
- Conciencia de Diseño: Baja a moderada (solo detección de líneas de texto; sin análisis estructural a nivel de documento).
Análisis de formato de salida
- Donde Destaca: La simplicidad del objeto devuelto es inigualable:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Mapear esta salida a una respuesta REST estándar o serializarla directamente a GeoJSON/esquemas personalizados requiere solo unas pocas líneas de código. Funciona de manera fiable con texto en escenas naturales, matrículas de vehículos y recortes de documentos aislados.
- Donde Falló: EasyOCR no realiza un análisis holístico del diseño del documento. No identifica tablas, jerarquías de encabezados ni órdenes de lectura en columnas complejas. Usar EasyOCR en un artículo académico de dos columnas a menudo produce fragmentos de texto entrelazados a menos que se combine con un modelo de detección de diseño previo (como YOLO o LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya es un marco OCR de aprendizaje profundo moderno diseñado específicamente para la comprensión de documentos complejos y pipelines de ingestión LLM.
Formatos de salida nativos
- Salidas Principales: Estructuras JSON modeladas con Pydantic, índices de orden de lectura lógica, regiones delimitadoras de diseño y polígonos de detección de líneas.
- Conciencia de diseño: Excepcionalmente alta (análisis de diseño basado en aprendizaje profundo y ordenamiento del orden de lectura).
Análisis de formatos de salida
- Dónde sobresale: Surya aborda directamente los desafíos de la ingeniería de IA moderna. En lugar de asumir que los documentos se leen de arriba a abajo y de izquierda a derecha, Surya despliega un modelo dedicado para predecir el orden de lectura. Agrupa líneas en bloques semánticos lógicos, maneja naturalmente los extensiones de varias columnas y genera estructuras tipadas mediante Pydantic. Esto hace que la ingestión posterior en bases de datos vectoriales y convertidores a Markdown sea directa y confiable.
- Dónde falla: Como un framework más nuevo y pesado basado en PyTorch, Surya requiere cómputo GPU dedicado para igualar el rendimiento de motores C++ optimizados como Tesseract o modelos Paddle cuantizados. No está orientado a estándares de archivo heredados como hOCR o ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Matriz de comparación directa
| Capacidad / Formato | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Nativo hOCR / ALTO XML | Soporte nativo | Solo de terceros | Ninguno | Ninguno |
| Geometría de cuadro delimitador | Alineado a los ejes (x, y, w, h) | Polígono de 4 puntos | Polígono de 4 puntos | Polígono + bloques de diseño |
| Análisis de tablas | Solo TSV de coordenadas | Cadenas de tablas HTML | Ninguno | Cuadrículas de coordenadas de celdas |
| Detección del orden de lectura | Basado en reglas (separa en columnas múltiples) | Análisis de diseño ML | Agrupación básica de líneas | Modelo de orden de lectura dedicado |
| Esquemas JSON Directos | Requiere conversión | Diccionario Python / JSON | Lista Python / JSON | Modelos Pydantic tipados |
| Objetivo descendente ideal | PDFs de archivo, DMS heredado | Datos de formularios/recibos, ERP | Scripts rápidos, Texto de escena | Ingesta de LLM, Arquitecturas RAG |
Recomendaciones de flujo de trabajo: ¿Cuál deberías elegir?
- Elija Tesseract si sus requisitos de cumplimiento exigen entregables estandarizados
hOCR,ALTO XMLo PDF/A buscables para registros gubernamentales o de archivo. - Elija PaddleOCR si está procesando documentos financieros operacionales (facturas, recibos, formularios fiscales) que contienen tablas complejas y sin bordes que deben convertirse a HTML o hojas de cálculo.
- Elija EasyOCR si necesita una biblioteca ligera y pythonica para detectar y extraer texto de imágenes naturales, señales callejeras o elementos de UI recortados sin complicaciones de configuración.
- Elija Surya OCR si está alimentando informes empresariales no estructurados, artículos de investigación y guías técnicas en un LLM o motor de búsqueda vectorial donde el orden lógico de lectura y los límites estructurales limpios son fundamentales.
Preguntas frecuentes (FAQ)
1. ¿Qué formato de salida OCR de código abierto es el más fácil de alimentar a los Modelos de Lenguaje Grande?
El JSON consciente del orden de lectura de Surya OCR y las tablas HTML de PP-Structure de PaddleOCR proporcionan las representaciones más limpias para los contextos de indicaciones de LLM y la indexación RAG.
2. ¿Puede Tesseract generar respuestas JSON de forma nativa sin herramientas de terceros?
No, Tesseract genera texto, TSV, PDF y hOCR/ALTO XML de forma nativa; producir JSON requiere convertir su salida TSV o hOCR mediante un analizador intermedio.
3. ¿En qué se diferencian las coordenadas de polígonos de 4 puntos de los cuadros delimitadores alineados con los ejes?
Los cuadros alineados a los ejes usan [x, y, width, height] asumiendo texto plano, mientras que los polígonos de 4 puntos proporcionan cuatro pares de coordenadas para encerrar con precisión líneas de texto rotadas, sesgadas o curvadas.
4. ¿Qué motor genera estructuras de tabla directamente en código en lugar de coordenadas sueltas?
El módulo PP-Structure de PaddleOCR reconstruye los límites de tabla detectados en etiquetas HTML de tabla completas (<table>, <tr>, <td>), evitando cálculos espaciales personalizados.
5. ¿Por qué la salida estándar de EasyOCR tiene dificultades con artículos científicos de varias columnas?
EasyOCR identifica las líneas de texto basándose en la proximidad local en lugar de la jerarquía de diseño global, lo que hace que el texto de columnas adyacentes se entrelacen a menos que esté delimitado por un motor de diseño externo.
Ver también
- Formatos de salida OCR comparados: TXT, PDF, PDF/A, XML, JSON
- Entendiendo los formatos de archivo OCR - HOCR vs ALTO vs PDF/A explicado
- ¿Cuál es la diferencia entre PDF y FDF?
- PDF vs Word: ¿Cuál deberías usar y cuándo?
- Cómo elegir el formato de archivo correcto para el reconocimiento de texto manuscrito (HTR)