Última actualización: 20 de ago., 2026
Formatos de archivo OCR para documentos históricos y manuscritos
Preservar el patrimonio cultural mediante la digitalización ha entrado en un renacimiento. Mientras que los primeros sistemas de reconocimiento óptico de caracteres (OCR) fueron diseñados para analizar documentos impecables, impresos mecánicamente del siglo XX, las instituciones modernas de patrimonio cultural se enfrentan a un desafío mucho más desordenado y rico: manuscritos medievales, correspondencia cursiva del siglo XIX, folios iluminados frágiles y registros centenarios.
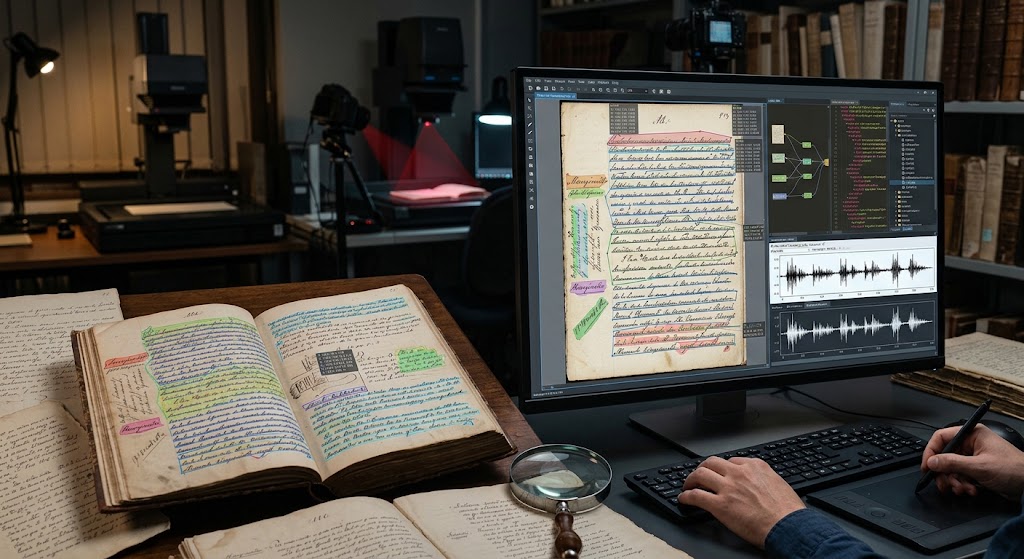
Transcribir documentos históricos ya no se trata solo de extraer texto ASCII plano. Requiere capturar contexto—la geometría física de la página, curvas de línea base, correcciones de sangrado, marginalia, abreviaturas y la incertidumbre paleográfica. Este campo especializado, frecuentemente categorizado bajo Reconocimiento de Texto Manuscrito (HTR), depende en gran medida del formato de archivo utilizado para almacenar e intercambiar tanto las coordenadas de la imagen como las capas de texto.
Seleccionar el esquema incorrecto puede eliminar datos vitales de la línea base, romper la alineación con los manifiestos IIIF (International Image Interoperability Framework) o impedir la preservación digital a largo plazo. Aquí tienes una guía definitiva de los principales formatos de archivo OCR y HTR para documentos históricos, sus fortalezas estructurales y cómo determinar la elección correcta para tu flujo de trabajo archivístico.
El dilema histórico: Por qué Texto sin formato y los PDFs estándar fallan
El OCR impreso por máquina suele generar archivos simples .txt o PDFs “sándwich” con capas de texto ocultas bajo el escaneo. Para manuscritos históricos y escritura cursiva, estos resultados fallan por tres razones principales:
- Texto no lineal y diseños complejos: Los escribas históricos no se adherían a cuadrículas rectangulares ordenadas. El texto fluye hacia los márgenes, se envuelve alrededor de iniciales iluminadas, se entrelaza entre correcciones interlineales insertadas, o se extiende verticalmente a lo largo del lomo.
- Líneas base curvas y sesgadas: La escritura cursiva rara vez sigue un eje horizontal rígido. Los motores HTR como Transkribus, Kraken y eScriptorium dependen de líneas base polilínea en lugar de cajas delimitadoras para interpretar escrituras con muchas ligaduras.
- Complejidad paleográfica y metadatos: La investigación archivística requiere rastrear abreviaturas, variaciones ortográficas históricas, lecturas dañadas y puntuaciones de confianza a nivel de línea. Los formatos de documento estándar descartan esta granularidad.
Para mantener la fidelidad al artefacto original, la comunidad archivística confía en esquemas XML estructurados diseñados para preservar la topología del diseño junto con el texto transcrito.
1. PAGE XML: El estándar de oro para el reconocimiento de texto manuscrito (HTR)
Desarrollado por el Laboratorio de Investigación PRImA (Reconocimiento de Patrones y Análisis de Imágenes), PAGE XML (Page Analysis and Groundtruth Elements) es ampliamente considerado el formato de vanguardia para el reconocimiento de texto manuscrito y el análisis avanzado de diseños.
Arquitectura central
PAGE XML trata el documento físico como una estructura jerárquica:
PcGts(Raíz)Page(Dimensiones de la imagen y orden de lectura general)TextRegion(Párrafos, encabezados, notas marginales, palabras de captura)TextLineCoords(Coordenadas del polígono alrededor de la línea)Baseline(Una serie de puntos que siguen la verdadera línea base de la escritura)TextEquiv(El texto reconocido, con métricas de confianza opcionales)
Por qué sobresale para manuscritos históricos
- Precisión de Polígonos y Polilíneas: En lugar de forzar los caracteres en cuadros delimitadores rectangulares, PAGE XML utiliza límites de polígonos de múltiples puntos y líneas base continuas. Esto evita que los ascendentes y descendentes cursivos superpuestos interfieran con la segmentación.
- Tipos estructurales granulares: Las regiones pueden clasificarse con precisión (p. ej.,
marginalia,drop-capital,signature-mark,header,editorial-note). - Amplio ecosistema de software: Sirve como el esquema interno y de exportación principal para plataformas insignia de HTR como Transkribus, eScriptorium, y Kraken.
2. ALTO XML: La potencia de bibliotecas y archivos
ALTO (Analyzed Layout and Text Object) es un estándar XML abierto mantenido por la Library of Congress y ampliamente adoptado por bibliotecas nacionales, incluidas la Bibliothèque nationale de France (BnF) y la British Library.
Arquitectura central
ALTO estructura el diseño jerárquicamente desde Page hasta PrintSpace, pasando por TextBlock, TextLine y String (palabras o tokens individuales). Con frecuencia se empaqueta dentro de un contenedor METS (Metadata Encoding and Transmission Standard) para asociar metadatos estructurales con imágenes maestras de alta resolución.
Fortalezas clave y casos de uso
- Flujos de trabajo de digitalización masiva: ALTO fue diseñado pensando en la digitalización a escala industrial de periódicos y libros. Codifica de manera clara los atributos de fuente, coordenadas a nivel de palabra, confianza de caracteres y espacios en blanco.
- Soporte HTR Moderno (ALTO 4): Las versiones anteriores de ALTO se basaban en gran medida en coordenadas rectangulares (
HPOS,VPOS,WIDTH,HEIGHT). Sin embargo, a partir de la versión 4 de ALTO, el esquema introdujo polígonos<Shape>y líneas de base polilínea, cerrando la brecha funcional con PAGE XML para materiales manuscritos. - Preservación a Largo Plazo: Debido a que es un estándar oficial respaldado por consorcios internacionales de bibliotecas, ALTO garantiza estabilidad a largo plazo y compatibilidad retroactiva de nivel archivístico.
3. hOCR: El estándar web-primero y ligero
Creado por Thomas Breuel, hOCR adopta un enfoque pragmático: en lugar de crear un esquema XML completamente nuevo, inserta metadatos de diseño y transcripción directamente en HTML/XHTML semántico usando microformatos y atributos de clase.
Ejemplo típico de sintaxis
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">Incipit</span>
      </span>
    </p>
  </div>
</div>
Ventajas y desventajas de los materiales históricos
- Ventajas: Los navegadores pueden renderizarlo de forma nativa. Se transforma fácilmente usando CSS y JavaScript puros, y es el formato de exportación estructurado predeterminado para motores como Tesseract.
- Desventajas: El soporte nativo para curvas de línea de base complejas y de forma libre con múltiples puntos es limitado. Aunque es práctico para obras impresas tempranas (incunables o folletos limpios), hOCR tiene dificultades con diseños manuscritos erráticos y marginalia de múltiples capas.
4. TEI-XML: El referente académico y de humanidades digitales
El formato Text Encoding Initiative (TEI) no es estrictamente un formato de salida de motor OCR; más bien, es el estándar principal para ediciones digitales críticas y la representación académica de textos literarios e históricos.
Conectando OCR/HTR con TEI
Los flujos de trabajo modernos rara vez se detienen en el reconocimiento bruto de caracteres. Los académicos utilizan herramientas como el Transkribus TEI Exporter o pipelines XSLT automatizados para traducir archivos PAGE XML o ALTO a XML conforme a TEI:
- Las abreviaturas se expanden (
<choice><abbr>...</abbr><expan>...</expan></choice>). - Las eliminaciones, adiciones y manos de escritura se clasifican formalmente (
<add>,<del>,<handShift>). - Los datos de maquetación se conservan junto al análisis literario mediante los elementos
<facsimile>y<surface>.
Si su proyecto histórico tiene como objetivo crear una edición crítica interactiva o un archivo académico semánticamente buscable, convertir sus datos OCR/HTR a TEI-XML suele ser el paso final necesario.
Matriz comparativa: formatos OCR/HTR de un vistazo
| Característica / Criterio | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| Dominio principal | HTR cursiva y manuscritos | Digitalización masiva de bibliotecas | OCR web y búsqueda ligera | Ediciones críticas académicas |
| Soporte básico | Nativo, polilíneas multipunto | Compatible (desde v4.0) | Básico (Pendiente/Desplazamiento) | A través de mapeo de facsímil |
| Polígonos irregulares | Completo | Completo | Limitado | A través de elementos de coordenadas |
| Ecosistema de herramientas | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, Visores web | Oxygen, TEI Publisher |
| Organismo de estandarización | PRImA Group / Open | Biblioteca del Congreso | Especificación comunitaria | Consorcio TEI |
Recomendaciones prácticas: eligiendo su flujo de trabajo archivístico
Para establecer una canalización de digitalización eficiente y a prueba de futuro:
- Para manuscritos y archivos manuscritos puros: Estandariza tu transcripción y extracción de diseño en PAGE XML. Su cálculo de línea base y contorno de polígonos manejan manos de escritura no estándar con una pérdida mínima de datos.
- Para bibliotecas a gran escala y colecciones mixtas: Elige ALTO XML (v4.2 o superior) combinado con METS. Esto garantiza una integración sin problemas en arquitecturas estándar de repositorios digitales y sistemas de gestión de activos digitales (DAMS).
- Para presentación web e índices de búsqueda de texto completo: Utiliza hOCR o genera estructuras ligeras GeoJSON/Anotación Web a partir de PAGE XML para impulsar visores interactivos IIIF (como Mirador o Universal Viewer) con superposiciones de texto en vivo en el navegador.
- Para ediciones académicas y investigación paleográfica: Genere su verdad de referencia en PAGE XML, realice el reconocimiento y canalice la salida a través de un conversor automatizado para generar TEI-XML para el marcado editorial.
Al alinear las capacidades estructurales de estos formatos con las exigencias paleográficas de su material fuente, garantiza que cada trazo, abreviatura y matiz histórico permanezca descifrable durante siglos.
Preguntas frecuentes (FAQ)
Q1. ¿Cuál es la diferencia fundamental entre OCR estándar y HTR? OCR reconoce tipografía impresa por máquina de forma consistente, mientras que HTR (Reconocimiento de Texto Manuscrito) utiliza redes neuronales profundas para decodificar la escritura humana continua y variable y líneas de base curvas.
Q2. ¿Puede Tesseract OCR generar PAGE XML o salida ALTO para documentos históricos? Sí, Tesseract puede generar ALTO XML nativo y salida hOCR, y envoltorios de terceros pueden convertir estos resultados a PAGE XML.
Q3. ¿Por qué las líneas de base son más importantes que los cuadros delimitadores en la transcripción de texto manuscrito? Las líneas de base siguen la línea natural y ondulada de la caligrafía humana, permitiendo que el software separe ascendentes y descendentes superpuestos que colisionan dentro de cuadros delimitadores rígidos.
Q4. ¿Cómo interactúa el estándar IIIF con estos formatos de archivo OCR? IIIF sirve imágenes de alta resolución a través de APIs web abiertas, mientras que formatos como ALTO o PAGE XML proporcionan datos de coordenadas que pueden convertirse en anotaciones de búsqueda de contenido IIIF.
Q5. ¿Qué formato de archivo es el más fácil de convertir directamente en un PDF buscable? Tanto hOCR como ALTO XML pueden combinarse con las imágenes originales de la página para crear archivos PDF de doble capa buscables usando herramientas como OCRmyPDF.
Ver también
- PDF/A-3 - ¿El monstruo híbrido? Insertando datos originales dentro de tu OCR
- Entendiendo los formatos de archivo OCR - HOCR vs ALTO vs PDF/A explicado
- ¿Cuál es la diferencia entre PDF y FDF?
- ¿Para qué se usa FDF? Entendiendo el propósito del Formato de Datos de Formularios
- PDF vs Word: ¿Cuál deberías usar y cuándo?