Última actualización: 30 sept., 2026
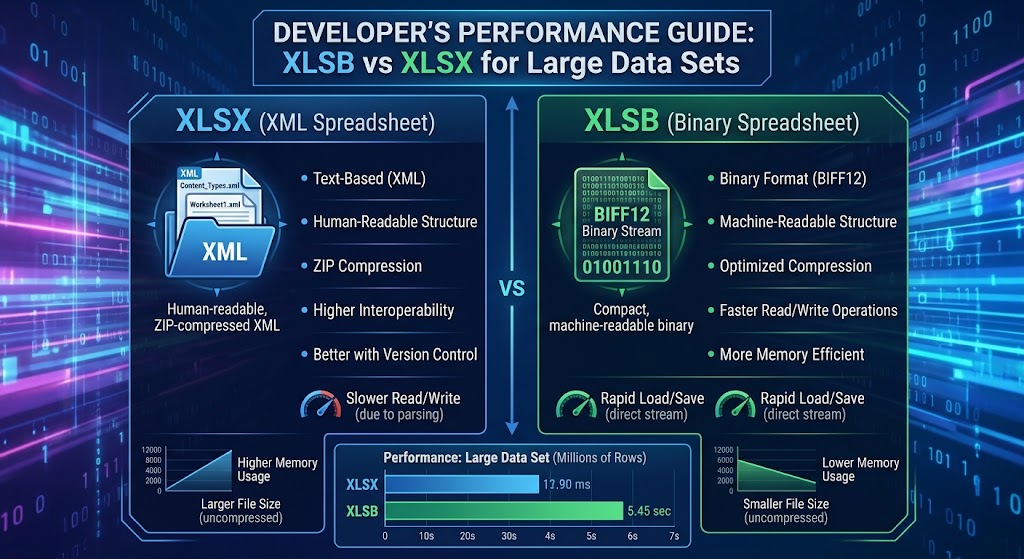
XLSB vs XLSX para Conjuntos de Datos Grandes: Guía de Rendimiento para Desarrolladores
Si construyes pipelines de datos, motores de informes backend o herramientas de análisis que se integran con Microsoft Excel, probablemente te hayas encontrado con “el muro.”
Un usuario sube un libro de trabajo de 450,000 filas. Tu servidor inicia hilos de trabajo, el consumo de memoria se dispara a varios gigabytes, la recolección de basura congela el tiempo de ejecución y tu proceso se agota. Inspeccionas la carga útil: es un archivo .xlsx estándar.
Para resolver esto, los desarrolladores a menudo pasan días implementando fragmentación, analizadores de transmisión o delegando archivos a trabajadores en segundo plano. Sin embargo, una de las optimizaciones más efectivas no requiere rediseño arquitectónico alguno: cambiar la extensión del archivo de .xlsx a .xlsb.
En esta guía, nos adentramos bajo el capó de ambos formatos, examinamos por qué sus arquitecturas internas generan características de rendimiento radicalmente diferentes, comparamos benchmarks concretos en Python y .NET, y describimos reglas claras para saber cuándo desplegar libros de trabajo binarios en producción.
1. Bajo el Capó: OpenXML vs. BIFF12
Para entender por qué el rendimiento diverge tan drásticamente en conjuntos de datos grandes, debemos observar cómo cada formato almacena los registros en disco.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Tanto los archivos .xlsx como .xlsb son contenedores ZIP comprimidos que cumplen con las Open Packaging Conventions (OPC). Si renombras cualquiera de los archivos a .zip y lo extraes, verás una estructura de directorios familiar: _rels, docProps y xl/worksheets/.
La diferencia crítica se encuentra dentro de la carpeta xl/worksheets/:
- XLSX almacena las hojas como texto XML plano (
sheet1.xml). - XLSB almacena las hojas como flujos binarios propietarios (
sheet1.bin), codificados usando BIFF12 de Microsoft (Binary Interchange File Format 12).
Cómo XLSX codifica datos (sobrecarga del DOM XML)
En una hoja de cálculo XLSX, cada celda se declara con etiquetas XML explícitas:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Al leer esta fila, tu entorno de ejecución debe:
- Descomprimir el flujo deflate sin procesar a texto.
- Tokenizar y analizar los caracteres de la cadena en un DOM XML o en un flujo de eventos SAX.
- Validar etiquetas de apertura y cierre (
<c>,</c>,<v>,</v>). - Resolver búsquedas de cadenas desde una tabla
sharedStrings.xmlseparada. - Analizar el texto ASCII
"98234.55"a un número de punto flotante de 64 bits IEEE 754.
Cada celda individual genera una sobrecarga de CPU por el análisis de cadenas, la asignación de cadenas y el análisis léxico. Multiplique esto por 500,000 filas y 30 columnas (15 millones de celdas), y la CPU dedica muchos más ciclos al análisis de la sintaxis que al procesamiento de los valores del dominio.
Cómo XLSB codifica datos (flujo binario BIFF12)
BIFF12 descarta la serialización de texto por completo. En lugar de marcado de cadenas, los datos se organizan como una secuencia secuencial de registros binarios de longitud variable:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Una celda de punto flotante en BIFF12 no utiliza representaciones de cadena como "98234.55". Se representa directamente:
- 2 bytes para el ID del registro (p. ej.,
BrtCellRkoBrtCellReal) - 4 bytes para los índices de columna/fila
- 8 bytes que contienen la estructura de bytes cruda IEEE 754 de doble precisión
Cuando tu analizador lee un archivo XLSB, omite por completo el análisis léxico. Lee el encabezado del registro, toma los 8 bytes crudos del búfer, los copia directamente a la memoria y avanza el puntero. No hay etiquetas que validar, no hay conversiones de tipo cadena a número, y cero sobrecarga de decodificación UTF-8 para datos numéricos.
2. Métricas cuantitativas: disco, memoria y rendimiento
Para ilustrar el impacto en el mundo real, considera un conjunto de datos simulado que contiene 750,000 filas y 25 columnas (una mezcla de marcas de tiempo, números de punto flotante, enteros y códigos de categoría).
Las pruebas a continuación evalúan datos tabulares idénticos guardados tanto en XLSX como en XLSB.
Entorno de pruebas
- CPU: AMD Ryzen 9 5900X (12 núcleos, 24 hilos)
- RAM: 64 GB DDR4-3600
- Almacenamiento: PCIe 4.0 NVMe SSD
- Tiempo de ejecución: Python 3.11 (
openpyxl,pyxlsb,calamine) y .NET 8 (ExcelDataReader,ClosedXML)
Métricas clave de rendimiento
| Métrica | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Mejora |
|---|---|---|---|
| Tamaño del archivo en disco | 128.4 MB | 68.2 MB | ~47% más pequeño |
| Guardar / Tiempo de Serialización | 42.6 s | 14.1 s | 3.0x más rápido |
| Tiempo de Lectura (analizador DOM de Python) | 38.2 s | 8.9 s | 4.3x más rápido |
| Tiempo de lectura (Motor Rust/C) | 6.4 s | 1.9 s | 3.3x más rápido |
| Asignación máxima de heap durante la lectura | ~1.85 GB | ~510 MB | ~72% de reducción |
Por qué los archivos XLSB son más pequeños
Aunque ambos formatos usan compresión ZIP estándar, los flujos binarios comprimen mucho más eficientemente que el texto XML inflado:
- La sintaxis redundante se elimina: XML contiene etiquetas repetitivas (
<c r="AA1" s="1">) en cada registro. Aunque la compresión ZIP mitiga las cadenas repetidas, el flujo de datos sin comprimir es masivo. - Densidad numérica: En XML, el número
12345678.9012requiere 14 bytes de texto ASCII. En BIFF12, se almacena como un doble de 8 bytes (o empaquetado en un registroRKde 4 bytes si cumple reglas de precisión específicas).
3. Huella de memoria y presión de recolección de basura
Para los servicios web y microservicios que manejan solicitudes concurrentes, la velocidad de la CPU es solo la mitad de la batalla; la huella de memoria es donde las aplicaciones realmente fallan.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Cuando un analizador XML procesa un archivo XLSX de 100 MB, debe crear miles de tokens de cadena efímeros, buffers de fragmentos de cadena y búsquedas en diccionarios. En lenguajes con recolección de basura (Java, C#, Go, Node.js, Python), esto genera una fragmentación extrema del heap y lleva al tiempo de ejecución a pausas frecuentes de recolección de basura (GC).
Porque el análisis de XLSB opera directamente sobre fragmentos de bytes de ancho fijo, los analizadores pueden leer datos en estructuras asignadas en la pila o en búferes de bytes reutilizables. El resultado es una huella de memoria drásticamente reducida y cero sobrescrituras del asignador en tiempo de ejecución.
4. Ejemplos de Implementación para Desarrolladores
Veamos cómo aprovechar XLSB en las cadenas de herramientas comunes para desarrolladores.
Python: migración de OpenPyXL a Calamine / PyXLSB
El método estándar pandas.read_excel('data.xlsx') usa por defecto openpyxl, que construye un árbol pesado en memoria.
Para procesar archivos XLSB grandes con la máxima velocidad, use el motor calamine impulsado por Rust (disponible a través de python-calamine e integrado en Pandas moderno):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Si está iterando sobre conjuntos de datos masivos fila por fila sin cargar toda la matriz en un DataFrame, pyxlsb ofrece un iterador de transmisión ligero:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Ingesta de flujo de alto rendimiento
En .NET, bibliotecas como ClosedXML o EPPlus son excelentes para la generación estándar, pero para ingerir archivos grandes sin agotar la memoria, ExcelDataReader con soporte XLSB es excepcionalmente rápido:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Compromisos arquitectónicos: Cuándo NO usar XLSB
A pesar de sus abrumadoras ventajas de rendimiento, XLSB no es una solución mágica. Debe sopesar varios compromisos operativos antes de implementarlo en toda su infraestructura:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Soporte del ecosistema y de bibliotecas
- XLSX: Universal. Prácticamente todos los lenguajes, bibliotecas, herramientas SaaS (Google Sheets, Airtable, Tableau) y analizadores web admiten OpenXML de forma nativa.
- XLSB: Menos ubicuo. Mientras que Excel, LibreOffice y bibliotecas de desarrollo maduras (
ExcelDataReader,pyxlsb,calamine,Aspose) lo admiten, muchos paquetes ligeros o analizadores JavaScript basados en la web puros (como versiones anteriores deSheetJS) tienen soporte limitado o solo de lectura.
2. Diferencias en Git y control de versiones
- XLSX: Debido a que contiene XML de texto dentro de un contenedor ZIP, las utilidades de línea de comandos y los hooks de Git pueden descomprimir y formatear el XML para generar diferencias estructurales legibles entre commits.
- XLSB: Datos binarios puros. Los sistemas de control de versiones lo tratan estrictamente como un blob binario opaco, eliminando cualquier posibilidad de diffs granulares o fusiones a nivel de línea.
3. Renderizado del cliente web
Si tu arquitectura depende de renderizar hojas de cálculo directamente en el navegador mediante WebAssembly o JavaScript del lado del cliente, los analizadores XLSX son significativamente más maduros y menos propensos a errores de renderizado en casos límite que los analizadores binarios del lado del cliente.
4. Pipelines de ingestión de terceros
Si está exportando archivos para clientes empresariales externos, muchas políticas de seguridad corporativa estrictas marcan los archivos .xlsb. Debido a que los archivos BIFF12 pueden almacenar macros VBA idénticamente a los archivos .xlsm (sin requerir una extensión separada), algunos filtros de correo y escáneres de firewall ponen en cuarentena las cargas .xlsb como posibles amenazas con macros.
6. Comparación resumida: ¿Qué formato gana?
| Funcionalidad | XLSX | XLSB | Ganador |
|---|---|---|---|
| Velocidad de lectura / análisis | De moderada a pobre | Muy rápido | XLSB |
| Velocidad de escritura / generación | Intensivo en CPU | Rápido | XLSB |
| Compresión de archivo | Bueno | Excelente (~40-50% más pequeño) | XLSB |
| Asignación de memoria | Alta (Alta presión de GC) | Baja (Lectura directa de bytes) | XLSB |
| Interoperabilidad de herramientas | Universal | Alta, pero selectiva | XLSX |
| Fricción de escaneo de seguridad | Mínimo | Falsos positivos ocasionales | XLSX |
| Capacidad de macros | No (.xlsm required) | Sí (compatible con macros de forma nativa) | Empate |
7. El veredicto del desarrollador
Usa XLSX cuando:
- Los archivos son de tamaño pequeño a moderado (< 50,000 filas).
- Tus archivos deben ser ingeridos por plataformas SaaS de terceros o aplicaciones de consumo (p. ej., Google Sheets).
- No puedes controlar el entorno del cliente final que lee el archivo.
Cambia a XLSB cuando:
- Estás construyendo pipelines internos, trabajos por lotes, sistemas ETL o tareas de trabajo que manejan extracciones masivas de datos (> 100,000 filas).
- Sus servidores están experimentando errores de falta de memoria (OOM) durante la serialización o deserialización de hojas de cálculo.
- Necesita minimizar la huella de almacenamiento en S3/blob y el tiempo de tránsito de red para grandes modelos financieros recurrentes o exportaciones de datos.
Cambiar a XLSB suele ser tan simple como modificar una cadena de configuración en su servicio de exportación, pero brinda mejoras de rendimiento de 3 a 5 veces que normalmente requerirían semanas de optimización de código.
Preguntas frecuentes (FAQ)
**Q1: ¿Un archivo XLSB admite los mismos límites exactos de filas y columnas que un archivo XLSX? Sí; tanto XLSB como XLSX comparten el mismo límite de cuadrícula exacto de 1,048,576 filas por 16,384 columnas por hoja.
**Q2: ¿Puede un archivo XLSB almacenar de forma segura macros VBA sin cambiar su extensión de archivo?
Sí, a diferencia de XLSX (que requiere guardarse como XLSM para ejecutar código), XLSB admite el almacenamiento binario de macros VBA de forma nativa dentro del mismo formato de archivo .xlsb.
**Q3: ¿Por qué guardar un archivo como XLSB reduce su tamaño si ambos formatos ya están comprimidos en ZIP? XLSB elimina las etiquetas de marcado de texto verboso y codifica las posiciones de celdas, los registros y los valores numéricos sin procesar en flujos de bytes binarios compactos que se comprimen mucho más densamente que las cadenas XML simples.
**Q4: ¿Puede Google Sheets importar y editar archivos XLSB directamente?
No; Google Sheets no puede abrir o convertir archivos .xlsb de forma nativa, lo que requiere que los conviertas a .xlsx o CSV antes de importarlos.
**Q5: ¿Los archivos XLSB son más propensos a la corrupción de datos que los archivos XLSX? Aunque los archivos XML a veces pueden inspeccionarse o repararse manualmente con un editor de texto cuando están parcialmente corruptos, los flujos binarios BIFF12 requieren desplazamientos de bytes estrictos y son difíciles de recuperar manualmente si los sectores estructurales están dañados.