آخرین بهروزرسانی: 20 Aug, 2026
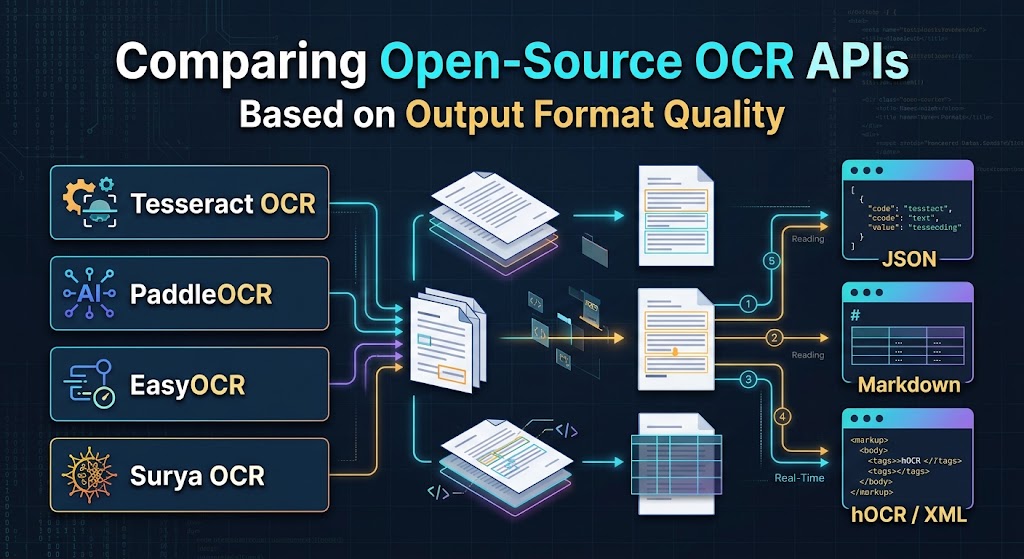
مقایسه APIهای OCR متنباز بر اساس کیفیت قالب خروجی
هنگامی که مهندسان موتورهای تشخیص نوری کاراکتر (OCR) را ارزیابی میکنند، نرخ خطای کاراکتر (CER) و نرخ خطای کلمه (WER) معمولاً بر معیارها تسلط دارند. در حالی که دقت شناسایی ضروری است، تنها نیمی از مشکل در تولید را حل میکند.
اگر در حال تجزیهوتحلیل PDFهای پیچیده چندستونی، استخراج آیتمهای خطی از فاکتورها، یا وارد کردن مقالات سفید به یک خط لوله تعبیه LLM هستید، خروجیهای متنی خام بار مهندسی عظیمی ایجاد میکنند. رشتهای از کاراکترها بدون آگاهی از چیدمان، ترتیب منطقی خواندن یا دادههای مختصاتی تیم شما را مجبور میکند تا پارسرهای هیوستیک شکننده بنویسد.
عامل تمایز واقعی برای جریانهای کاری مدرن اسناد کیفیت فرمت خروجی است: اینکه یک موتور چقدر بهصورت ثابت و تمیز مختصات، ترتیب خواندن، سلسلهمراتب ساختاری و دادههای جدولی را ارائه میدهد.
در زیر مقایسهای متمرکز بر مهندسی از چهار موتور پیشرو OCR متن باز — Tesseract، PaddleOCR، EasyOCR و Surya OCR — ارائه میشود که رفتار خروجیهای آنها درون خطوط لوله خودکار را ارزیابی میکند.
قالبهای خروجی رایج: آنچه مهندسان واقعاً نیاز دارند
هر API OCR متن شناساییشده را بهصورت متفاوتی بستهبندی میکند. درک این فرمتها به شما کمک میکند تا میزان پردازش پس از استخراج که خط لولهتان نیاز دارد را تعیین کنید:
- متن ساده (
.txt): سادهترین نمایش. تمام متادیتای موقعیتی را حذف میکند و طرحهای چندستونی را به خوانشهای افقی تبدیل میسازد که میتواند پاراگرافها را به هم بریزد. - استانداردهای بایگانی (
hOCR,ALTO XML): فرمتهای مبتنی بر XML/HTML که در بایگانی کتابخانهها استاندارد هستند. آنها مختصات، تخمینهای قلم و امتیازهای اطمینان را داخل گرههای DOM جاسازی میکنند. برای بازسازی اسناد بسیار قدرتمندند، اما برای میکروسرویسها سنگین هستند. - JSON ساختار یافته: گزینه پیشفرض برای بکاندهای وب مدرن. آرایههای مختصاتی (جعبههای محدود یا چندضلعیها)، امتیازهای اطمینان و ساختارهای سلسلهمراتبی بلوک/خط/کلمه را ارائه میدهد.
- Markdown (
.md) / جداول HTML: استاندارد مدرن برای تولید تقویتشده با بازیابی (RAG). بخشهای معنایی (سرصفحهها، فهرستها، متن بولد) و ماتریسهای جدولی را حفظ میکند بدون اینکه نیاز به بازسازی فضایی در ادامه داشته باشد.
1. Tesseract OCR
توسط گوگل نگهداری میشود، Tesseract همچنان نیروی اساسی OCR متنباز است. معماری آن به شدت بر الگوریتمهای سنتی تقسیم صفحه تکیه دارد که با یک موتور کاراکتری مبتنی بر LSTM تکمیل میشود.
فرمتهای خروجی بومی
- خروجیهای اصلی: متن ساده، hOCR (HTML)، ALTO XML، TSV (مقادیر جدا شده با تب)، و PDF/A قابل جستجو.
- آگاهی از طرحبندی: هورستیکهای مبتنی بر قواعد از طریق حالتهای تقسیمبندی صفحه (PSM).
تحلیل فرمت خروجی
- جایی که برتری دارد: خروجیهای
TSVوhOCRتسرکت استاندارد و پیشبینیپذیر هستند. یک خروجی TSV واحد ستونهای ساختاریافتهای برایlevel،page_num،block_num،par_num،line_num،word_num،left،top،width،heightوconfبرمیگرداند. اگر در حال تبدیل آرشیوهای کاغذی به PDFهای قابل جستجو هستید یا به پیروی دقیق از استانداردهای مؤسسهای نیاز دارید، تسرکت این کار را بهصورت بومی بدون کد چسباندن سفارشی انجام میدهد. - جایی که کمبود دارد: تسرکت API JSON بومی ندارد. استفاده از خروجی آن در Python یا Node.js نیاز به تجزیه فایلهای XML/TSV یا استفاده از wrapperهایی مانند
pytesseractدارد. موتور طرحبندی آن همچنین با جریان ستونی غیر استاندارد مشکل دارد و اغلب متن را از ستونهای مجاور مخلوط میکند مگر اینکه برشهای مرزی دستی ارائه شوند.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
۲. PaddleOCR
پشتیبانیشده توسط چارچوب PaddlePaddle شرکت Baidu، PaddleOCR بهدلیل مدلهای سبک وزن، پوشش گسترده چندزبانه، و جعبه ابزار تحلیل سند اختصاصی (PP-Structure) بهسرعت مورد پذیرش گستردهای قرار گرفته است.
فرمتهای خروجی بومی
- خروجیهای اصلی: لیستها/دیکشنریهای پایتون، JSON خام، لایههای بصری، و HTML ساختار یافته از طریق PP-Structure.
- آگاهی از چیدمان: بالا (با استفاده از مدلهای یادگیری عمیق برای تجزیه چیدمان، طبقهبندی جهتگیری، و بازیابی جدول).
تحلیل فرمت خروجی
- جایی که برتری دارد: PaddleOCR استاندارد مختصات چندضلعی ۴ نقطهای (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) را همراه با رشتههای متنی و امتیازهای اطمینان برمیگرداند. این بهصورت روان متنهای کج یا منحنی را مدیریت میکند. با این حال، قوت واقعی آن در مجموعه PP-Structure نهفته است که نواحی چیدمان (عنوان، متن، جدول، شکل) را شناسایی کرده و جداول را مستقیماً به رشتههای HTML معتبر (<table>...</table>) تجزیه میکند. این نیاز به محاسبه دستی بازههای سلول از جعبههای مرزی را از بین میبرد. - جایی که کوتاهی میکند: API پایه آرایههای تو در تویی را برمیگرداند که کلیدهای ویژگی استانداردی در نسخههای مختلف ندارند. برای برنامههای ساختار یافته، توسعهدهندگان معمولاً یک آداپتور میانی مینویسند تا نام فیلدها (
bbox,text,confidence) را استاندارد کنند.
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
۳. EasyOCR
ساخته شده بر پایه PyTorch توسط JaidedAI، EasyOCR برای پذیرش سریع توسط توسعهدهندگان طراحی شده است. این ابزار CRAFT (آگاهی از ناحیه کاراکتر برای تشخیص متن) را همراه با شبکههای شناسایی یادگیری عمیق در یک API کمینه بستهبندی میکند.
فرمتهای خروجی بومی
- خروجیهای اصلی: لیستهای پایتون شامل تاپلهای مختصات، رشتههای شناساییشده و مقادیر اطمینان.
- آگاهی از چیدمان: کم تا متوسط (فقط تشخیص خطوط متن؛ بدون تجزیه و تحلیل ساختاری در سطح سند).
تحلیل فرمت خروجی
- جایی که برتری دارد: سادگی شی بازگشتی بینظیر است:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
تبدیل این خروجی به یک پاسخ استاندارد REST یا سریالسازی مستقیم آن به GeoJSON/طرحهای سفارشی تنها چند خط کد نیاز دارد. این روش بهصورت قابل اعتماد بر روی متنهای صحنه طبیعی، پلاکهای خودرو و برشهای جداگانه سند عمل میکند.
- جایی که کمبود دارد: EasyOCR تجزیه و تحلیل جامع چیدمان سند را انجام نمیدهد. این ابزار جداول، سلسلهمراتب عناوین یا ترتیب خواندن در ستونهای پیچیده را شناسایی نمیکند. استفاده از EasyOCR بر روی یک مقاله علمی دو ستونی اغلب قطعات متن درهمتنیده تولید میکند مگر اینکه با یک مدل تشخیص چیدمان پیشدستی (مانند YOLO یا LayoutLM) ترکیب شود.
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
۴. سوریا OCR
Surya یک چارچوب OCR مبتنی بر یادگیری عمیق مدرن است که بهطور خاص برای درک اسناد پیچیده و خطوط لولهٔ ورودی LLM طراحی شده است.
فرمتهای خروجی بومی
- خروجیهای اصلی: ساختارهای JSON مدلسازیشده با Pydantic، شاخصهای ترتیب منطقی خواندن، نواحی مرزی چیدمان، و چندضلعیهای تشخیص خط.
- آگاهی از طرح: بهطور فوقالعاده بالا (تحلیل طرح مبتنی بر یادگیری عمیق و مرتبسازی ترتیب خواندن).
تحلیل فرمت خروجی
- جایی که برتری دارد: سوریا بهطور مستقیم به چالشهای مهندسی هوش مصنوعی مدرن میپردازد. بهجای فرض اینکه اسناد از بالا به پایین و از چپ به راست خوانده میشوند، سوریا یک مدل اختصاصی برای پیشبینی ترتیب خواندن بهکار میگیرد. این مدل خطوط را به بلوکهای معنایی منطقی گروهبندی میکند، بهطور طبیعی بازههای چندستونی را مدیریت میکند و ساختارهای تایپشده را از طریق Pydantic خروجی میدهد. این باعث میشود که ورود دادهها به پایگاههای برداری و مبدلهای Markdown بهصورت مستقیم و قابل اعتماد باشد.
- جایی که کمبود دارد: بهعنوان یک چارچوب جدیدتر و سنگینتر مبتنی بر PyTorch، سوریا برای همخوانی با توان پردازشی بهینهسازیشده موتورهای C++ مانند Tesseract یا مدلهای Paddle کمّیسازیشده، به محاسبه GPU اختصاصی نیاز دارد. این چارچوب هدفگذاری برای استانداردهای آرشیوی قدیمی مانند hOCR یا ALTO را ندارد.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
ماتریس مقایسه سر به سر
| قابلیت / قالب | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| hOCR بومی / ALTO XML | پشتیبانی بومی | فقط شخص ثالث | هیچکدام | هیچکدام |
| هندسه جعبه محدود | محور-محور (x, y, w, h) | چندضلعی ۴ نقطهای | چندضلعی ۴ نقطهای | چندضلعی + بلوکهای طرح |
| تحلیل جدول | فقط TSV مختصات | رشتههای جدول HTML | هیچکدام | شبکههای مختصات سلول |
| تشخیص ترتیب خواندن | قائم بر قواعد (شکست در چندستونی) | تحلیل چیدمان با یادگیری ماشین | گروهبندی خطی پایه | مدل ترتیبخوانی اختصاصی |
| طرحهای مستقیم JSON | نیاز به تبدیل | دیکشنری پایتون / JSON | لیست پایتون / JSON | مدلهای تایپشده Pydantic |
| هدف پاییندستی ایدهآل | PDFهای بایگانی، DMSهای قدیمی | دادههای فرم/رسید، ERPها | اسکریپتهای سریع، متن صحنه | ورودی LLM، معماریهای RAG |
پیشنهادات خط لوله: کدام را باید انتخاب کنید؟
- Choose Tesseract اگر الزامات انطباق شما نیاز به خروجیهای استاندارد
hOCR،ALTO XMLیا PDF/A قابل جستجو برای اسناد دولتی یا آرشیوی دارد. - Choose PaddleOCR اگر در حال پردازش اسناد مالی عملیاتی (فاکتورها، رسیدها، فرمهای مالیاتی) هستید که شامل جدولهای پیچیده و بدون حاشیه میشوند و باید به HTML یا صفحات گسترده تبدیل شوند.
- Choose EasyOCR اگر به یک کتابخانه سبک، پایتونیک برای تشخیص و استخراج متن از تصاویر طبیعی، تابلوهای خیابانی یا عناصر UI برشخورده بدون دردسر پیکربندی نیاز دارید.
- Choose Surya OCR اگر گزارشهای تجاری نامنظم، مقالات پژوهشی و راهنماییهای فنی را به یک LLM یا موتور جستجوی برداری میفرستید که ترتیب منطقی خواندن و مرزهای ساختاری تمیز در آن اهمیت دارند.
سوالات متداول (FAQ)
۱. کدام فرمت خروجی OCR متن باز به راحتی میتواند به مدلهای زبانی بزرگ تغذیه شود؟
JSON آگاه از ترتیب خواندن Surya OCR و جدولهای HTML ساختار PP-Structure PaddleOCR تمیزترین نمایشها را برای زمینههای پرامپت LLM و ایندکسگذاری RAG فراهم میکنند.
۲. آیا تسرکت میتواند پاسخهای JSON را بهصورت بومی بدون ابزارهای شخص ثالث تولید کند؟
نه، Tesseract بهصورت بومی متن، TSV، PDF و hOCR/ALTO XML را خروجی میدهد؛ تولید JSON نیاز به تبدیل خروجی TSV یا hOCR آن با استفاده از یک تجزیهگر میانی دارد.
۳. مختصات چندضلعی ۴ نقطهای چگونه با جعبههای محدود کننده محوری متفاوت هستند؟
جعبههای محورمحور از قالب [x, y, width, height] استفاده میکنند که متن صاف را فرض میکند، در حالی که چندضلعیهای ۴‑نقطهای چهار جفت مختصات را فراهم میآورند تا خطوط متن چرخیده، کجشده یا منحنی را بهدقت محصور کنند.
۴. کدام موتور ساختارهای جدول را مستقیماً به کد خروجی میدهد بهجای مختصات پراکنده؟
ماژول PP-Structure در PaddleOCR مرزهای جدول شناساییشده را به برچسبهای کامل جدول HTML (<table>, <tr>, <td>) بازسازی میکند و از ریاضیات فضایی سفارشی جلوگیری مینماید.
۵. چرا خروجی استاندارد EasyOCR در مقالات علمی چندستونی مشکل دارد؟
EasyOCR خطوط متن را بر اساس نزدیکی محلی شناسایی میکند نه بر پایه سلسلهمراتب کلی چیدمان، که باعث میشود متن ستونهای مجاور بهیکدیگر درهمتنیده شوند مگر اینکه توسط یک موتور چیدمان خارجی محدود شوند.