آخرین بهروزرسانی: 20 Aug, 2026
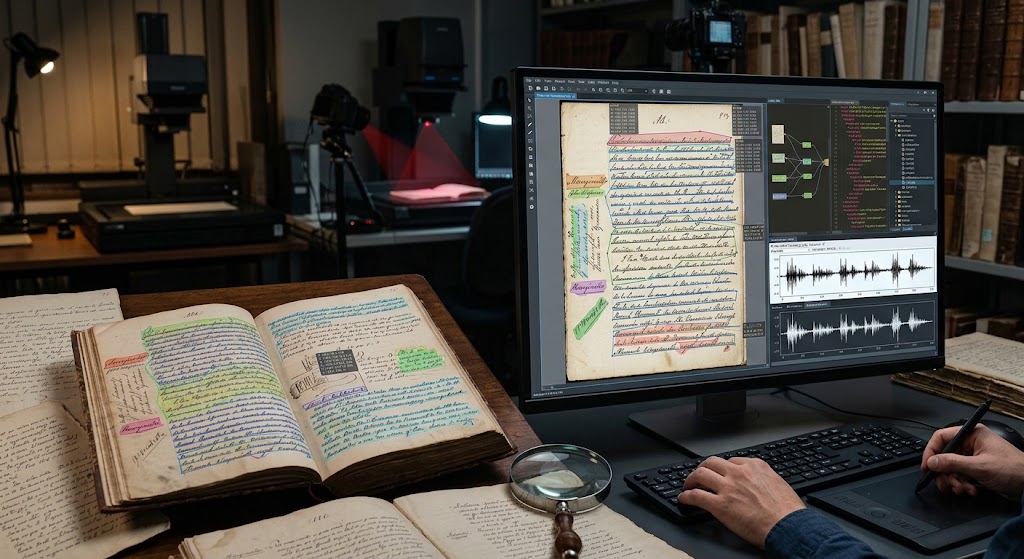
قالبهای فایل OCR برای اسناد تاریخی و دستنویس
حفظ میراث فرهنگی از طریق دیجیتالیسازی وارد دورهای از رنسانس شده است. در حالی که سیستمهای اولیه تشخیص نوری کاراکتر (OCR) برای پردازش اسناد بینقص و چاپماشینی قرن بیستم طراحی شده بودند، مؤسسات مدرن میراث فرهنگی با چالشی بسیار پیچیدهتر و غنیتر مواجه هستند: نسخههای خطی قرون وسطی، مکاتبات دستنویس قرن نوزدهم، صفحات نورانی شکننده، و ثبتنامهای صدساله.
رونوشتبرداری از اسناد تاریخی دیگر فقط به استخراج متن ساده ASCII محدود نیست. این کار نیاز به ضبط زمینه—ژئومتری فیزیکی صفحه، منحنیهای خط پایه، اصلاحات نفوذ رنگ، حاشیهنویسیها، اختصارات و عدم قطعیت پالیوگرافی. این حوزه تخصصی که اغلب تحت دستهبندی تشخیص متن دستنویس (HTR) قرار میگیرد، به شدت به فرمت فایل مورد استفاده برای ذخیره و تبادل هر دو مختصات تصویر و لایههای متنی وابسته است.
انتخاب طرحوارهٔ نادرست میتواند دادههای حیاتی خط پایه را حذف کند، همراستایی با مانیفستهای IIIF (International Image Interoperability Framework) را خراب کند، یا مانع از حفظ دیجیتال بلندمدت شود. در اینجا یک راهنمای قطعی برای فرمتهای برتر فایلهای OCR و HTR برای اسناد تاریخی، نقاط قوت ساختاری آنها، و چگونگی تعیین انتخاب مناسب برای خط لولهٔ بایگانی شما ارائه شده است.
معضل تاریخی: چرا متن ساده و استاندارد PDFها شکست میخورند
OCR چاپماشینی اغلب فایلهای سادهٔ .txt یا PDFهای “ساندویچی” با لایههای متن مخفی زیر اسکن را خروجی میدهد. برای نسخههای تاریخی و دستخطهای خوشخط، این خروجیها به دلایل اصلی سهگانهای ناکام میمانند:
- متن غیرخطی و چیدمانهای پیچیده: نویسندگان تاریخی به شبکههای مستطیلی منظم پایبند نبودند. متن به حاشیهها جاری میشود، دور حروف بزرگ نورانی میپیچد، بین اصلاحات بینخطی درجشده میدرخشد، یا به صورت عمودی در طول پشت کتاب میچرخد.
- خط پایههای منحنی و مایل: نوشتار دستخط به ندرت محور افقی سفت و سختی را دنبال میکند. موتورهای HTR مانند Transkribus، Kraken و eScriptorium به جای جعبههای محدودکننده، بر خطوط پایه چندخطی برای تفسیر اسکریپتهای پر از لیگچر تکیه میکنند.
- پیچیدگی پالیگرافی و فرادادهها: پژوهشهای بایگانی نیاز به ردیابی اختصارات، تغییرات املایی تاریخی، خوانشهای آسیبدیده و امتیازهای اطمینان در سطح خط دارند. فرمتهای استاندارد سند این جزئیات را حذف میکنند.
برای حفظ صحت به شیء اصلی، جامعه بایگانی بر طرحوارههای XML ساختاریافتهای که برای حفظ توپولوژی چیدمان همراه با متن رونویسیشده طراحی شدهاند، تکیه میکند.
1. PAGE XML: استاندارد طلایی برای تشخیص متن دستنویس (HTR)
توسط آزمایشگاه تحقیقاتی PRImA (تشخیص الگو و تحلیل تصویر) توسعه یافته، PAGE XML (عناصر تجزیه و تحلیل صفحه و حقیقت پایه) به طور گسترده به عنوان فرمت پیشرفتهترین برای تشخیص متن دستنویس و تجزیه و تحلیل پیشرفته چیدمان شناخته میشود.
معماری اصلی
PAGE XML سند فیزیکی را به عنوان یک ساختار سلسلهمراتبی در نظر میگیرد:
PcGts(ریشه)Page(ابعاد تصویر و ترتیب خواندن کلی)TextRegion(پاراگرافها، عناوین، حاشیهنویسیها، کلمات کلیدی)TextLineCoords(مختصات چندضلعی اطراف خط)Baseline(یک سری نقطه که خط پایه واقعی متن را دنبال میکند)TextEquiv(متن شناساییشده، با معیارهای اختیاری اطمینان)
چرا برای نسخههای خطی تاریخی برتر است
- دقت چندضلعی و چندخطی: بهجای مجبور کردن حروف به جعبههای مستطیلی، PAGE XML از مرزهای چندنقطهای چندضلعی و خطوط پایه پیوسته استفاده میکند. این کار از تداخل حروف دستنویس با بالا رفتنها و پایین رفتنها که میتواند بر تقسیمبندی تأثیر بگذارد، جلوگیری میکند.
- انواع ساختاری جزئی: نواحی میتوانند بهدقت طبقهبندی شوند (مثلاً
marginalia،drop-capital،signature-mark،header،editorial-note). - اکوسیستم گسترده نرمافزاری: به عنوان طرحوارهٔ اصلی داخلی و صادراتی برای پلتفرمهای برجسته HTR مانند Transkribus، eScriptorium و Kraken عمل میکند.
2. ALTO XML: قدرتمند کتابخانهای و بایگانی
ALTO (Analyzed Layout and Text Object) یک استاندارد باز XML است که توسط کتابخانه کنگره نگهداری میشود و بهطور گستردهای توسط کتابخانههای ملی، از جمله Bibliothèque nationale de France (BnF) و کتابخانه بریتانیا، پذیرفته شده است.
معماری اصلی
ALTO ساختار چیدمان را بهصورت سلسلهمراتبی از Page تا PrintSpace و سپس به TextBlock، TextLine و String (کلمات یا توکنهای منفرد) تعریف میکند. این استاندارد اغلب داخل یک بستهٔ METS (Metadata Encoding and Transmission Standard) قرار میگیرد تا متادیتای ساختاری را با تصاویر اصلی با وضوح بالا مرتبط سازد.
نقاط قوت کلیدی و موارد استفاده
- گردشکارهای دیجیتالیسازی انبوه: ALTO با در نظر گرفتن دیجیتالیسازی صنعتی روزنامهها و کتابها طراحی شده است. این استاندارد بهصورت تمیز ویژگیهای قلم، مختصات سطح کلمه، اطمینان کاراکتر و فواصل سفید را کدگذاری میکند.
- پشتیبانی مدرن HTR (ALTO 4): نسخههای قبلی ALTO به شدت بر مختصات مستطیلی (
HPOS,VPOS,WIDTH,HEIGHT) تکیه داشتند. اما با شروع نسخه 4 ALTO، طرحواره<Shape>چندضلعیها و خطوط پایه پلیلاین را معرفی کرد و شکاف عملکردی با PAGE XML برای مواد دستنویس را پر کرد. - حفظ طولانیمدت: چون یک استاندارد رسمی است که توسط کنسرسیومهای بینالمللی کتابخانهها پشتیبانی میشود، ALTO پایداری طولانیمدت و سازگاری عقبگرد در سطح آرشیوی را تضمین میکند.
3. hOCR: استاندارد وب-محور، سبک وزن
ساخته شده توسط توماس بروئل، hOCR رویکردی عملی اتخاذ میکند: به جای ایجاد یک طرحواره XML کاملاً جدید، متادیتای چیدمان و رونوشت را مستقیماً در HTML/XHTML معنایی با استفاده از میکروفورمتها و ویژگیهای کلاس جاسازی میکند.
مثال معمولی نحو
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class=\"ocr_line\" id=\"line_1_1\" title=\"bbox 150 320 2200 410; baseline 0 -5\">\n        <span class=\"ocrx_word\" id=\"word_1_1\" title=\"bbox 150 325 380 405; x_wconf 92\">مقدمه</span>\n      </span>
    </p>
  </div>
</div>
مزایا و معایب برای مواد تاریخی
- مزایا: مرورگرها میتوانند آن را بهصورت بومی رندر کنند. به راحتی با استفاده از CSS و JavaScript ساده قابل تبدیل است و فرمت خروجی ساختار یافته پیشفرض برای موتورهایی مانند Tesseract میباشد.
- معایب: پشتیبانی بومی برای منحنیهای پایه چندنقطهای پیچیده و آزاد محدود است. اگرچه برای آثار چاپی اولیه (اینکونابولا یا برگههای تمیز) عملی است، hOCR با چیدمانهای دستنویس ناپایدار و حاشیهنویسیهای چندلایه مشکل دارد.
4. TEI-XML: معیار آکادمیک و علوم انسانی دیجیتال
فرمت Text Encoding Initiative (TEI) بهطور دقیق فرمت خروجی یک موتور OCR نیست؛ بلکه استاندارد برتر برای نسخههای دیجیتال انتقادی و نمایش علمی متون ادبی و تاریخی است.
اتصال OCR/HTR به TEI
خطوط لولهٔ مدرن بهندرت فقط به تشخیص کاراکترهای خام متوقف میشوند. پژوهشگران از ابزارهایی مانند Transkribus TEI Exporter یا خطوط لولهٔ خودکار XSLT برای تبدیل فایلهای PAGE XML یا ALTO به XML سازگار با TEI استفاده میکنند:
- اختصارات گسترش مییابند (
<choice><abbr>...</abbr><expan>...</expan></choice>). - حذفها، افزودنیها و دستنویسهای خطاطی بهصورت رسمی طبقهبندی میشوند (
<add>,<del>,<handShift>). - دادههای چیدمان همراه با تحلیل ادبی از طریق عناصر
<facsimile>و<surface>حفظ میشوند.
اگر پروژهٔ تاریخی شما هدف ایجاد یک نسخهٔ انتقادی تعاملی یا آرشیوی علمی با قابلیت جستجوی معنایی را دارد، تبدیل دادههای OCR/HTR شما به TEI-XML اغلب گام نهایی مورد نیاز است.
ماتریس مقایسهای: فرمتهای OCR/HTR در یک نگاه
| ویژگی / معیار | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| حوزه اصلی | تشخیص دستخط خوشخط و نسخههای خطی | دیجیتالیسازی کتابخانههای بزرگ | OCR وب و جستجوی سبک | نسخههای انتقادی علمی |
| پشتیبانی پایه | پلیلاینهای بومی، چندنقطهای | پشتیبانی شده (از نسخه ۴.۰) | پایه (شیب/جابهجایی) | از طریق نقشهبرداری فاکسیمیل |
| چندضلعیهای نامنظم | کامل | کامل | محدود | از طریق عناصر مختصاتی |
| اکوسیستم ابزارها | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, نمایشگرهای وب | Oxygen, TEI Publisher |
| نهاد استانداردسازی | PRImA Group / Open | کتابخانه کنگره | مشخصات جامعه | کنسرسیوم TEI |
توصیههای عملی: انتخاب خط لوله بایگانی شما
برای ایجاد یک خط لوله دیجیتالی کارآمد و آیندهنگر:
- برای دستنوشتهها و آرشیوهای کاملاً دستنویس: استانداردسازی رونوشت و استخراج چیدمان خود بر روی PAGE XML. محاسبه خط پایه و ترسیم چندضلعی آن، دستخطهای غیر استاندارد را با حداقل از دست رفتن دادهها مدیریت میکند.
- برای کتابخانههای بزرگمقیاس و مجموعههای ترکیبی: از ALTO XML (v4.2 یا بالاتر) همراه با METS استفاده کنید. این کار یکپارچهسازی بدون درز را در معماریهای استاندارد مخازن دیجیتال و سیستمهای مدیریت داراییهای دیجیتال (DAMS) تضمین میکند.
- برای ارائه وب و فهرستهای جستجوی متن کامل: از hOCR استفاده کنید یا ساختارهای سبک وزن GeoJSON/Web Annotation را از PAGE XML استخراج کنید تا نمایشگرهای تعاملی IIIF (مانند Mirador یا Universal Viewer) را با لایههای متن زنده در مرورگر هدایت کنید.
- برای نسخههای علمی و پژوهشهای پالیوگرافی: دادههای مرجع خود را در قالب PAGE XML تولید کنید، شناسایی را انجام دهید و خروجی را از طریق یک مبدل خودکار عبور دهید تا TEI-XML برای نشانهگذاری ویرایشی تولید شود.
با تطبیق قابلیتهای ساختاری این فرمتها با نیازهای پالیوگرافی مواد منبع خود، اطمینان مییابید که هر خط، اختصار و نکته تاریخی برای قرنها قابل درک باقی میماند.
سوالات متداول (FAQ)
س.۱. تفاوت اساسی بین OCR استاندارد و HTR چیست؟ OCR حروف چاپی ثابت ماشین را شناسایی میکند، در حالی که HTR (تشخیص متن دستنویس) از شبکههای عصبی عمیق برای رمزگشایی دستنویس انسانی متغیر و پیوسته و خطوط پایه منحنی استفاده میکند.
س.۲. آیا Tesseract OCR میتواند خروجی PAGE XML یا ALTO برای اسناد تاریخی تولید کند؟ بله، Tesseract میتواند XML بومی ALTO و خروجی hOCR تولید کند و بستههای جانبی شخص ثالث میتوانند این نتایج را به PAGE XML تبدیل کنند.
س.۳. چرا خطوط پایه نسبت به جعبههای محدودکننده در رونویسی متن دستنویس مهمتر هستند؟ خطوط پایه مسیر طبیعی و موجدار نوشتار انسانی را دنبال میکنند و به نرمافزار امکان میدهند تا حروف بالارونده و پایینروندهٔ همپوشانی که در جعبههای محدودکننده سفت برخورد میکنند، جدا کنند.
سوال ۴. استاندارد IIIF چگونه با این فرمتهای فایل OCR تعامل میکند؟ IIIF تصاویر با وضوح بالا را از طریق APIهای وب باز ارائه میدهد، در حالی که فرمتهایی مانند ALTO یا PAGE XML دادههای مختصاتی را فراهم میکنند که میتوانند به حاشیهنویسیهای جستجوی محتوا در IIIF تبدیل شوند.
سوال ۵. کدام فرمت فایل بهراحتی میتواند مستقیماً به PDF جستجوپذیر تبدیل شود؟ هر دو hOCR و ALTO XML میتوانند با تصاویر اصلی صفحات ترکیب شوند تا فایلهای PDF دو لایه جستجوپذیر را با استفاده از ابزارهایی مانند OCRmyPDF بسازند.