آخرین بهروزرسانی: 30 Sept, 2026
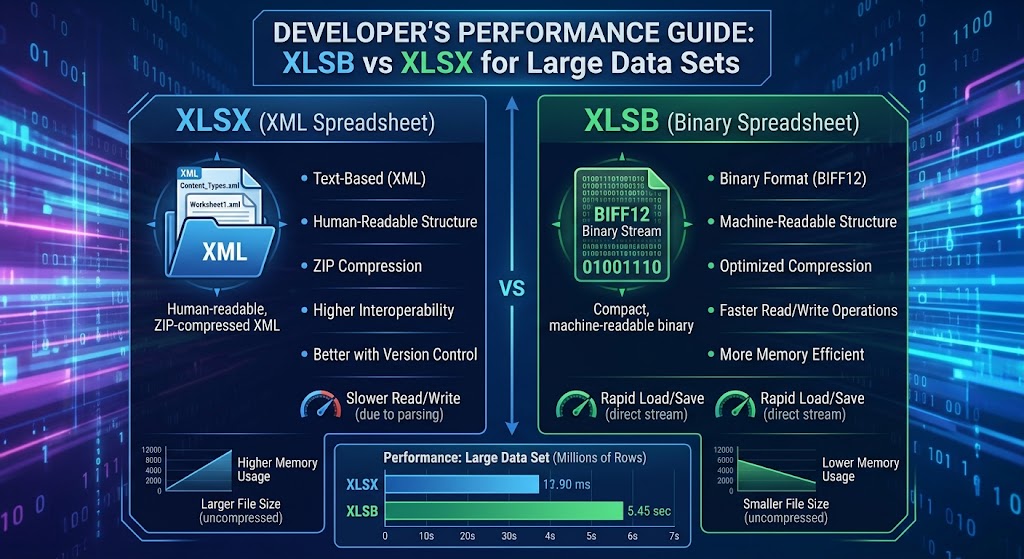
XLSB در مقابل XLSX برای مجموعههای داده بزرگ: راهنمای عملکرد برای توسعهدهندگان
اگر شما خطوط داده، موتورهای گزارشگیری بکاند، یا ابزارهای تحلیلی که با Microsoft Excel ارتباط دارند را میسازید، احتمالاً به “دیوار” برخورد کردهاید.
کاربری یک کتابکار ۴۵۰,۰۰۰ ردیفی آپلود میکند. سرور شما نخهای کاری را فعال میکند، مصرف حافظه به گیگابایتها میرسد، جمعآوری زباله زمان اجرا را متوقف میکند و اجرای شما زمانسنجی میشود. شما بار را بررسی میکنید: این یک فایل استاندارد .xlsx است.
برای حل این مشکل، توسعهدهندگان اغلب روزها را صرف پیادهسازی تقسیمبندی، تجزیهکنندههای جریاندار یا انتقال فایلها به کارگرهای پسزمینه میکنند. با این حال، یکی از مؤثرترین بهینهسازیها بدون نیاز به بازطراحی معماری انجام میشود: تغییر پسوند فایل از .xlsx به .xlsb.
در این راهنما، به عمق هر دو قالب میپردازیم، دلیل تفاوتهای اساسی در معماری داخلی آنها که منجر به ویژگیهای عملکردی متفاوت میشود را بررسی میکنیم، بنچمارکهای ملموس را در Python و .NET مقایسه میکنیم و قوانین واضحی برای زمان استفاده از کتابکارهای باینری در محیط تولید ارائه میدهیم.
1. زیر پوسته: OpenXML در مقابل BIFF12
برای درک اینکه چرا عملکرد در مجموعهدادههای بزرگ به این شدت متفاوت میشود، باید نگاهی به نحوه ذخیرهسازی رکوردها توسط هر قالب بر روی دیسک بیندازیم.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
هر دو فایل .xlsx و .xlsb حاوی بستههای فشرده ZIP هستند که با استاندارد Open Packaging Conventions (OPC) سازگارند. اگر هر یک از این فایلها را به .zip تغییر نام دهید و استخراج کنید، ساختار دایرکتوری آشنایی خواهید دید: _rels، docProps و xl/worksheets/.
تفاوت اساسی در داخل پوشه xl/worksheets/ قرار دارد:
- XLSX شیتها را به صورت متن ساده XML (
sheet1.xml) ذخیره میکند. - XLSB شیتها را به صورت جریانهای باینری اختصاصی (
sheet1.bin) ذخیره میکند که با استفاده از BIFF12 مایکروسافت (Binary Interchange File Format 12) رمزگذاری شدهاند.
چگونه XLSX دادهها را رمزگذاری میکند (XML DOM Overhead)
در یک ورکشیت XLSX، هر سلول با تگهای صریح XML تعریف میشود:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
هنگام خواندن این ردیف، زمان اجرا باید:
- جریان فشردهسازی raw deflate را به متن باز کنید.
- کاراکترهای رشته را توکنیزه و تجزیه کنید تا به یک DOM XML یا جریان رویدادهای SAX تبدیل شوند.
- اعتبارسنجی تگهای باز و بسته (
<c>،</c>،<v>،</v>). - جستجوهای رشتهای را از جدول جداگانه
sharedStrings.xmlحل کنید. - متن ASCII
"98234.55"را به عدد شناور ۶۴ بیتی IEEE 754 تجزیه کنید.
هر سلول بهتنهایی هزینه پردازش CPU برای تجزیه رشته، تخصیص رشته و تجزیهلغوی را بههمراه دارد. این را در ۵۰۰,۰۰۰ ردیف و ۳۰ ستون (۱۵ میلیون سلول) ضرب کنید و CPU بهمراتب بیشتر سیکلها را صرف تجزیه سینتکس میکند تا پردازش مقادیر دامنه.
چگونه XLSB دادهها را رمزگذاری میکند (BIFF12 Binary Stream)
BIFF12 بهطور کامل سریالسازی متن را حذف میکند. بهجای نشانهگذاری رشته، دادهها بهصورت یک توالی متوالی از رکوردهای باینری با طول متغیر سازماندهی میشوند:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
یک سلول عدد شناور در BIFF12 از نمایشهای رشتهای مانند "98234.55" استفاده نمیکند. بهصورت مستقیم نمایش داده میشود:
- ۲ بایت برای شناسه رکورد (مثلاً
BrtCellRkیاBrtCellReal) - ۴ بایت برای شاخصهای ستون/ردیف
- ۸ بایت شامل ساختار بایت خام، IEEE 754 با دقت دو برابر
وقتی تجزیهکننده شما یک فایل XLSB را میخواند، بهطور کامل از تجزیه لغوی عبور میکند. هدر رکورد را میخواند، ۸ بایت خام را از بافر میگیرد، مستقیماً در حافظه کپی میکند و اشارهگر را به جلو میبرد. هیچ برچسبی برای اعتبارسنجی وجود ندارد، هیچ تبدیل نوع رشته به عددی نیست و هزینهای برای رمزگشایی UTF-8 دادههای عددی وجود ندارد.
۲. معیارهای کمی: دیسک، حافظه، و سرعت
برای نشان دادن تأثیر واقعی، یک مجموعه داده شبیهسازیشده شامل 750,000 ردیف و 25 ستون (ترکیبی از زمانمهرها، اعداد شناور، اعداد صحیح و کدهای دستهبندی) را در نظر بگیرید.
آزمونهای زیر دادههای جدولی یکسان ذخیرهشده بهصورت XLSX و XLSB را ارزیابی میکنند.
محیط تست
- CPU: AMD Ryzen 9 5900X (۱۲ هسته، ۲۴ رشته)
- RAM: ۶۴ گیگابایت DDR4-3600
- حافظه: PCIe 4.0 NVMe SSD
- زمان اجرا: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
معیارهای کلیدی عملکرد
| متریک | XLSX (OpenXML) | XLSB (BIFF12) | دلتا / بهبود |
|---|---|---|---|
| اندازه فایل روی دیسک | 128.4 MB | 68.2 MB | ~۴۷٪ کوچکتر |
| ذخیره / زمان سریالسازی | 42.6 ثانیه | 14.1 ثانیه | ۳.۰× سریعتر |
| زمان خواندن (Python DOM parser) | 38.2 ثانیه | 8.9 ثانیه | ۴.۳× سریعتر |
| زمان خواندن (موتور Rust/C) | 6.4 s | 1.9 s | ۳٫۳ برابر سریعتر |
| حداکثر تخصیص Heap در حین خواندن | ~1.85 GB | ~510 MB | ~۷۲٪ کاهش |
چرا فایلهای XLSB کوچکتر هستند
در حالی که هر دو قالب از فشردهسازی استاندارد ZIP استفاده میکنند، جریانهای باینری بسیار کارآمدتر از متن XML حجیم فشرده میشوند:
- حذف سینتکس تکراری: XML شامل برچسبهای تکراری (
<c r=\"AA1\" s=\"1\">) در هر رکورد است. در حالی که فشردهسازی ZIP رشتههای تکراری را کاهش میدهد، جریان دادهٔ بدون فشردهسازی بسیار بزرگ است. - چگالی عددی: در XML، عدد
12345678.9012به ۱۴ بایت متن ASCII نیاز دارد. در BIFF12، این عدد به صورت یک عدد دوگانهٔ ۸ بایتی ذخیره میشود (یا در صورتی که با قوانین دقت خاص سازگار باشد، در یک رکوردRK۴ بایتی فشرده میشود).
۳. ردپای حافظه و فشار جمعآوری زباله
برای سرویسهای وب و میکروسرویسهایی که درخواستهای همزمان را مدیریت میکنند، سرعت CPU تنها نیمی از مسأله است؛ حجم حافظه جایی است که برنامهها در واقع شکست میخورند.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
هنگامی که یک پارسر XML یک فایل XLSX به حجم ۱۰۰ مگابایت را پردازش میکند، باید هزاران توکن رشتهای موقت، بافرهای برش رشته و جستجوهای دیکشنری ایجاد کند. در زبانهای جمعآوری زباله (Java، C#، Go، Node.js، Python) این امر منجر به تکهتکه شدن شدید هپ میشود و زمان اجرا را به توقفهای مکرر جمعآوری زباله (GC) میکشاند.
به دلیل اینکه تجزیه XLSB مستقیماً بر روی برشهای بایتی با عرض ثابت عمل میکند، تجزیهکنندهها میتوانند دادهها را به ساختارهای اختصاصیافته به پشته یا بافرهای بایتی قابل استفاده مجدد بخوانند. نتیجه، کاهش چشمگیر مصرف حافظه و عدم ایجاد فشار بر تخصیصدهنده زمان اجرا است.
۴. مثالهای پیادهسازی توسعهدهنده
بیایید نگاهی بیندازیم به اینکه چگونه میتوان از XLSB در زنجیره ابزارهای رایج توسعهدهندگان بهرهبرداری کرد:
پایتون: مهاجرت از OpenPyXL به Calamine / PyXLSB
متد استاندارد pandas.read_excel('data.xlsx') بهصورت پیشفرض از openpyxl استفاده میکند، که یک درخت سنگین در حافظه میسازد.
برای پردازش فایلهای بزرگ XLSB با حداکثر سرعت، از موتور calamine مبتنی بر Rust استفاده کنید (از طریق python-calamine در دسترس است و در Pandas مدرن یکپارچه شده است):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
اگر در حال پیمایش مجموعهدادههای عظیم بهصورت ردیف به ردیف بدون بارگذاری کل ماتریس در یک DataFrame هستید، pyxlsb یک تکرارگر جریاندار سبک وزن ارائه میدهد:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: دریافت جریان با عملکرد بالا
در .NET، کتابخانههایی مانند ClosedXML یا EPPlus برای تولید استاندارد عالی هستند، اما برای خواندن فایلهای بزرگ بدون مصرف بیش از حد حافظه، ExcelDataReader با پشتیبانی از XLSB بهطور استثنایی سریع است:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. تعادلهای معماری: چه زمانی نباید از XLSB استفاده کرد
علیرغم مزایای عملکردی شگفتانگیز آن، XLSB یک راهحل جادویی نیست. قبل از اعمال آن در تمام لایههای سیستم خود، باید چندین تعادل عملیاتی را مدنظر داشته باشید:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. پشتیبانی اکوسیستم و کتابخانهها
- XLSX: جهانی. عملاً هر زبان، کتابخانه، ابزار SaaS (Google Sheets, Airtable, Tableau) و تجزیهکننده وب بهصورت بومی از OpenXML پشتیبانی میکند.
- XLSB: کمتر رایج. در حالی که Excel، LibreOffice و کتابخانههای پیشرفته توسعهدهندگان (
ExcelDataReader،pyxlsb،calamine،Aspose) از آن پشتیبانی میکنند، بسیاری از بستههای سبک یا تجزیهکنندههای وب‑محور جاوااسکریپت خالص (مانند نسخههای قدیمیSheetJS) پشتیبانی محدودی یا فقط‑خواندنی دارند.
2. مقایسه تغییرات در Git و کنترل نسخه
- XLSX: چون حاوی XML متنی داخل یک بسته ZIP است، ابزارهای خط فرمان و هوکهای Git میتوانند آن را unzip کرده و XML را قالببندی کنند تا تفاوتهای ساختاری قابل خواندن بین کمیتها تولید شود.
- XLSB: دادههای باینری خالص. سیستمهای کنترل نسخه آن را بهصورت یک بلوک باینری نامشخص در نظر میگیرند و هر گونه امکان مقایسه جزئی یا ادغام سطح خطی را از بین میبرند.
3. رندرینگ کلاینت وب
اگر معماری شما به رندر کردن مستقیم صفحاتگسترده در مرورگر از طریق WebAssembly یا جاوااسکریپت سمتکلاینت وابسته باشد، تجزیهکنندههای XLSX بهمراتب بالغتر و کمتر مستعد باگهای رندر حاشیهای نسبت به تجزیهکنندههای باینری سمتکلاینت هستند.
4. خطوط لولهی دریافت شخص ثالث
اگر شما در حال صادرات فایلها برای مشتریان سازمانی خارجی هستید، بسیاری از سیاستهای امنیتی سختگیرانه شرکتها فایلهای .xlsb را علامتگذاری میکنند. چون فایلهای BIFF12 میتوانند ماکروهای VBA را بهطور یکسان با فایلهای .xlsm ذخیره کنند (بدون نیاز به پسوند جداگانه)، برخی فیلترهای ایمیل و اسکنرهای فایروال بارگذاریهای .xlsb را بهعنوان تهدیدهای احتمالی حاوی ماکرو قرنطینه میکنند.
6. مقایسه خلاصه: کدام فرمت برتر است؟
| ویژگی | XLSX | XLSB | برنده |
|---|---|---|---|
| سرعت خواندن / تجزیه | متوسط تا ضعیف | بسیار سریع | XLSB |
| سرعت نوشتن / تولید | مصرفبالای پردازنده | سریع | XLSB |
| فشردهسازی فایل | خوب | عالی (~40-50% کوچکتر) | XLSB |
| تخصیص حافظه | بالا (فشار زیاد جمعآوری زباله) | پایین (خواندن مستقیم بایت) | XLSB |
| قابلیت تعامل ابزارها | سراسری | بالا، اما انتخابی | XLSX |
| اصطکاک اسکن امنیتی | حداقل | مثبتهای کاذب گاهبهگاه | XLSX |
| قابلیت ماکرو | خیر (.xlsm مورد نیاز است) | بله (ماکروها را بهصورت بومی پشتیبانی میکند) | بسته |
7. حکم نهایی توسعهدهنده
از XLSX زمانی استفاده کنید که:
- فایلها کوچک تا متوسط هستند (< ۵۰۰۰۰ ردیف).
- فایلهای شما باید توسط پلتفرمهای SaaS شخص ثالث یا برنامههای مصرفکننده (مثلاً Google Sheets) پردازش شوند.
- شما نمیتوانید محیط مشتری نهایی که فایل را میخواند کنترل کنید.
به XLSB تغییر دهید زمانی که:
- در حال ساخت خطوط لوله داخلی، کارهای دستهای، سیستمهای ETL یا وظایف کاری هستید که استخراجهای دادهای بزرگ (> ۱۰۰۰۰۰ ردیف) را مدیریت میکنند.
- سرورهای شما در هنگام سریالسازی یا دیسریالسازی جدولهای صفحهگسترده با خطاهای کمبود حافظه (OOM) مواجه میشوند.
- شما باید ردپای ذخیرهسازی S3/blob و زمان انتقال شبکه برای مدلهای مالی بزرگ یا صادرات دادههای مکرر را به حداقل برسانید.
تغییر به XLSB اغلب به سادگی تغییر یک رشته پیکربندی در سرویس خروجی شما است، اما افزایش توان پردازشی ۳ تا ۵ برابر را فراهم میکند که معمولاً نیاز به هفتهها بهینهسازی کد دارد.
سوالات متداول (FAQ)
**Q1: آیا یک فایل XLSB دقیقاً همان محدودیتهای ردیف و ستون را مانند یک فایل XLSX دارد؟ بله؛ هر دو XLSB و XLSX سقف شبکهای یکسانی برابر با ۱٬۰۴۸٬۵۷۶ ردیف در ۱۶٬۳۸۴ ستون برای هر کاربرگ دارند.
**Q2: آیا یک فایل XLSB میتواند بهصورت ایمن ماکروهای VBA را بدون تغییر پسوند فایل ذخیره کند؟
بله، برخلاف XLSX (که برای اجرای کد نیاز به ذخیره بهصورت XLSM دارد)، XLSB بهصورت بومی ذخیرهسازی باینری ماکروهای VBA را در همان قالب فایل .xlsb پشتیبانی میکند.
**Q3: چرا ذخیره یک فایل بهصورت XLSB اندازه آن را کاهش میدهد در حالی که هر دو قالب قبلاً بهصورت ZIP فشرده شدهاند؟ XLSB برچسبهای متنی پرحجم را حذف میکند و موقعیتهای سلول، رکوردها و مقادیر عددی خام را به جریانهای بایت باینری فشردهای رمزگذاری میکند که بهمراتب فشردهتر از رشتههای ساده XML هستند.
**Q4: آیا Google Sheets میتواند فایلهای XLSB را بهصورت مستقیم وارد و ویرایش کند؟
خیر؛ Google Sheets بهصورت بومی نمیتواند فایلهای .xlsb را مستقیماً باز یا تبدیل کند و برای وارد کردن باید آنها را به .xlsx یا CSV تبدیل کنید.
**Q5: آیا فایلهای XLSB نسبت به فایلهای XLSX مستعد خراب شدن دادهها هستند؟ در حالی که فایلهای XML گاهی میتوانند بهصورت دستی با یک ویرایشگر متن بررسی یا تعمیر شوند وقتی که جزئیاً خراب باشند، جریانهای باینری BIFF12 نیاز به جابجاییهای بایتی دقیق دارند و در صورت آسیب به بخشهای ساختاری، بازیابی دستی آنها دشوار است.