Viimeksi päivitetty: 30 syyskuuta 2026
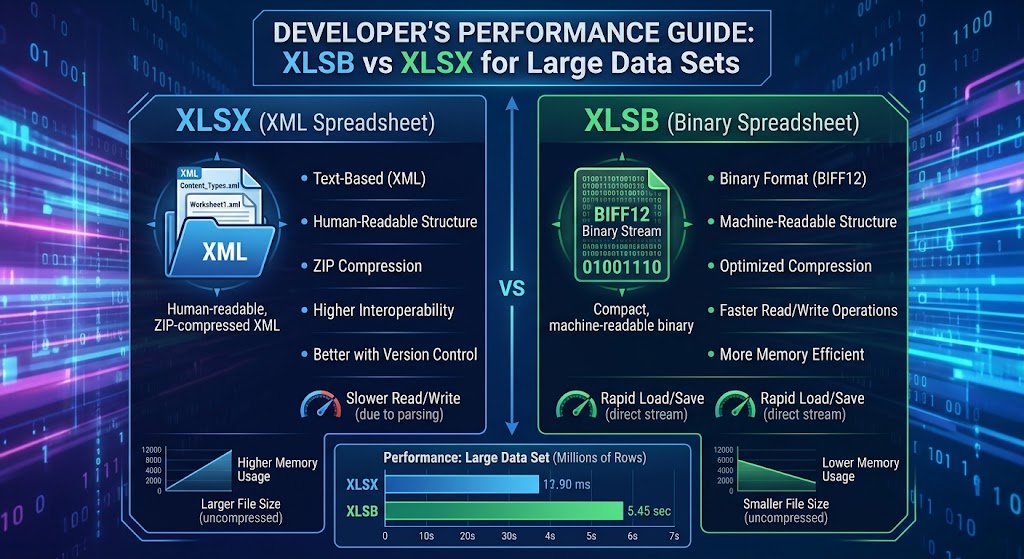
XLSB vs XLSX suurille tietojoukoille: Kehittäjän suorituskykyopas
Jos rakennat dataputkia, taustaraportointimoottoreita tai analytiikkatyökaluja, jotka ovat yhteydessä Microsoft Exceliin, olet todennäköisesti törmännyt “seinä”.
Käyttäjä lataa 450 000 rivin työkirjan. Palvelimesi käynnistää työntekijäketjuja, muistin käyttö nousee gigatavuihin, roskienkeruu pysäyttää suorituksen, ja aikasi loppuu. Tarkastelet sisältöä: se on tavallinen .xlsx‑tiedosto.
Ratkaistakseen tämän kehittäjät käyttävät usein päiviä lohkojen käsittelyn, suoratoistoparsereiden toteuttamiseen tai tiedostojen siirtämiseen taustatyöntekijöille. Silti yksi tehokkaimmista optimoinneista ei vaadi lainkaan arkkitehtuurimuutosta: tiedostopäätteen vaihtaminen .xlsx:stä .xlsb:ksi.
Tässä oppaassa sukellamme molempien formaattien sisäiseen toimintaan, tarkastelemme, miksi niiden sisäiset arkkitehtuurit tuottavat radikaalisti erilaisia suorituskykyominaisuuksia, vertailemme konkreettisia mittareita Pythonin ja .NET:n välillä, ja hahmotamme selkeät säännöt siitä, milloin ottaa binaarityökirjat käyttöön tuotannossa.
1. Moottorin alla: OpenXML vs. BIFF12
Ymmärtääksemme, miksi suorituskyky poikkeaa niin dramaattisesti suurissa tietoaineistoissa, meidän on tarkasteltava, miten kukin formaatti tallentaa tietueet levylle.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Sekä .xlsx- että .xlsb-tiedostot ovat pakattuja ZIP-säiliöitä, jotka noudattavat Open Packaging Conventions (OPC) -standardia. Jos nimeät jommankumman tiedoston .zip:ksi ja puret sen, näet tutun hakemistorakenteen: _rels, docProps ja xl/worksheets/.
Keskeinen ero löytyy xl/worksheets/-kansion sisällä:
- XLSX tallentaa taulukot tavallisena XML-tekstinä (
sheet1.xml). - XLSB tallentaa taulukot omistettuna binaarisena virta (
sheet1.bin), koodattuna Microsoftin BIFF12 (Binary Interchange File Format 12) -muodossa.
Kuinka XLSX koodaa tietoja (XML DOM -ylikuorma)
XLSX-työkirjassa jokainen solu on määritelty eksplisiittisillä XML-tageilla:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Kun luet tätä riviä, suoritusaikasi täytyy:
- Purkaa raakaa deflate-virta tekstiksi.
- Tokenisoida ja jäsentää merkkijonomerkit XML DOM- tai SAX-tapahtumavirtaan.
- Vahvista avaus- ja sulkemistunnisteet (
<c>,</c>,<v>,</v>). - Ratkaise merkkijonohaut erillisestä
sharedStrings.xml-taulukosta. - Jäsennä ASCII-teksti
"98234.55"IEEE 754 64-bittiseksi liukuluvuksi.
Jokainen solu aiheuttaa CPU-kuormitusta merkkijonojen jäsentämisestä, merkkijonojen varauksesta ja leksikaalisesta analyysistä. Kerro tämä 500 000 riviä ja 30 saraketta (15 miljoonaa solua) yli, ja CPU käyttää huomattavasti enemmän syklejä syntaksin jäsentämiseen kuin toimialueen arvojen käsittelyyn.
Kuinka XLSB koodaa tietoja (BIFF12-binäärivirta)
BIFF12 hylkää tekstin sarjoituksen kokonaan. Merkkijonomerkintöjen sijaan data järjestetään peräkkäiseksi sarjaksi muuttuvan pituuden binaaritietueita:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12:n liukuluku-solu ei käytä merkkijonoesityksiä kuten "98234.55". Se esitetään suoraan:
- 2 tavua tietueen ID:lle (esim.
BrtCellRktaiBrtCellReal) - 4 tavua sarake-/rivi-indekseille
- 8 tavua, jotka sisältävät raakan IEEE 754 -kaksoistarkkuus tavurakenteen
Kun jäsentimesi lukee XLSB-tiedoston, se ohittaa leksikaalisen jäsentämisen kokonaan. Se lukee tietueen otsikon, poimii 8 raakatavua puskurista, kopioi ne suoraan muistiin ja siirtää osoitinta eteenpäin. Tunnisteita ei tarvitse tarkistaa, merkkijono‑numero -muunnoksia ei tehdä, eikä numeeriselle datalle synny lainkaan UTF‑8‑purkuun kohdistuvaa kuormitusta.
2. Kvantitatiiviset vertailuarvot: levy, muisti ja läpäisykyky
Kuvitellaksesi todellisen vaikutuksen, tarkastele simuloitua tietojoukkoa, joka sisältää 750 000 riviä ja 25 saraketta (sekoitus aikaleimoja, liukulukuja, kokonaislukuja ja luokkitunnisteita).
Alla olevat testit arvioivat identtistä taulukkodataa, joka on tallennettu sekä XLSX- että XLSB-muodossa.
Testiympäristö
- CPU: AMD Ryzen 9 5900X (12 ydintä, 24 säiettä)
- RAM: 64 GB DDR4-3600
- Tallennus: PCIe 4.0 NVMe SSD
- Suoritusaika: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Keskeiset suorituskykymittarit
| Mittari | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Parannus |
|---|---|---|---|
| Tiedoston koko levyllä | 128.4 MB | 68.2 MB | ~47 % pienempi |
| Tallennus- / sarjoitusaika | 42.6 s | 14.1 s | 3.0x nopeampi |
| Lukuaika (Python DOM -jäsennin) | 38.2 s | 8.9 s | 4.3x nopeampi |
| Lukuaika (Rust/C-moottori) | 6.4 s | 1.9 s | 3.3x nopeampi |
| Huippu-heap-varaus lukemisen aikana | ~1.85 GB | ~510 MB | ~72% vähenys |
Miksi XLSB-tiedostot ovat pienempiä
Vaikka molemmat formaatit käyttävät standardia ZIP-pakkausta, binäärivirrat pakkaavat paljon tehokkaammin kuin turhauttava XML-teksti:
- Redundantti syntaksi poistetaan: XML sisältää toistuvia tageja (
<c r="AA1" s="1">) jokaisessa tietueessa. Vaikka ZIP-pakkaus vähentää toistuvia merkkijonoja, pakkaamaton datavirta on massiivinen. - Numeraalinen tiheys: XML:ssä luku
12345678.9012vaatii 14 tavua ASCII-tekstiä. BIFF12:ssä se tallennetaan 8-tavuisena double-muuttujana (tai pakataan 4-tavuiseksiRK-tietueeksi, jos se sopii tiettyihin tarkkuussääntöihin).
3. Muistin jalanjälki ja roskienkeruun paine
Verkkopalveluissa ja mikropalveluissa, jotka käsittelevät samanaikaisia pyyntöjä, prosessorin nopeus on vain puolet taistelusta; muistijalanjälki on se kohta, jossa sovellukset todellisuudessa epäonnistuvat.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Kun XML-jäsennin käsittelee 100 Mt:n XLSX-tiedoston, sen on luotava tuhansia ohimeneviä merkkijonotunnisteita, merkkijonojen viipalepuskuria ja sanakirjahakuja. Roskankeräyksen (GC) hallinnoimissa kielissä (Java, C#, Go, Node.js, Python) tämä aiheuttaa äärimmäistä pinon fragmentaatiota ja pakottaa suorituksen usein toistuviin roskankeräyskatkoihin.
Koska XLSB-jäsennys toimii suoraan kiinteälevyisinä tavujaksoina, jäsentimet voivat lukea dataa pinomuistiin varattuihin rakenteisiin tai uudelleenkäytettäviin tavupuskureihin. Tuloksena on dramaattisesti pienentynyt muistikäyttö ja nollaa ajoaikaisen allokaattorin häiriöitä.
4. Kehittäjän toteutusesimerkit
Katsotaan, miten hyödyntää XLSB:tä yleisissä kehittäjien työketjuissa.
Python: Siirtyminen OpenPyXL:stä Calamineen / PyXLSB:hen
Standardi pandas.read_excel('data.xlsx') käyttää oletuksena openpyxl-kirjastoa, joka rakentaa raskaan muistissa olevan puun.
Suuren XLSB-tiedoston käsittelemiseksi maksimaaliseen nopeuteen, käytä Rust-pohjaista calamine-moottoria (saatavilla python-calamine-paketin kautta ja integroituna nykyaikaiseen Pandasiin):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Jos iteroit massiivisia tietoaineistoja rivi kerrallaan lataamatta koko matriisia DataFrameen, pyxlsb tarjoaa kevyen suoratoisto-iteroinnin:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Korkean suorituskyvyn virran syöttö
.NET-ympäristössä kirjastot kuten ClosedXML tai EPPlus soveltuvat erinomaisesti tavalliseen tiedostojen luomiseen, mutta suurten tiedostojen käsittelemiseksi ilman muistin loppumista ExcelDataReader XLSB-tuesta on poikkeuksellisen nopea:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Arkkitehtoniset kompromissit: Milloin EI käytä XLSB
Huolimatta sen ylivoimaisista suorituskykyeduista, XLSB ei ole hopeakilkka. Sinun tulisi punnita useita operatiivisia kompromisseja ennen sen pakottamista koko pinossa:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosysteemi ja kirjastotuki
- XLSX: Universaali. Käytännössä jokainen kieli, kirjasto, SaaS-työkalu (Google Sheets, Airtable, Tableau) ja verkkoparseerija tukee OpenXML:ää natiivisti.
- XLSB: Vähemmän yleinen. Vaikka Excel, LibreOffice ja kehittyneet kehittäjäkirjastot (
ExcelDataReader,pyxlsb,calamine,Aspose) tukevat sitä, monet kevyet paketit tai puhtaat web-pohjaiset JavaScript-parsereita (kuten vanhemmatSheetJS-versiot) tarjoavat rajoitettua tai vain luku -tukea.
2. Git & versionhallinnan diffaus
- XLSX: Koska se sisältää teksti‑XML:n ZIP‑kontainerin sisällä, komentorivityökalut ja Git‑koukut voivat purkaa ja muotoilla XML:n luodakseen luettavia rakenteellisia diffejä commitien välillä.
- XLSB: Puhtaan binääridataa. Versionhallintajärjestelmät käsittelevät sitä tiukasti läpinäkymättömänä binääripaketina, poistaen kaikki mahdollisuudet tarkkoihin diffejöihin tai rivitasoisiin yhdistämisiin.
3. Web-asiakkaan renderöinti
Jos arkkitehtuurisi perustuu taulukoiden renderöintiin suoraan selaimessa WebAssemblyn tai asiakaspuolen JavaScriptin avulla, XLSX‑parserit ovat merkittävästi kypsämpiä ja vähemmän alttiita reunatapauksia aiheuttaville renderöintivirheille kuin asiakaspuolen binääriparsereita.
4. Kolmannen osapuolen syöttöputket
Jos viet tiedostoja ulkoisille yritysasiakkaille, monet tiukat yritysturvallisuuspolitiikat merkitsevät .xlsb-tiedostoja. Koska BIFF12-tiedostot voivat tallentaa VBA-makroja identtisesti kuin .xlsm-tiedostot (ilman erillistä tiedostopäätettä), jotkut sähköpostisuodattimet ja palomuuriskannerit karanteenivat .xlsb-lataukset mahdollisina makroja sisältävinä uhkina.
6. Yhteenvetava vertailu: Kumpi formaatti voittaa?
| Ominaisuus | XLSX | XLSB | Voittaja |
|---|---|---|---|
| Luku- / jäsentämisnopeus | Kohtalainen - heikko | Uskomattoman nopea | XLSB |
| Kirjoitus- / generointinopeus | Suoritinrasittava | Nopea | XLSB |
| Tiedostopakkaus | Hyvä | Erinomainen (~40-50% pienempi) | XLSB |
| Muistinvaraus | Korkea (Kova roskienkeruun paine) | Matala (Suora tavunlukeminen) | XLSB |
| Työkalujen yhteensopivuus | Universaali | Korkea, mutta valikoiva | XLSX |
| Turvallisuustarkastuksen kitka | Minimaalinen | Satunnaisia vääräpositiivisia | XLSX |
| Makron kyvykkyys | Ei (.xlsm vaaditaan) | Kyllä (tukee makroja natiivisti) | Sidonta |
7. Kehittäjän tuomio
Käytä XLSX kun:
- Tiedostot ovat pienestä keskisuureen kokoon (< 50 000 riviä).
- Tiedostosi on otettava käyttöön kolmannen osapuolen SaaS-alustoilla tai kuluttajasovelluksilla (esim. Google Sheets).
- Et voi hallita loppuasiakkaan ympäristöä, joka lukee tiedoston.
Vaihda XLSB kun:
- Rakennat sisäisiä putkistoja, eräajoja, ETL-järjestelmiä tai työntekijätehtäviä, jotka käsittelevät massiivisia dataotteja (> 100 000 riviä).
- Palvelimesi kohtaavat muistin loppumisen (OOM) virheitä taulukkolaskentatiedostojen sarjoittamisen tai desarjoittamisen aikana.
- Sinun täytyy minimoida S3-/blob-tallennustilan jalanjälki ja verkon siirtoaika suurille toistuville talousmalleille tai tietojen vientiä varten.
XLSB:ksi siirtyminen on usein yhtä yksinkertaista kuin konfiguraatio-merkkijonon muuttaminen vientipalvelussasi, mutta se tarjoaa 3‑5‑kerran läpimeno- parannuksia, jotka normaalisti vaativat viikkoja koodin optimointia.
Usein kysytyt kysymykset (FAQ)
**Q1: Tukeeko XLSB -tiedosto täsmälleen samat rivi- ja sarakerajat kuin XLSX -tiedosto? Kyllä; sekä XLSB että XLSX jakavat täsmälleen saman ruudukon enimmäiskoon, joka on 1 048 576 riviä ja 16 384 saraketta per taulukko.
**Q2: Voiko XLSB-tiedosto tallentaa VBA-makrot turvallisesti muuttamatta tiedostopäätettä?
Kyllä, toisin kuin XLSX (joka vaatii tallentamisen XLSM-muotoon koodin suorittamiseksi), XLSB tukee binääristä VBA-makrojen tallennusta natiivisti samassa .xlsb-tiedostomuodossa.
**Q3: Miksi tiedoston tallentaminen XLSB-muotoon pienentää sen koon, jos molemmat muodot ovat jo ZIP-pakattuja? XLSB poistaa laajamittaiset tekstimerkintätagit ja koodaa solujen sijainnit, tietueet ja raakat numeeriset arvot tiiviiksi binaarisiksi tavujonoiksi, jotka pakkaavat paljon tiiviimmin kuin tavalliset XML-merkkijonot.
**Q4: Voiko Google Sheets tuoda ja muokata XLSB-tiedostoja suoraan?
Ei; Google Sheets ei pysty natiivisti avaamaan tai muuntamaan .xlsb-tiedostoja suoraan, joten ne täytyy muuntaa .xlsx- tai CSV-muotoon ennen tuontia.
**Q5: Ovatko XLSB-tiedostot alttiimpia tietojen korruptiolle kuin XLSX-tiedostot? Vaikka XML-tiedostoja voidaan joskus tarkastella tai korjata manuaalisesti tekstieditorilla osittaisen korruption yhteydessä, binaariset BIFF12-virrat vaativat tarkat tavuesiirrot, eikä niitä ole helppo palauttaa manuaalisesti, jos rakenteelliset sektorit ovat vaurioituneet.