Dernière mise à jour : 20 août 2026
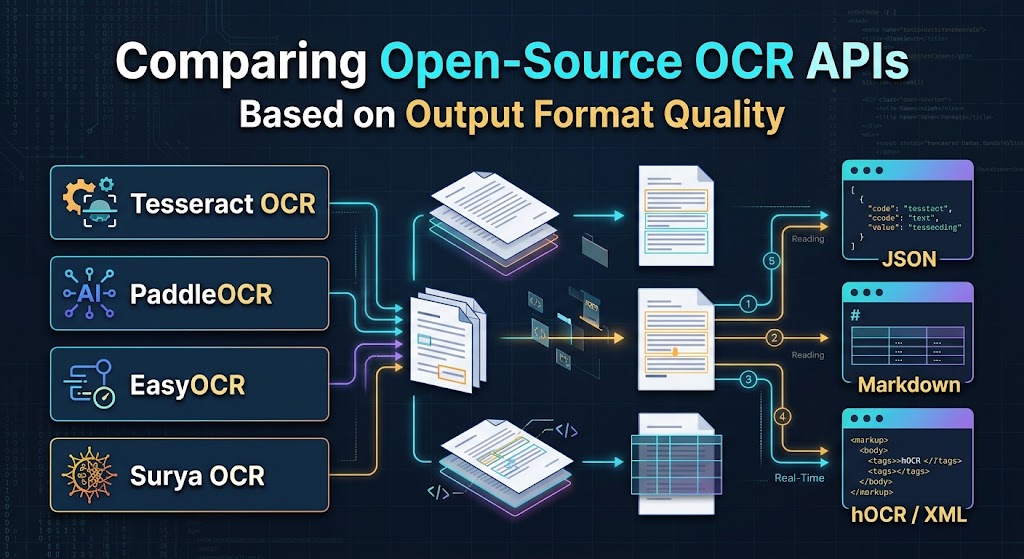
Comparer les API OCR open source selon la qualité des formats de sortie
Lorsque les ingénieurs évaluent les moteurs de reconnaissance optique de caractères (OCR), le taux d’erreur de caractères (CER) et le taux d’erreur de mots (WER) dominent généralement les benchmarks. Bien que la précision de la reconnaissance soit essentielle, elle ne résout qu’une moitié du problème en production.
Si vous analysez des PDF complexes à plusieurs colonnes, extrayez les lignes d’articles de reçus ou intégrez des livres blancs dans un pipeline d’intégration LLM, les exportations de texte brut génèrent une surcharge d’ingénierie massive. Une chaîne de caractères dépourvue de conscience de la mise en page, d’ordre de lecture logique ou de données de coordonnées oblige votre équipe à écrire des analyseurs heuristiques fragiles.
Le véritable différenciateur pour les flux de travail de documents modernes est la qualité du format de sortie : la façon dont un moteur fournit de manière cohérente et propre les coordonnées, l’ordre de lecture, la hiérarchie structurelle et les données tabulaires.
Voici une comparaison axée sur l’ingénierie de quatre moteurs OCR open source de premier plan —Tesseract, PaddleOCR, EasyOCR et Surya OCR—évaluant la façon dont leurs sorties se comportent dans les pipelines automatisés.
Les formats de sortie courants : ce dont les ingénieurs ont réellement besoin
Chaque API OCR empaquette le texte détecté différemment. Comprendre ces formats aide à déterminer le niveau de post‑traitement requis par votre pipeline :
- Texte brut (
.txt): La représentation la plus simple. Elle supprime toutes les métadonnées de position et compresse les mises en page multi‑colonnes en lectures horizontales, ce qui peut désorganiser les paragraphes. - Normes d’archivage (
hOCR,ALTO XML): Formats basés sur XML/HTML standard dans l’archivage des bibliothèques. Ils intègrent les coordonnées, les estimations de police et les scores de confiance dans les nœuds DOM. Extrêmement robustes pour la reconstruction de documents, mais lourds pour les micro‑services. - JSON structuré : Le choix par défaut pour les back‑ends web modernes. Il fournit des tableaux de coordonnées (boîtes englobantes ou polygones), des scores de confiance et des structures hiérarchiques bloc/ligne/mot.
- Markdown (
.md) / Tables HTML : Le standard moderne pour la génération augmentée par récupération (RAG). Il préserve les sections sémantiques (en‑têtes, listes, texte en gras) et les matrices tabulaires sans nécessiter de reconstruction spatiale en aval.
1. Tesseract OCR
Maintenu par Google, Tesseract reste le cheval de bataille fondamental de l’OCR open‑source. Son architecture repose largement sur des algorithmes traditionnels de segmentation de page, complétés par un moteur de caractères basé sur LSTM.
Formats de sortie natifs
- Sorties principales : Texte brut, hOCR (HTML), ALTO XML, TSV (Valeurs séparées par des tabulations), et PDF/A consultable.
- Conscience de la mise en page : Heuristiques basées sur des règles via les modes de segmentation de page (PSM).
Analyse des formats de sortie
- Où il excelle : Les exportations
TSVethOCRde Tesseract sont standardisées et prévisibles. Une exportation TSV unique renvoie des colonnes structurées pourlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightetconf. Si vous convertissez des archives papier en PDF consultables ou avez besoin d’une conformité stricte aux normes institutionnelles, Tesseract gère cela nativement sans code d’assemblage personnalisé. - Où il fa défaut : Tesseract n’a pas d’API JSON native. Consommer sa sortie en Python ou Node.js nécessite l’analyse de fichiers XML/TSV ou l’utilisation d’enveloppes comme
pytesseract. Son moteur de mise en page a également du mal avec les flux columnaires non standard, mélangeant fréquemment le texte des colonnes adjacentes à moins que des découpes de délimitation manuelles soient fournies.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Appuyé par le framework PaddlePaddle de Baidu, PaddleOCR a connu une adoption généralisée grâce à ses modèles légers, sa couverture multilingue étendue et son ensemble d’outils d’analyse de documents dédié (PP-Structure).
Formats de sortie natifs
- Sorties principales : listes/dictionnaires Python, JSON brut, superpositions de visualisation et HTML structuré via PP-Structure.
- Conscience de la mise en page : Élevée (en utilisant des modèles d’apprentissage profond pour l’analyse de la mise en page, la classification d’orientation et la récupération de tableaux).
Analyse des formats de sortie
- Où il excelle : Standard PaddleOCR renvoie des coordonnées de polygone à 4 points (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) ainsi que des chaînes de texte et des scores de confiance. Cela gère élégamment le texte incliné ou courbé. Cependant, sa véritable force réside dans la suite PP-Structure, qui détecte les régions de mise en page (titre, texte, tableau, figure) et analyse les tableaux directement en chaînes HTML valides (<table>...</table>). Cela élimine la nécessité de calculer manuellement les étendues de cellules à partir des boîtes englobantes. - Où il échoue : L’API de base renvoie des tableaux imbriqués qui manquent de clés de propriétés standard entre les différentes versions. Pour les applications structurées, les développeurs écrivent généralement un adaptateur intermédiaire afin de standardiser les noms de champs (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Construit sur PyTorch par JaidenAI, EasyOCR est conçu pour une adoption rapide par les développeurs. Il intègre CRAFT (Character Region Awareness for Text Detection) avec des réseaux de reconnaissance en apprentissage profond dans une API minimale.
Formats de sortie natifs
- Sorties principales : Listes Python contenant des tuples de coordonnées, de chaînes reconnues et de valeurs de confiance.
- Conscience de la mise en page : Faible à modérée (détection de lignes de texte uniquement ; aucune analyse structurelle au niveau du document).
Analyse des formats de sortie
- Où il excelle : La simplicité de l’objet retourné est inégalée :
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Mapper cette sortie à une réponse REST standard ou la sérialiser directement en GeoJSON/schémas personnalisés ne prend que quelques lignes de code. Elle fonctionne de manière fiable sur le texte de scènes naturelles, les plaques d’immatriculation et les découpes de documents isolés.
- Où il échoue : EasyOCR ne réalise pas d’analyse holistique de la mise en page du document. Il n’identifie pas les tableaux, les hiérarchies de titres, ni les ordres de lecture à travers des colonnes complexes. Utiliser EasyOCR sur un article académique à deux colonnes produit souvent des fragments de texte entrelacés, sauf s’il est associé à un modèle de détection de mise en page en amont (tel que YOLO ou LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya est un cadre OCR d’apprentissage profond moderne conçu spécifiquement pour la compréhension de documents complexes et les pipelines d’ingestion LLM.
Formats de sortie natifs
- Sorties principales : Structures JSON modélisées par Pydantic, index d’ordre de lecture logique, régions de délimitation de mise en page et polygones de détection de lignes.
- Conscience de la mise en page : Exceptionnellement élevée (analyse de mise en page basée sur l’apprentissage profond et tri de l’ordre de lecture).
Analyse des formats de sortie
- Où il excelle : Surya répond directement aux défis de l’ingénierie IA moderne. Au lieu de supposer que les documents sont lus de haut en bas, de gauche à droite, Surya déploie un modèle dédié pour prédire l’ordre de lecture. Il regroupe les lignes en blocs sémantiques logiques, gère naturellement les étendues multi-colonnes, et produit des structures typées via Pydantic. Cela rend l’ingestion en aval dans les bases de données vectorielles et les convertisseurs Markdown directe et fiable.
- Où il faiblit : En tant que cadre plus récent et plus lourd basé sur PyTorch, Surya nécessite un calcul GPU dédié pour égaler le débit des moteurs C++ optimisés comme Tesseract ou les modèles Paddle quantifiés. Il ne cible pas les normes d’archivage héritées comme hOCR ou ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Matrice de comparaison côte à côte
| Capacité / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Natif hOCR / ALTO XML | Support natif | Tierce partie uniquement | Aucun | Aucun |
| Géométrie de la boîte englobante | Aligné sur les axes (x, y, w, h) | Polygone à 4 points | Polygone à 4 points | Polygone + blocs de mise en page |
| Analyse de tableau | TSV de coordonnées uniquement | Chaînes de tableau HTML | Aucun | Grilles de coordonnées de cellules |
| Détection de l’ordre de lecture | Basé sur des règles (s’arrête sur plusieurs colonnes) | Analyse de mise en page ML | Regroupement de lignes basique | Modèle dédié d’ordre de lecture |
| Schémas JSON directs | Nécessite une conversion | Python Dict / JSON | Python List / JSON | Modèles Pydantic typés |
| Cible en aval idéale | PDF d’archivage, DMS hérité | Données de formulaires/reçus, ERP | Scripts rapides, texte de scène | Ingestion LLM, architectures RAG |
Recommandations de pipeline : lequel choisir ?
- Choisissez Tesseract si vos exigences de conformité exigent des livrables standardisés
hOCR,ALTO XMLou PDF/A consultables pour les dossiers gouvernementaux ou d’archives. - Choisissez PaddleOCR si vous traitez des documents financiers opérationnels (factures, reçus, formulaires fiscaux) contenant des tableaux complexes et sans bordure qui doivent être convertis en HTML ou en feuilles de calcul.
- Choisissez EasyOCR si vous avez besoin d’une bibliothèque légère et pythonique pour détecter et extraire du texte à partir d’images naturelles, de panneaux de signalisation ou d’éléments d’interface utilisateur recadrés sans tracas de configuration.
- Choisissez Surya OCR si vous alimentez des rapports d’entreprise non structurés, des articles de recherche et des guides techniques dans un LLM ou un moteur de recherche vectoriel où l’ordre de lecture logique et les limites structurelles propres sont primordiaux.
Foire aux questions (FAQ)
1. Quel format de sortie OCR open source est le plus facile à intégrer aux grands modèles de langage ?
Le JSON sensible à l’ordre de lecture de Surya OCR et les tables HTML de PP-Structure de PaddleOCR offrent les représentations les plus propres pour les contextes d’invite LLM et l’indexation RAG.
2. Tesseract peut-il produire des réponses JSON nativement sans outils tiers ?
Non, Tesseract génère du texte, TSV, PDF et hOCR/ALTO XML nativement ; produire du JSON nécessite de convertir sa sortie TSV ou hOCR à l’aide d’un analyseur intermédiaire.
3. En quoi les coordonnées d’un polygone à 4 points diffèrent-elles des boîtes englobantes alignées sur les axes ?
Les boîtes alignées sur les axes utilisent [x, y, width, height] en supposant du texte plat, tandis que les polygones à 4 points fournissent quatre paires de coordonnées pour entourer avec précision les lignes de texte tournées, inclinées ou courbées.
4. Quel moteur génère les structures de tableau directement en code plutôt que des coordonnées lâches ?
Le module PP-Structure de PaddleOCR reconstruit les limites de tableau détectées en balises HTML complètes (<table>, <tr>, <td>), évitant les calculs spatiaux personnalisés.
5. Pourquoi la sortie standard d’EasyOCR a-t-elle du mal avec les articles scientifiques à plusieurs colonnes ?
EasyOCR identifie les lignes de texte en fonction de la proximité locale plutôt que de la hiérarchie de mise en page globale, ce qui fait que le texte des colonnes adjacentes s’entremêle à moins d’être limité par un moteur de mise en page externe.
Voir aussi
- Formats de sortie OCR comparés : TXT, PDF, PDF/A, XML, JSON
- Comprendre les formats de fichiers OCR - HOCR vs ALTO vs PDF/A expliqué
- Quelle est la différence entre PDF et FDF ?
- PDF vs Word : lequel devez‑vous utiliser et quand ?
- Comment choisir le bon format de fichier pour la reconnaissance de texte manuscrit (HTR)