Dernière mise à jour : 30 sept. 2026
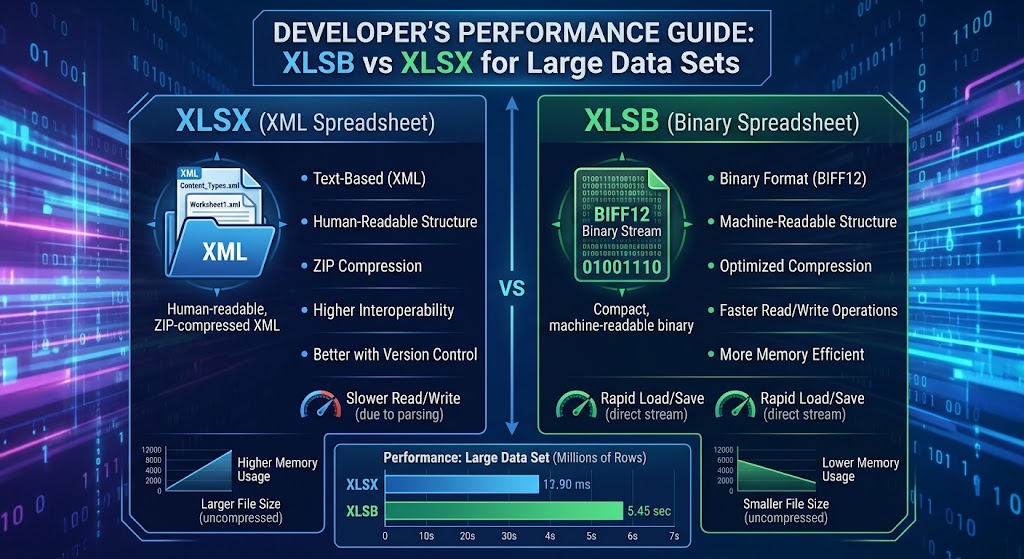
XLSB vs XLSX pour les grands ensembles de données : Guide de performance pour les développeurs
Si vous créez des pipelines de données, des moteurs de reporting back‑end ou des outils d’analyse qui s’interfacent avec Microsoft Excel, vous avez probablement heurté “le mur”.
Un utilisateur téléverse un classeur de 450 000 lignes. Votre serveur lance des threads de travail, la consommation de mémoire grimpe à plusieurs gigaoctets, le ramasse‑miettes fige le runtime, et votre exécution dépasse le délai imparti. Vous inspectez la charge utile : il s’agit d’un fichier .xlsx standard.
Pour résoudre ce problème, les développeurs passent souvent des jours à implémenter du découpage, des analyseurs en flux ou à déléguer les fichiers à des workers en arrière‑plan. Pourtant, l’une des optimisations les plus efficaces ne nécessite aucune refonte architecturale : changer l’extension du fichier de .xlsx en .xlsb.
Dans ce guide, nous plongeons sous le capot des deux formats, examinons pourquoi leurs architectures internes produisent des caractéristiques de performance radicalement différentes, comparons des benchmarks concrets sous Python et .NET, et définissons des règles claires pour savoir quand déployer des classeurs binaires en production.
1. Sous le capot : OpenXML vs. BIFF12
Pour comprendre pourquoi les performances divergent autant sur de grands ensembles de données, nous devons examiner comment chaque format stocke les enregistrements sur le disque.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Les fichiers .xlsx et .xlsb sont des conteneurs ZIP compressés conformes aux Open Packaging Conventions (OPC). Si vous renommez l’un de ces fichiers en .zip et l’extrayez, vous verrez une structure de répertoires familière : _rels, docProps et xl/worksheets/.
La différence cruciale se trouve dans le dossier xl/worksheets/ :
- XLSX stocke les feuilles sous forme de texte XML brut (
sheet1.xml). - XLSB stocke les feuilles sous forme de flux binaires propriétaires (
sheet1.bin), encodés avec le BIFF12 de Microsoft (Binary Interchange File Format 12).
Comment XLSX encode les données (surcharge du DOM XML)
Dans une feuille de calcul XLSX, chaque cellule est déclarée avec des balises XML explicites :
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Lors de la lecture de cette ligne, votre environnement d’exécution doit :
- Décompresser le flux deflate brut en texte.
- Tokeniser et analyser les caractères de chaîne en un DOM XML ou un flux d’événements SAX.
- Valider les balises d’ouverture et de fermeture (
<c>,</c>,<v>,</v>). - Résoudre les recherches de chaînes à partir d’une table
sharedStrings.xmlséparée. - Analyser le texte ASCII
\"98234.55\"en un nombre à virgule flottante IEEE 754 de 64 bits.
Chaque cellule entraîne une surcharge CPU pour l’analyse de chaînes, l’allocation de chaînes et l’analyse lexicale. Multipliez cela sur 500,000 lignes et 30 colonnes (15 millions de cellules), et le CPU consomme beaucoup plus de cycles à analyser la syntaxe qu’à traiter les valeurs du domaine.
Comment XLSB encode les données (flux binaire BIFF12)
BIFF12 supprime complètement la sérialisation du texte. Au lieu d’un balisage de chaînes, les données sont organisées comme une séquence séquentielle d’enregistrements binaires de longueur variable :
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Une cellule à virgule flottante dans BIFF12 n’utilise pas de représentations de chaîne comme \"98234.55\". Elle est représentée directement :
- 2 octets pour l’ID d’enregistrement (p. ex.,
BrtCellRkouBrtCellReal) - 4 octets pour les indices de colonne/ligne
- 8 octets contenant la structure brute d’octets en double précision IEEE 754
Lorsque votre analyseur lit un fichier XLSB, il contourne complètement l’analyse lexicale. Il lit l’en-tête d’enregistrement, récupère les 8 octets bruts du tampon, les copie directement en mémoire et avance le pointeur. Il n’y a aucun tag à valider, aucune conversion de type chaîne‑vers‑nombre, et aucun coût de décodage UTF‑8 pour les données numériques.
2. Benchmarks quantitatifs : disque, mémoire et débit
Pour illustrer l’impact réel, considérez un jeu de données simulé contenant 750 000 lignes et 25 colonnes (un mélange d’horodatages, de nombres à virgule flottante, d’entiers et de codes de catégorie).
Les tests ci‑dessous évaluent des données tabulaires identiques enregistrées à la fois au format XLSX et XLSB.
Environnement de test
- CPU: AMD Ryzen 9 5900X (12 cœurs, 24 threads)
- RAM: 64 Go DDR4-3600
- Stockage: PCIe 4.0 NVMe SSD
- Temps d’exécution: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Métriques de performance clés
| Métrique | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Amélioration |
|---|---|---|---|
| Taille du fichier sur le disque | 128.4 MB | 68.2 MB | ~47% plus petit |
| Enregistrement / Temps de sérialisation | 42.6 s | 14.1 s | 3.0x plus rapide |
| Temps de lecture (analyseur DOM Python) | 38.2 s | 8.9 s | 4.3x plus rapide |
| Temps de lecture (Moteur Rust/C) | 6.4 s | 1.9 s | 3,3 x plus rapide |
| Allocation maximale du tas pendant la lecture | ~1.85 GB | ~510 MB | ~72 % de réduction |
Pourquoi les fichiers XLSB sont plus petits
Alors que les deux formats utilisent la compression ZIP standard, les flux binaires compressent beaucoup plus efficacement que le texte XML gonflé :
- La syntaxe redondante est éliminée : XML contient des balises répétitives (
<c r="AA1" s="1">) sur chaque enregistrement. Bien que la compression ZIP atténue les chaînes répétées, le flux de données non compressé est massif. - Densité numérique : En XML, le nombre
12345678.9012nécessite 14 octets de texte ASCII. Dans BIFF12, il est stocké comme un double de 8 octets (ou empaqueté dans un enregistrementRKde 4 octets s’il respecte des règles de précision spécifiques).
3. Empreinte mémoire et pression du ramasse-miettes
Pour les services web et les microservices gérant des requêtes concurrentes, la vitesse du CPU n’est que la moitié du combat ; l’empreinte mémoire est l’endroit où les applications échouent réellement.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Lorsqu’un analyseur XML traite un fichier XLSX de 100 Mo, il doit créer des milliers de jetons de chaîne éphémères, des tampons de tranches de chaîne et des recherches dans le dictionnaire. Dans les langages à collecte de déchets (Java, C#, Go, Node.js, Python), cela crée une fragmentation extrême du tas et pousse le runtime à des pauses fréquentes de collecte des ordures (GC).
Parce que l’analyse XLSB fonctionne directement sur des tranches d’octets à largeur fixe, les analyseurs peuvent lire les données dans des structures allouées sur la pile ou des tampons d’octets réutilisables. Le résultat est une empreinte mémoire considérablement réduite et aucune surcharge de l’allocateur d’exécution.
4. Exemples d’implémentation pour les développeurs
Examinons comment exploiter XLSB dans les chaînes d’outils courantes des développeurs.
Python : migration d’OpenPyXL vers Calamine / PyXLSB
Par défaut, pandas.read_excel('data.xlsx') utilise openpyxl, qui construit un arbre en mémoire lourd.
Pour traiter de gros fichiers XLSB à la vitesse maximale, utilisez le moteur calamine propulsé par Rust (disponible via python-calamine et intégré dans les versions modernes de Pandas) :
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Si vous parcourez d’énormes ensembles de données ligne par ligne sans charger la matrice complète dans un DataFrame, pyxlsb fournit un itérateur de diffusion léger :
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET : ingestion de flux haute performance
Dans .NET, des bibliothèques comme ClosedXML ou EPPlus sont excellentes pour la génération standard, mais pour ingérer de gros fichiers sans épuisement de mémoire, ExcelDataReader avec prise en charge XLSB est exceptionnellement rapide :
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Compromis architecturaux : quand NE PAS utiliser XLSB
En dépit de ses avantages de performance écrasants, XLSB n’est pas une solution miracle. Vous devez peser plusieurs compromis opérationnels avant de l’imposer à l’ensemble de votre pile :
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Écosystème et prise en charge des bibliothèques
- XLSX: Universel. Pratiquement chaque langage, bibliothèque, outil SaaS (Google Sheets, Airtable, Tableau) et analyseur web prennent en charge OpenXML nativement.
- XLSB: Moins répandu. Bien qu’Excel, LibreOffice et des bibliothèques de développeurs matures (
ExcelDataReader,pyxlsb,calamine,Aspose) le prennent en charge, de nombreux paquets légers ou analyseurs JavaScript purement web (comme les versions plus anciennes deSheetJS) offrent un support limité ou en lecture seule.
2. Différences Git et contrôle de version
- XLSX: Parce qu’il contient du texte XML à l’intérieur d’un conteneur ZIP, les utilitaires en ligne de commande et les hooks Git peuvent décompresser et formater le XML pour générer des diff structurels lisibles entre les commits.
- XLSB: Données purement binaires. Les systèmes de contrôle de version le traitent strictement comme un blob binaire opaque, éliminant toute possibilité de diff granulaire ou de fusion au niveau des lignes.
3. Rendu côté client Web
Si votre architecture repose sur le rendu de feuilles de calcul directement dans le navigateur via WebAssembly ou JavaScript côté client, les analyseurs XLSX sont nettement plus matures et moins sujets aux bugs de rendu dans les cas limites que les analyseurs binaires côté client.
4. Pipelines d’ingestion tiers
Si vous exportez des fichiers pour des clients d’entreprise externes, de nombreuses politiques de sécurité d’entreprise strictes signalent les fichiers .xlsb. Comme les fichiers BIFF12 peuvent stocker les macros VBA de la même manière que les fichiers .xlsm (sans nécessiter d’extension distincte), certains filtres de messagerie et scanners de pare-feu mettent en quarantaine les téléchargements .xlsb en tant que menaces potentielles contenant des macros.
6. Comparaison récapitulative : quel format l’emporte ?
| Fonctionnalité | XLSX | XLSB | Gagnant |
|---|---|---|---|
| Vitesse de lecture / d’analyse | Modéré à médiocre | Ultra-rapide | XLSB |
| Vitesse d’écriture / de génération | Intensif en CPU | Rapide | XLSB |
| Compression de fichier | Bon | Excellent (~40-50% plus petit) | XLSB |
| Allocation de mémoire | Élevé (pression GC importante) | Faible (lecture directe d’octets) | XLSB |
| Interopérabilité des outils | Universel | Élevée, mais sélective | XLSX |
| Friction de l’analyse de sécurité | Minime | Faux positifs occasionnels | XLSX |
| Capacité de macro | Non (.xlsm requis) | Oui (Prend en charge les macros nativement) | Égalité |
7. Le verdict du développeur
Utilisez XLSX lorsque :
- Les fichiers sont de petite à moyenne taille (< 50 000 lignes).
- Vos fichiers doivent être ingérés par des plateformes SaaS tierces ou des applications grand public (p. ex., Google Sheets).
- Vous ne pouvez pas contrôler l’environnement du client final qui lit le fichier.
Passez à XLSB lorsque :
- Vous créez des pipelines internes, des jobs batch, des systèmes ETL ou des tâches de travail qui traitent d’énormes extractions de données (> 100 000 lignes).
- Vos serveurs rencontrent des erreurs de dépassement de mémoire (OOM) lors de la sérialisation ou de la désérialisation de feuilles de calcul.
- Vous devez réduire l’empreinte de stockage S3/blob et le temps de transit réseau pour les grands modèles financiers récurrents ou les exportations de données.
Passer à XLSB est souvent aussi simple que de modifier une chaîne de configuration dans votre service d’exportation, mais cela offre des gains de débit de 3 à 5 fois, qui nécessitent normalement des semaines d’optimisation du code.
Foire aux questions (FAQ)
**Q1: Un fichier XLSB prend‑il en charge exactement les mêmes limites de lignes et de colonnes qu’un fichier XLSX ? Oui ; les deux formats XLSB et XLSX partagent exactement le même plafond de grille de 1 048 576 lignes par 16 384 colonnes par feuille de calcul.
**Q2: Un fichier XLSB peut‑il stocker en toute sécurité des macros VBA sans changer son extension de fichier ?
Oui, contrairement à XLSX (qui nécessite d’être enregistré en XLSM pour exécuter du code), XLSB prend en charge le stockage binaire des macros VBA nativement dans le même format de fichier .xlsb.
**Q3: Pourquoi l’enregistrement d’un fichier au format XLSB réduit‑il sa taille alors que les deux formats sont déjà compressés en ZIP ? XLSB élimine les balises de balisage texte verbeuses et encode les positions des cellules, les enregistrements et les valeurs numériques brutes dans des flux d’octets binaires compacts qui se compressent beaucoup plus densément que les chaînes XML simples.
**Q4: Google Sheets peut-il importer et modifier les fichiers XLSB directement ?
Non ; Google Sheets ne peut pas ouvrir ou convertir nativement les fichiers .xlsb directement, vous obligeant à les convertir en .xlsx ou CSV avant l’importation.
**Q5: Les fichiers XLSB sont-ils plus susceptibles de subir une corruption de données que les fichiers XLSX ? Bien que les fichiers XML puissent parfois être inspectés ou réparés manuellement avec un éditeur de texte lorsqu’ils sont partiellement corrompus, les flux binaires BIFF12 nécessitent des décalages d’octets stricts et sont difficiles à récupérer manuellement si les secteurs structurels sont endommagés.