עודכן לאחרונה: 20 באוג, 2026
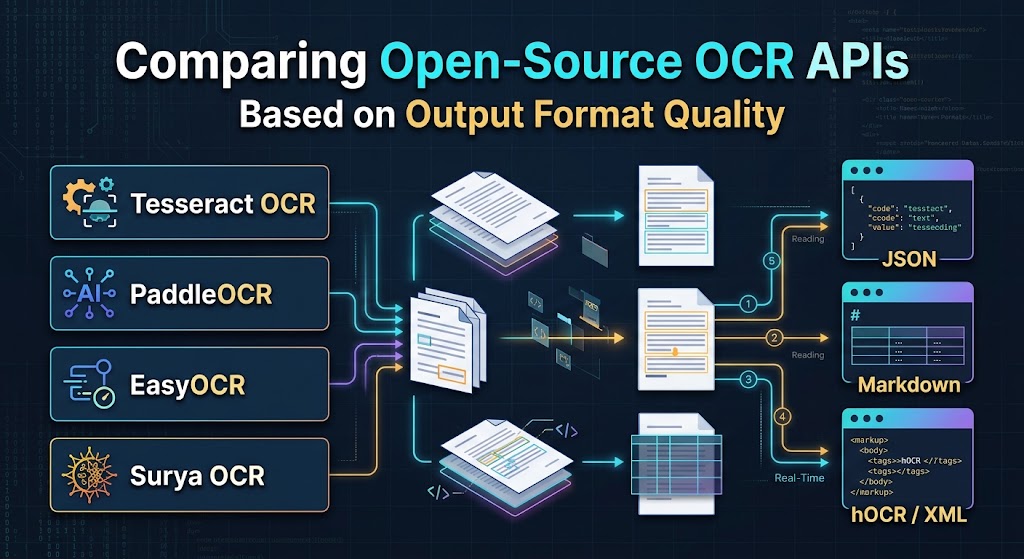
השוואת API-ים של OCR בקוד פתוח על בסיס איכות פורמט הפלט
כאשר מהנדסים מעריכים מנועי זיהוי תווים אופטי (OCR), שיעור שגיאת תווים (CER) ושיעור שגיאת מילים (WER) בדרך כלל שולטות במדדים. בעוד דיוק הזיהוי הוא חיוני, הוא פותר רק חצי מהבעיה בייצור.
אם אתה מפענח קבצי PDF מורכבים מרובי עמודות, מחלץ פריטים משורות קבלה, או משלב מסמכי whitepapers בצינור הטמעת LLM, יצוא טקסט גולמי יוצר עומס הנדסי עצום. מחרוזת של תווים ללא מודעות לפריסה, סדר קריאה לוגי, או נתוני קואורדינטות מכריחה את הצוות שלך לכתוב מפענחים היוריסטיים שבירים.
The true differentiator for modern document workflows is output format quality: how consistently and cleanly an engine delivers coordinates, reading order, structural hierarchy, and tabular data.
Below is an engineering-focused comparison of four leading open-source OCR engines—Tesseract, PaddleOCR, EasyOCR, and Surya OCR—evaluating how their outputs behave inside automated pipelines.
פורמטים נפוצים של פלט: מה שהמהנדסים באמת צריכים
Every OCR API packages detected text differently. Understanding these formats helps determine how much post-processing your pipeline requires:
- Plain Text (
.txt): הייצוג הפשוט ביותר. הוא מסיר את כל המטא-נתונים המיקומיים ומכווץ פריסות מרובות עמודות לקריאה אופקית, מה שעלול לערבל פסקאות. - Archival Standards (
hOCR,ALTO XML): פורמטים מבוססי XML/HTML שהם תקן בארכיון ספריות. הם משבצים קואורדינטות, הערכות גופנים ודירוגי אמינות בתוך צמתים של DOM. עמידים מאוד לשחזור מסמכים, אך כבדים למיקרו-שירותים. - Structured JSON: הבחירה המוגדרת כברירת מחדל עבור גיבויים מודרניים של רשת. מספק מערכי קואורדינטות (תיבות גבול או פוליגונים), דירוגי אמינות, ומבני בלוק/שורה/מילה היררכיים.
- Markdown (
.md) / HTML Tables: הסטנדרט המודרני ל- Retrieval-Augmented Generation (RAG). משמר חלקים סמנטיים (כותרות, רשימות, טקסט מודגש) ומטריצות טבלאיות ללא צורך בשחזור מרחבי בשלב הבא.
1. Tesseract OCR
Maintained by Google, Tesseract remains the foundational workhorse of open-source OCR. Its architecture leans heavily on traditional page segmentation algorithms supplemented by an LSTM-based character engine.
פורמטים של פלט מקורי
- תוצרים ראשיים: טקסט פשוט, hOCR (HTML), ALTO XML, TSV (ערכים מופרדים בטאבים), ו‑PDF/A שניתן לחיפוש.
- מודעות לפריסה: אלגוריתמים מבוססי כללים דרך מצבי חלוקת דפים (PSM).
ניתוח פורמט פלט
- היכן הוא מצטיין: הייצוא של Tesseract בפורמטים
TSVו‑hOCRהוא סטנדרטי וניתן לחיזוי. ייצוא TSV יחיד מחזיר עמודות מובנות עבורlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,height, ו‑conf. אם אתה ממיר ארכיוני נייר ל‑PDFים שניתנים לחיפוש או שאתה זקוק לעמידה קפדנית בתקנים מוסדיים, Tesseract מטפל בכך באופן מקורי ללא קוד חיבור מותאם. - היכן הוא נכשל: ל‑Tesseract אין API JSON מקורי. שימוש בפלט שלו ב‑Python או Node.js דורש ניתוח קבצי XML/TSV או שימוש במעטפות כמו
pytesseract. מנוע הפריסה שלו גם מתקשה בזרימת עמודות לא סטנדרטית, ולעיתים מערבב טקסט מעמודות סמוכות אלא אם מסופקות חיתוכי גבול ידניים.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Backed by Baidu’s PaddlePaddle framework, PaddleOCR has gained widespread adoption due to its lightweight models, extensive multi-language coverage, and dedicated document analysis toolkit (PP-Structure).
פורמטים של פלט מקורי
- תוצרים ראשיים: רשימות/מילונים של פייתון, JSON גולמי, שכבות ויזואליות, ו-HTML מובנה דרך PP-Structure.
- מודעות לפריסה: גבוהה (באמצעות מודלים של למידת עומק לניתוח פריסה, סיווג כיוון, ושחזור טבלאות).
ניתוח פורמט פלט
- היכן הוא מצטיין: PaddleOCR הסטנדרטי מחזיר קואורדינטות של פוליגון בעל 4 נקודות (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) יחד עם מחרוזות טקסט וציון ביטחון. זה מתמודד בצורה חלקה עם טקסט משופע או מעוקל. עם זאת, החוזק האמיתי שלו נמצא בחבילה PP-Structure, אשר מזהה אזורי פריסה (כותרת, טקסט, טבלה, איור) ומפענחת טבלאות ישירות למחרוזות HTML תקינות (<table>...</table>). זה מבטל את הצורך לחשב ידנית את מרווחי התא מתוך תיבות הגבול. - היכן הוא נכשל: ה-API הבסיסי מחזיר מערכים מקוננים שאין בהם מפתחות נכסים סטנדרטיים בין גרסאות שונות. עבור יישומים מובנים, מפתחים בדרך כלל כותבים מתאם ביניים כדי לאחד שמות שדות (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Built on PyTorch by JaidedAI, EasyOCR is built for rapid developer adoption. It packages CRAFT (Character Region Awareness for Text Detection) with deep learning recognition networks into a minimal API.
פורמטים של פלט מקורי
- תוצרים ראשיים: רשימות פייתון המכילות טופלים של קואורדינטות, מחרוזות מזוהות, וערכי אמון.
- מודעות לפריסה: נמוכה עד בינונית (זיהוי קווי טקסט בלבד; ללא ניתוח מבני ברמת המסמך).
ניתוח פורמט פלט
- היכן הוא מצטיין: הפשטות של אובייקט ההחזרה אינה מתחרה:Mapping this output to a standard REST response or serializing it directly to GeoJSON/custom schemas takes only a few lines of code. It performs reliably on natural scene text, license plates, and isolated document crops.
[ ( [[x1, y1], [x2, y2], [x3, y3], [x4, y4]], "Total Balance Due", 0.9842, ) ] - היכן הוא נכשל: EasyOCR אינו מבצע ניתוח כולל של פריסת המסמך. הוא אינו מזהה טבלאות, היררכיות כותרות, או סדרי קריאה בעמודות מורכבות. שימוש ב‑EasyOCR על מאמר אקדמי דו‑עמודי לעיתים מייצר קטעי טקסט משולבים אלא אם הוא משולב עם מודל זיהוי פריסה קדם (כגון YOLO או LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya is a modern deep-learning OCR framework designed specifically for complex document understanding and LLM ingest pipelines.
פורמטים מקוריים של פלט
- תוצרים ראשיים: מבני JSON מודליים באמצעות Pydantic, אינדקסי סדר קריאה לוגיים, אזורי גבול של פריסה, ופוליגונים לזיהוי קווים.
- מודעות לפריסה: גבוה מאוד (ניתוח פריסה מבוסס למידת עומק ומיון סדר קריאה).
ניתוח פורמט הפלט
- היכן הוא מצטיין: Surya מתמודדת ישירות עם האתגרים של הנדסת AI מודרנית. במקום להניח שהמסמכים נקראים מלמעלה למטה, משמאל לימין, Surya משחררת מודל ייעודי לחזות סדר קריאה. היא מקבצת שורות לחסימות סמנטיות לוגיות, מטפלת בטבעיות במרחבי עמודים מרובים, ומפיקה מבנים טיפוסיים דרך Pydantic. זה מאפשר אינגסטיה של downstream לבסיסי נתונים וקטוריים וממירים ל-Markdown בצורה ישירה ואמינה.
- היכן הוא נופל בחסר: כ-framework חדש וכבד יותר מבוסס PyTorch, Surya דורשת משאבי GPU ייעודיים כדי להתאים לקצב העיבוד של מנועי C++ מותאמים כמו Tesseract או מודלים Paddle מכווצים. היא אינה מכוונת לתקנים ארכיביים ישנים כמו hOCR או ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
טבלת השוואה ראש-אל-ראש
| יכולת / פורמט | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| מקורי hOCR / ALTO XML | תמיכה מובנית | רק צד שלישי | ללא | ללא |
| גאומטריית תיבת גבול | מיושר לציר (x, y, w, h) | פוליגון בעל 4 נקודות | פוליגון בעל 4 נקודות | פוליגון + בלוקי פריסה |
| פירוש טבלה | קואורדינטות TSV בלבד | מחרוזות טבלאות HTML | ללא | רשתות קואורדינטות של תאים |
| זיהוי סדר קריאה | מבוסס כללים (מתקף בטבלאות מרובות עמודות) | ניתוח פריסה של למידת מכונה | קיבוץ שורות בסיסי | מודל סדר קריאה ייעודי |
| סכימות JSON ישירות | דורש המרה | מילון פייתון / JSON | רשימת פייתון / JSON | מודלים Typed Pydantic |
| יעד זרם מטה אידיאלי | קבצי PDF ארכיביים, DMS מורשת | נתוני טפסים/קבלות, ERP | סקריפטים מהירים, טקסט סצנה | איסוף LLM, ארכיטקטורות RAG |
המלצות צינור עבודה: איזו לבחור?
- בחר ב‑Tesseract אם דרישות הציות שלך דורשות תוצרים מתוקנים
hOCR,ALTO XML, או PDF/A ניתנים לחיפוש עבור רשומות ממשלתיות או ארכיוניות. - בחר ב‑PaddleOCR אם אתה מעבד מסמכים פיננסיים תפעוליים (חשבוניות, קבלות, טפסי מס) המכילים טבלאות מורכבות ללא גבולות שצריך להמיר ל‑HTML או גיליונות אלקטרוניים.
- בחר ב‑EasyOCR אם אתה צריך ספרייה קלה, פייתונית, לזיהוי והוצאת טקסט מתמונות טבעיות, שלטי רחוב, או רכיבי UI חתוכים ללא צורך בתצורה מורכבת.
- בחר ב‑Surya OCR אם אתה מזין דוחות עסקיים לא מובנים, מאמרי מחקר, ומדריכים טכניים לתוך LLM או מנוע חיפוש וקטורי שבו סדר קריאה לוגי וגבולות מבניים נקיים הם קריטיים.
שאלות נפוצות (FAQ)
1. איזה פורמט פלט OCR בקוד פתוח הוא הקל ביותר להזנה למודלים גדולים של שפה?
Surya OCR’s reading-order-aware JSON and PaddleOCR PP-Structure’s HTML tables provide the cleanest representations for LLM prompt contexts and RAG indexing.
2. האם Tesseract יכול לייצר תגובות JSON באופן טבעי ללא כלים של צד שלישי?
No, Tesseract outputs text, TSV, PDF, and hOCR/ALTO XML natively; producing JSON requires converting its TSV or hOCR output using an intermediate parser.
3. איך קואורדינטות פוליגון של 4 נקודות שונות מתיבות גבול מיושרות לצירים?
Axis-aligned boxes use [x, y, width, height] assuming flat text, while 4-point polygons provide four coordinate pairs to accurately enclose rotated, skewed, or curved text lines.
4. איזו מנוע מפיק מבני טבלאות ישירות לקוד במקום לקואורדינטות רפויות?
PaddleOCR’s PP-Structure module reconstructs detected table boundaries into complete HTML table tags (<table>, <tr>, <td>), avoiding custom spatial math.
5. למה הפלט הסטנדרטי של EasyOCR מתקשה במאמרים מדעיים מרובי עמודות?
EasyOCR identifies text lines based on local proximity rather than global layout hierarchy, causing text from adjacent columns to intertwine unless bounded by an external layout engine.