עודכן לאחרונה: 20 באוג, 2026
פורמטים של קבצי OCR למסמכים היסטוריים וכתובים ידנית
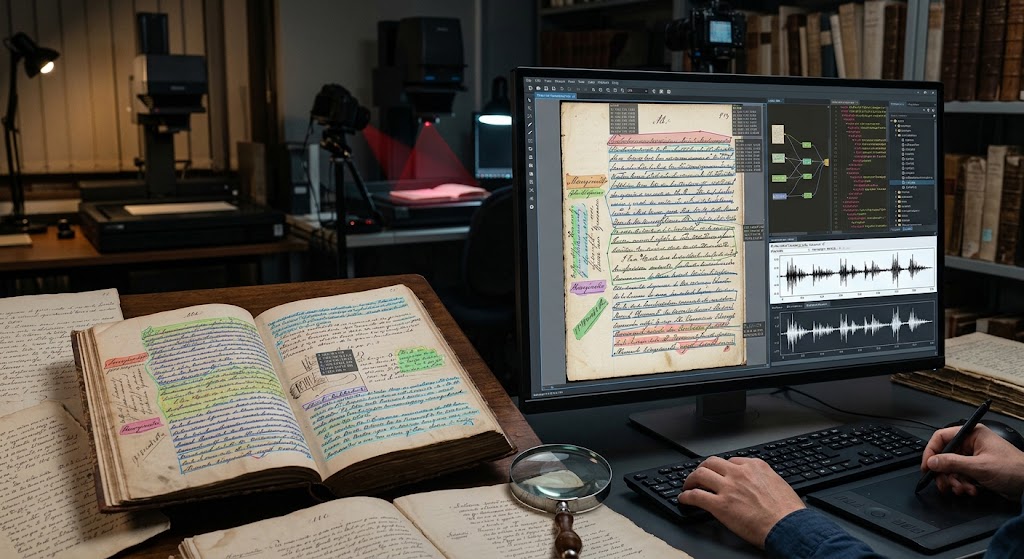
שימור המורשת התרבותית באמצעות דיגיטציה נכנס לתקופת תחייה. בעוד שמערכות זיהוי תווים אופטי (OCR) מוקדמות נבנו כדי לנתח מסמכים נקיים, מודפסים במכונה מהמאה העשרים, מוסדות המורשת התרבותית של היום מתמודדים עם אתגר הרבה יותר מורכב ועשיר: כתבי יד ימי‑ביניימיים, מכתבים קורסיביים מהמאה התשע‑עשרה, חוברות מואירות שבירות, ורשומות בן‑מאה.
העתקת מסמכים היסטוריים איננה עוד רק על חילוץ טקסט ASCII פשוט. היא דורשת לכידת הקשר—הגיאומטריה הפיזית של העמוד, עקומות קו הבסיס, תיקוני חדירת דיו, הערות שוליים, קיצורים, וחוסר וודאות פאלוגרפית. תחום ייחודי זה, שלרוב מסווג תחת זיהוי טקסט כתוב יד (HTR), תלוי במידה רבה בפורמט הקובץ המשמש לאחסון והחלפת הן קואורדינטות תמונה והן שכבות טקסט.
בחירת הסכמה הלא נכונה יכולה להסיר נתוני קו בסיס חיוניים, לשבור יישור עם מניפסטים של IIIF (International Image Interoperability Framework), או למנוע שימור דיגיטלי ארוך טווח. הנה מדריך מקיף לפורמטים המובילים של קבצי OCR ו‑HTR למסמכים היסטוריים, החוזקות המבניות שלהם, וכיצד לקבוע את הבחירה הנכונה לצינור הארכיון שלך.
הדילמה ההיסטורית: למה טקסט פשוט וקבצי PDF סטנדרטיים נכשלים
OCR מודפס במכונה לרוב מייצר קבצי .txt פשוטים או קבצי PDF "sandwich" עם שכבות טקסט מוסתרות מתחת לסריקה. עבור כתבי יד היסטוריים וכתיבה קורסיבית, פלטים אלה נכשלות בשל שלושה גורמים מרכזיים:
- טקסט לא ליניארי ועיצובים מורכבים: העתונאים ההיסטוריים לא שמרו על רשתות מלבניות מסודרות. הטקסט נופל לתוך השוליים, מתפתל סביב אותיות ראשוניות מואירות, משזף בין תיקונים אינטרליניאריים שהוכנסו, או רץ אנכית לאורך הגב.
- קווי בסיס מעוגלים ומשופעים: כתיבה בכתב יד נדירה לעקוב אחרי ציר אופקי קשיח. מנועי HTR כמו Transkribus, Kraken, ו‑eScriptorium מסתמכים על קווי בסיס פוליליניים במקום תיבות גבול כדי לפרש כתב עם הרבה קישורים.
- פאליאוגרפיה ונתוני מטא: מחקר ארכיוני דורש מעקב אחרי קיצורים, וריאציות איות היסטוריות, קריאות פגומות, וציוני אמון ברמת השורה. פורמטים סטנדרטיים של מסמכים מזניבים את הרזולוציה הזו.
כדי לשמור על נאמנות למקור האובייקט, קהילת הארכיונים מסתמכת על סכמות XML מובנות שנועדו לשמר את טופולוגיית העיצוב לצד הטקסט המתועתק.
1. PAGE XML: הסטנדרט המוזהב לזיהוי טקסט כתוב ידנית (HTR)
שפות על ידי מעבדת המחקר PRImA (זיהוי תבניות וניתוח תמונה), PAGE XML (Page Analysis and Groundtruth Elements) נחשבת באופן רחב לפורמט המתקדם ביותר לזיהוי טקסט בכתב יד ולניתוח עיצוב מתקדם.
ארכיטקטורה מרכזית
PAGE XML מתייחסת למסמך הפיזי כמבנה היררכי:
PcGts(שורש)Page(ממדי התמונה וסדר הקריאה הכולל)TextRegion(פסקאות, כותרות, הערות שוליים, מילות קידוד)TextLineCoords(קואורדינטות פוליגון סביב השורה)Baseline(סדרה של נקודות העוקבות אחרי קו הבסיס האמיתי של הכתב)TextEquiv(הטקסט המזוהה, עם מדדי אמינות אופציונליים)
למה הוא מצטיין בכתבי יד היסטוריים
- דיוק פוליגון וקו פוליליין: במקום לכפות תווים לתוך תיבות מרובעות, PAGE XML משתמשת בגבולות פוליגון מרובי‑נקודות וקווי בסיס רציפים. זה מונע מהחלקים העולים והיורדים של כתב יד חופפים להפריע לחלוקה.
- סוגי מבנה גרגריים: ניתן לסווג אזורים במדויק (למשל,
marginalia,drop-capital,signature-mark,header,editorial-note). - מערכת תוכנה רחבה: זה משמש כסכמת הפנים והייצוא הראשית לפלטפורמות HTR הדגליות כגון Transkribus, eScriptorium, ו-Kraken.
2. ALTO XML: מרכז הכוח של הספרייה והארכיונים
ALTO (Analyzed Layout and Text Object) הוא תקן XML פתוח המתוחזק על ידי הספרייה של הקונגרס ונאמן על ידי ספריות לאומיות רבות, כולל Bibliothèque nationale de France (BnF) והספרייה הבריטית.
ארכיטקטורה מרכזית
ALTO מארגן את הפריסה באופן היררכי מ-Page עד PrintSpace, ולאחר מכן ל-TextBlock, TextLine, ו-String (מילים או טוקנים בודדים). הוא לעיתים קרובות ארוז בתוך עטיפה של METS (Metadata Encoding and Transmission Standard) כדי לקשר מטא-נתונים מבניים עם תמונות מאסטר ברזולוציה גבוהה.
יתרונות מרכזיים ומקרי שימוש
- תהליכי דיגיטציה המוניים: ALTO נוצר עם מחשבה על דיגיטציה בתעשייה של עיתונים וספרים בקנה מידה תעשייתי. הוא מקודד בצורה נקייה תכונות גופן, קואורדינטות ברמת מילה, רמת אמון של תווים, ורווחים.
- תמיכה מודרנית ב-HTR (ALTO 4): גרסאות קודמות של ALTO נשענו במידה רבה על קואורדינטות מלבניות (
HPOS,VPOS,WIDTH,HEIGHT). עם זאת, החל מ-גרסה 4 של ALTO, הסכמה הציגה פוליגונים<Shape>וקווי בסיס פוליליניים, וסגרה את הפער הפונקציונלי עם PAGE XML עבור חומרים כתובים ביד. - שימור לטווח ארוך: מכיוון שזהו תקן רשמי הנתמך על ידי קונסורציום ספריות בינלאומי, ALTO מבטיח יציבות לטווח ארוך ותאימות לאחור ברמת ארכיון.
3. hOCR: תקן קל ומבוסס על רשת
נוצר על ידי תומאס ברוול, hOCR נוקט בגישה פרגמטית: במקום ליצור סכמת XML חדשה לחלוטין, הוא משלב מטא-נתוני פריסה ותמלול ישירות ב-HTML/XHTML סמנטי באמצעות מיקרו-פורמטים ותכונות מחלקה.
דוגמה טיפוסית של תחביר
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">התחלה</span>
      </span>
    </p>
  </div>
</div>
יתרונות וחסרונות של חומרים היסטוריים
- יתרונות: דפדפנים יכולים להציג אותו באופן טבעי. הוא ניתן להמרה בקלות באמצעות CSS ו-JavaScript רגילים, והוא פורמט הייצוא המובנה המוגדר כברירת מחדל למנועים כמו Tesseract.
- חסרונות: התמיכה הטבעית בעקומות בסיס מרובות נקודות מורכבות וחופשיות מוגבלת. למרות שהיא פרקטית עבור עבודות מודפסות מוקדמות (אינקונבולה או עלונים נקיים), hOCR מתמודד עם פריסות כתב יד בלתי סדירות ומרקמים שוליים מרובי שכבות.
4. TEI-XML: תקן האקדמי והדיגיטלי למדעי הרוח
פורמט Text Encoding Initiative (TEI) אינו בדיוק פורמט פלט של מנוע OCR; אלא, הוא הסטנדרט המוביל לעריכות דיגיטליות ביקורתיות ולייצוג אקדמי של טקסטים ספרותיים והיסטוריים.
חיבור OCR/HTR ל-TEI
צינורות מודרניים כמעט ולא נעצרים בזיהוי תווים גולמי. חוקרים משתמשים בכלים כמו Transkribus TEI Exporter או צינורות XSLT אוטומטיים כדי לתרגם קבצי PAGE XML או ALTO ל-XML תואם TEI:
- קיצורים מורחבים (
<choice><abbr>...</abbr><expan>...</expan></choice>). - מחיקות, תוספות וכתבי יד מסווגים פורמלית (
<add>,<del>,<handShift>). - נתוני הפריסה נשמרים לצד ניתוח ספרותי באמצעות אלמנטים
<facsimile>ו-<surface>.
אם הפרויקט ההיסטורי שלך שואף ליצור עריכה ביקורתית אינטראקטיבית או ארכיון אקדמי הניתן לחיפוש סמנטי, המרת נתוני OCR/HTR ל-TEI-XML היא לרוב הצעד הסופי הנדרש.
מטריצה השוואתית: פורמטים של OCR/HTR במבט כולל
| תכונה / קריטריון | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| תחום ראשי | HTR כתב יד וכתבי יד | דיגיטציה המונית של ספריות | OCR אינטרנטי וחיפוש קל | מהדורות ביקורתיות אקדמיות |
| תמיכה בסיסית | מקוריים, פוליליינים מרובי‑נקודות | נתמך (מאז גרסה 4.0) | בסיסי (שיפוע/הזזה) | באמצעות מיפוי פקסימיליה |
| פוליגונים לא סדירים | מלא | מלא | מוגבל | באמצעות רכיבי קואורדינטות |
| מערכת כלי | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, מציגי רשת | Oxygen, TEI Publisher |
| גוף תקינה | PRImA Group / פתוח | ספריית הקונגרס | מפרט קהילה | קונסורציום TEI |
המלצות מעשיות: בחירת צינור העבודה הארכיוני שלך
כדי להקים קו דיגיטציה יעיל ועמיד לעתיד:
- לכתבי יד וארכיונים כתובים טהורים: אחיד את הטרנסקריפציה והוצאת הפריסה שלך ב-PAGE XML. חישוב הקו הבסיסי והקונטור הפוליגוני שלו מתמודדים עם כתבים לא סטנדרטיים עם אובדן נתונים מינימלי.
- לספריות בקנה מידה גדול ואוספים מעורבים: בחר ב-ALTO XML (v4.2 או גבוה יותר) משולב עם METS. זה מבטיח אינטגרציה חלקה למבני מאגרי דיגיטל סטנדרטיים ולמערכות ניהול נכסים דיגיטליים (DAMS).
- להצגת אינטרנט ואינדקסי חיפוש טקסט מלא: השתמש ב-hOCR או הפק מבני GeoJSON/הערות רשת קלים משנת PAGE XML כדי להפעיל מציגי IIIF אינטראקטיביים (כגון Mirador או Universal Viewer) עם שכבות טקסט חיות בדפדפן.
- לגרסאות מדעיות ולמחקר פאלאוגרפי: צור את האמת הבסיסית שלך ב-PAGE XML, בצע זיהוי, והעבר את הפלט דרך ממיר אוטומטי כדי ליצור TEI-XML לסימון עריכה.
על ידי התאמת היכולות המבניות של פורמטים אלה לדרישות הפאלוגרפיות של חומר המקור שלך, אתה מבטיח שכל קו, קיצור, ונקודת נואנס היסטורית יישארו קריאים למאות השנים הבאות.
שאלות נפוצות (FAQ)
שאלה 1. מה ההבדל הבסיסי בין OCR סטנדרטי ל-HTR? OCR מזהה טיפוגרפיה מודפסת באופן עקבי, בעוד ש-HTR (זיהוי טקסט ידני) משתמש ברשתות נוירונים עמוקות כדי לפענח כתב יד אנושי רציף, משתנה וקווי בסיס מעוקלים.
שאלה 2. האם Tesseract OCR יכול לייצר PAGE XML או פלט ALTO למסמכים היסטוריים? כן, Tesseract יכול לייצר ALTO XML מקורי ופלט hOCR, ועטיפות של צד שלישי יכולות להמיר תוצאות אלו ל-PAGE XML.
שאלה 3. למה קווי בסיס חשובים יותר מתיבות גבול בתמלול טקסט ידני? קווי בסיס עוקבים אחרי הקו הטבעי והמתנודד של כתב יד אנושי, ומאפשרים לתוכנה להפריד בין חלקים עולים ויורדים חופפים שמתנגשים בתוך תיבות גבול קשוחות.
שאלה 4. איך תקן IIIF מתקשר עם פורמטי קבצי OCR האלה? IIIF מספק תמונות ברזולוציה גבוהה דרך APIים פתוחים של רשת, בעוד פורמטים כמו ALTO או PAGE XML מספקים נתוני קואורדינטות שניתן להמיר לאנוטציות חיפוש תוכן של IIIF.
שאלה 5. איזה פורמט קובץ הוא הקל ביותר להמרה ישירה לקובץ PDF שניתן לחיפוש? גם hOCR וגם ALTO XML יכולים להיות משולבים עם תמונות העמוד המקוריות כדי ליצור קבצי PDF דו‑שכבתיים שניתנים לחיפוש באמצעות כלים כמו OCRmyPDF.