עודכן לאחרונה: 30 ספטמבר, 2026
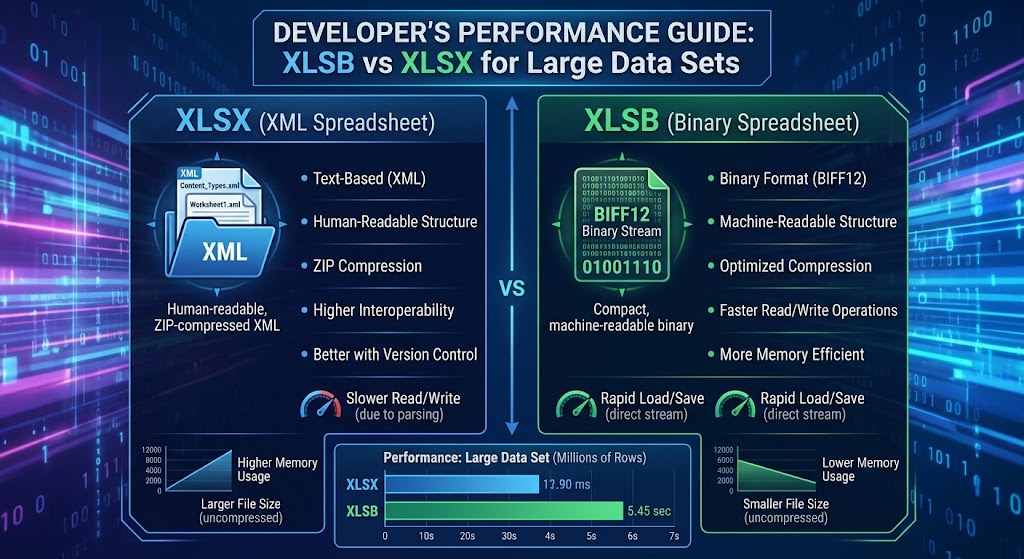
XLSB נגד XLSX עבור מערכי נתונים גדולים: מדריך ביצועים למפתחים
אם אתה בונה צינורות נתונים, מנועי דיווח בגיבוי, או כלי אנליטיקה שמתחברים ל-Microsoft Excel, סביר להניח שנתקלת ב"הקיר".
משתמש מעלה חוברת עבודה של 450,000 שורות. השרת שלך מפעיל חוטי עבודה, צריכת הזיכרון מתפוצצת לגיגבייטים, איסוף הזבל מקפיא את זמן הריצה, והביצוע שלך מתפוגג. אתה בודק את המידע: זהו קובץ .xlsx סטנדרטי.
כדי לפתור זאת, מפתחים מבלים לעיתים ימים ביישום חיתוך, מפענחים זורמים, או בהעברת קבצים לעובדים ברקע. עם זאת, אחת האופטימיזציות היעילות ביותר דורשת אפס שינוי ארכיטקטוני: שינוי סיומת הקובץ מ-.xlsx ל-.xlsb.
במדריך זה, אנו חודרים מתחת למכסה של שני הפורמטים, בודקים מדוע הארכיטקטורות הפנימיות שלהם מייצרות מאפייני ביצועים שונים באופן רדיקלי, משווים מדדי ביצוע קונקרטיים בין Python ל-.NET, ומציגים כללים ברורים מתי לפרוס חוברות עבודה בינריות בייצור.
1. מתחת למכסה: OpenXML נגד BIFF12
כדי להבין מדוע הביצועים מתפצלים בצורה כה דרמטית על מערכי נתונים גדולים, עלינו לבחון כיצד כל פורמט מאחסן רשומות על הדיסק.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
קבצי .xlsx ו-.xlsb הם מכולות ZIP דחוסות המתאימות לתקני Open Packaging Conventions (OPC). אם תשנה את שם הקובץ ל-.zip ותוציא אותו, תראה מבנה תיקיות מוכר: _rels, docProps, ו-xl/worksheets/.
ההבדל הקריטי נמצא בתוך התיקייה xl/worksheets/:
- XLSX מאחסן גיליונות כטקסט XML פשוט (
sheet1.xml). - XLSB מאחסן גיליונות כזרמי בינאריים קנייניים (
sheet1.bin), מקודד באמצעות BIFF12 של מיקרוסופט (Binary Interchange File Format 12).
כיצד XLSX מקודד נתונים (עומס XML DOM)
בגיליון XLSX, כל תא מוגדר עם תגיות XML מפורשות:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
כאשר קוראים שורה זו, סביבת הריצה שלך חייבת:
- לפרוס את זרם ה‑deflate הגולמי לטקסט.
- לפרק למילים ולנתח תווי מחרוזת לתוך DOM של XML או זרם אירועי SAX.
- אמת את תגיות הפתיחה והסגירה (
<c>,</c>,<v>,</v>). - פתור חיפושי מחרוזות מטבלה נפרדת
sharedStrings.xml. - פענח את הטקסט ASCII
"98234.55"למספר נקודה צפה IEEE 754 של 64‑ביט.
כל תא בודד גורם לעומס CPU עבור ניתוח מחרוזות, הקצאת מחרוזות וניתוח לקסיקלי. הכפל זאת על פני 500,000 שורות ו‑30 עמודות (15 מיליון תאים), וה‑CPU מבזבז מחזורים רבים יותר בניתוח תחביר מאשר בעיבוד ערכי התחום.
כיצד XLSB מקודד נתונים (זרם בינארי BIFF12)
BIFF12 מוותר על סריאליזציית טקסט לחלוטין. במקום סימון מחרוזות, הנתונים מסודרים כרצף רציף של רשומות בינריות באורך משתנה:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
תא נקודה צפה ב‑BIFF12 אינו משתמש בייצוגי מחרוזת כמו "98234.55". הוא מיוצג ישירות:
- 2 בתים למזהה הרשומה (למשל,
BrtCellRkאוBrtCellReal) - 4 בתים לאינדקסי עמודה/שורה
- 8 בתים המכילים את המבנה הגולמי של IEEE 754 ברמת דיוק כפול
כאשר המפענח שלך קורא קובץ XLSB, הוא מדלג לחלוטין על ניתוח לקסיקלי. הוא קורא את כותרת הרשומה, תופס את 8 הבתים הגולמיים מהמאגר, מעתיק אותם ישירות לזיכרון, ומזיז את הסמן קדימה. אין תגים לאימות, אין המרות מסוג מחרוזת למספר, ואין עלות פענוח UTF-8 עבור נתונים מספריים.
2. מדדי כמותיים: דיסק, זיכרון וקצב העברה
כדי להמחיש את ההשפעה בעולם האמיתי, שקול ערכת נתונים מדומה המכילה 750,000 שורות ו‑25 עמודות (תערובת של חותמות זמן, מספרים בנקודה צפה, שלמים וקודי קטגוריה).
הבדיקות למטה מעריכות נתונים טבלאיים זהים שנשמרו גם כ‑XLSX וגם כ‑XLSB.
סביבת בדיקה
- CPU: AMD Ryzen 9 5900X (12 ליבות, 24 חוטים)
- RAM: 64 ג״ב DDR4-3600
- אחסון: PCIe 4.0 NVMe SSD
- זמן ריצה: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
מדדי ביצועים מרכזיים
| מדד | XLSX (OpenXML) | XLSB (BIFF12) | שינוי / שיפור |
|---|---|---|---|
| גודל הקובץ על הדיסק | 128.4 MB | 68.2 MB | ~47% קטן יותר |
| שמירה / זמן סריאליזציה | 42.6 s | 14.1 s | 3.0x מהיר יותר |
| זמן קריאה (Python DOM parser) | 38.2 s | 8.9 s | 4.3x מהיר יותר |
| זמן קריאה (מנוע Rust/C) | 6.4 s | 1.9 s | מהיר ב‑3.3x |
| הקצאת ערמת שיא במהלך קריאה | ~1.85 GB | ~510 MB | ~72% הפחתה |
מדוע קבצי XLSB קטנים יותר
בעוד ששני הפורמטים משתמשים בדחיסת ZIP סטנדרטית, זרמי בינאריים דוחסים בצורה יעילה הרבה יותר מטקסט XML נפוח:
- הסינטקס המיותר מוסר: XML מכיל תגיות חוזרות (
<c r="AA1" s="1">) בכל רשומה בודדת. בעוד דחיסת ZIP מפחיתה מחרוזות חוזרות, זרם הנתונים הלא דחוס הוא עצום. - צפיפות מספרית: ב-XML, המספר
12345678.9012דורש 14 בתים של טקסט ASCII. ב-BIFF12, הוא מאוחסן כ-double של 8 בתים (או ארוז ברשומתRKשל 4 בתים אם הוא מתאים לכללי דיוק ספציפיים).
3. טביעת רגל בזיכרון ולחץ איסוף זבל
בשירותי אינטרנט ומיקרו‑שירותים המטפלים בבקשות מקבילות, מהירות ה‑CPU היא רק חצי מהקרב; טביעת הזיכרון היא המקום שבו היישומים נכשלים בפועל.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
כאשר מפענח XML מעבד קובץ XLSX בגודל 100 מ"ב, הוא חייב ליצור אלפי אסימוני מחרוזת זמניים, חוצצי מחרוזת ובדיקות מילון. בשפות עם איסוף זבל (Java, C#, Go, Node.js, Python), זה יוצר פיצול ערימה קיצוני ודוחף את זמן הריצה להפסקות איסוף זבל (GC) תכופות.
מכיוון שהניתוח של XLSB פועל ישירות על פרוסות בתים ברוחב קבוע, המפרשים יכולים לקרוא נתונים למבנים המוקצים למחסנית או למאגרי בתים ניתנים לשימוש חוזר. התוצאה היא footprint זיכרון מצומצם באופן דרמטי ואפס תזוזות של מחלק הזיכרון בזמן ריצה.
4. דוגמאות מימוש למפתחים
בואו נבחן כיצד לנצל את XLSB בשרשראות כלי פיתוח נפוצות.
Python: מעבר מ-OpenPyXL ל-Calamine / PyXLSB
הפונקציה הסטנדרטית pandas.read_excel('data.xlsx') משתמשת בברירת מחדל של openpyxl, אשר בונה עץ כבד בזיכרון.
כדי לעבד קבצי XLSB גדולים במהירות מרבית, השתמשו במנוע calamine המונע על ידי Rust (זמין דרך python-calamine ומשולב בפנדס מודרני):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
אם אתם עוברים על מערכי נתונים ענקיים שורה אחרי שורה מבלי לטעון את כל המטריצה ל‑DataFrame, pyxlsb מספק איטרטור זרימה קל משקל:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: קלט זרם בעל ביצועים גבוהים
ב‑.NET, ספריות כמו ClosedXML או EPPlus מצוינות ליצירה סטנדרטית, אך לצריכת קבצים גדולים ללא תצרוכת זיכרון, ExcelDataReader עם תמיכה ב‑XLSB הוא מהיר במיוחד:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. פשרות ארכיטקטוניות: מתי לא להשתמש ב‑XLSB
למרות יתרונות הביצועים המשמעותיים שלו, XLSB אינו פתרון קסם. עליכם לשקול מספר פשרות תפעוליות לפני שמיישמים אותו ברחבי המערכת שלכם:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. תמיכה במערכת האקולוגית ובספריות
- XLSX: אוניברסלי. כמעט כל שפה, ספרייה, כלי SaaS (Google Sheets, Airtable, Tableau), ופרסר אינטרנט תומכים ב‑OpenXML באופן טבעי.
- XLSB: פחות נפוץ. בעוד Excel, LibreOffice וספריות מפתחים מתקדמות (
ExcelDataReader,pyxlsb,calamine,Aspose) תומכות בו, חבילות קלות משקל רבות או פרסרים מבוססי JavaScript אינטרנטיים טהורים (כמו גרסאות ישנות שלSheetJS) מציעים תמיכה מוגבלת או רק קריאה.
2. השוואת שינויים ב‑Git ובמערכת בקרת גרסאות
- XLSX: מכיוון שהוא מכיל XML טקסטואלי בתוך מכולת ZIP, כלי שורת פקודה והוקי Git יכולים לחלץ ולפרמט את ה‑XML כדי ליצור הבדלים מבניים קריאים בין קומיטים.
- XLSB: נתונים בינריים טהורים. מערכות בקרת גרסאות מתייחסות אליו כאל בלוב בינרי אטום, מה שמבטל כל אפשרות להבדלים גרגריים או מיזוגים ברמת שורה.
3. רינדור צד לקוח באינטרנט
אם הארכיטקטורה שלך מתבססת על רינדור גיליונות אלקטרוניים ישירות בדפדפן באמצעות WebAssembly או JavaScript בצד הלקוח, פרסרים של XLSX הם הרבה יותר מתוחזקים ופחות חשופים לבאגי רינדור קיצוניים מאשר פרסרים בינריים בצד הלקוח.
4. צינורות קלט של צד שלישי
אם אתה מייצא קבצים ללקוחות ארגוניים חיצוניים, מדיניות אבטחה תאגידית מחמירה רבות מסמנת קבצי .xlsb. מכיוון שקבצי BIFF12 יכולים לאחסן מקרו VBA באופן זהה לקבצי .xlsm (בלי צורך בהרחבה נפרדת), חלק ממסנני הדואר וסורקי חומות האש מבצעים בידוד של העלאות .xlsb כאיומים פוטנציאליים הנושאים מקרו.
6. השוואה מסכמת: איזה פורמט מנצח?
| תכונה | XLSX | XLSB | זוכה |
|---|---|---|---|
| קריאה / ניתוח מהירות | מתון עד גרוע | מהיר מאוד | XLSB |
| כתיבה / מהירות יצירה | תובעני למעבד | מהיר | XLSB |
| דחיסת קבצים | טוב | מצוין (~40-50% קטן יותר) | XLSB |
| הקצאת זיכרון | גבוה (לחץ גבוה על איסוף זבל) | נמוך (קריאת בתים ישירה) | XLSB |
| תאימות כלי | אוניברסלי | גבוה, אך סלקטיבי | XLSX |
| חיכוך סריקת אבטחה | מינימלי | חיובי שגוי מדי פעם | XLSX |
| יכולת מאקרו | לא (.xlsm נדרש) | כן (תומך במקרו באופן מקורי) | קשר |
7. פסק הדין של המפתחים
השתמש ב-XLSX כאשר:
- הקבצים קטנים עד בינוניים בגודל (< 50,000 שורות).
- הקבצים שלך חייבים להיספג על ידי פלטפורמות SaaS של צד שלישי או אפליקציות צרכניות (למשל, Google Sheets).
- אינך יכול לשלוט בסביבת הלקוח הסופי הקורא את הקובץ.
החלף ל-XLSB כאשר:
- אתה בונה צינורות פנימיים, עבודות אצווה, מערכות ETL, או משימות עובד שמטפל בחילוץ נתונים עצום (> 100,000 שורות).
- השרתים שלכם חווים שגיאות חוסר זיכרון (OOM) במהלך סריאליזציה או דסיריאליזציה של גיליון אלקטרוני.
- עליכם למזער את טביעות הרגל של אחסון S3/Blob ואת זמן המעבר ברשת עבור מודלים פיננסיים חוזרים גדולים או ייצוא נתונים.
המעבר ל‑XLSB הוא לעיתים פשוט כמו שינוי מחרוזת תצורה בשירות הייצוא שלכם, והוא מספק את סוג השיפור בתפוקה של 3‑5 פעמים, שבדרך כלל דורש שבועות של אופטימיזציית קוד.
שאלות נפוצות (FAQ)
**Q1: האם קובץ XLSB תומך באותם מגבלות שורות ועמודות בדיוק כמו קובץ XLSX? כן; שני הפורמטים XLSB ו‑XLSX חולקים את אותה תקרת רשת של 1,048,576 שורות על ידי 16,384 עמודות לכל גיליון.
**Q2: האם קובץ XLSB יכול לאחסן מאקרו VBA בבטחה מבלי לשנות את סיומת הקובץ שלו?
כן, בניגוד ל‑XLSX (שדורש שמירה כ‑XLSM כדי להריץ קוד), XLSB תומך באחסון מאקרו VBA בינארי באופן טבעי בתוך פורמט הקובץ .xlsb עצמו.
**Q3: מדוע שמירת קובץ כ‑XLSB מצמצמת את גודלו אם שני הפורמטים כבר דחוסים ב‑ZIP? XLSB מבטל תגיות סימון טקסט ארוכות ומקודד מיקומי תאים, רשומות וערכים מספריים גולמיים לזרמי בתים בינאריים צפופים הדוחסים בצפיפות גבוהה יותר מאשר מחרוזות XML רגילות.
**Q4: האם Google Sheets יכול לייבא ולערוך קבצי XLSB ישירות?
לא; Google Sheets אינו יכול לפתוח או להמיר קבצי .xlsb באופן מקורי, ולכן יש צורך להמיר אותם ל-.xlsx או CSV לפני הייבוא.
**Q5: האם קבצי XLSB נוטים יותר לשחיתות נתונים מאשר קבצי XLSX? בעוד קבצי XML יכולים לעתים להיבדק או לתוקן ידנית בעזרת עורך טקסט כאשר הם פגומים חלקית, זרמי BIFF12 הבינאריים דורשים מרחקי בתים מדויקים וקשה לשחזרם ידנית אם סקטורים מבניים נפגעים.