अंतिम अपडेट: 20 Aug, 2026
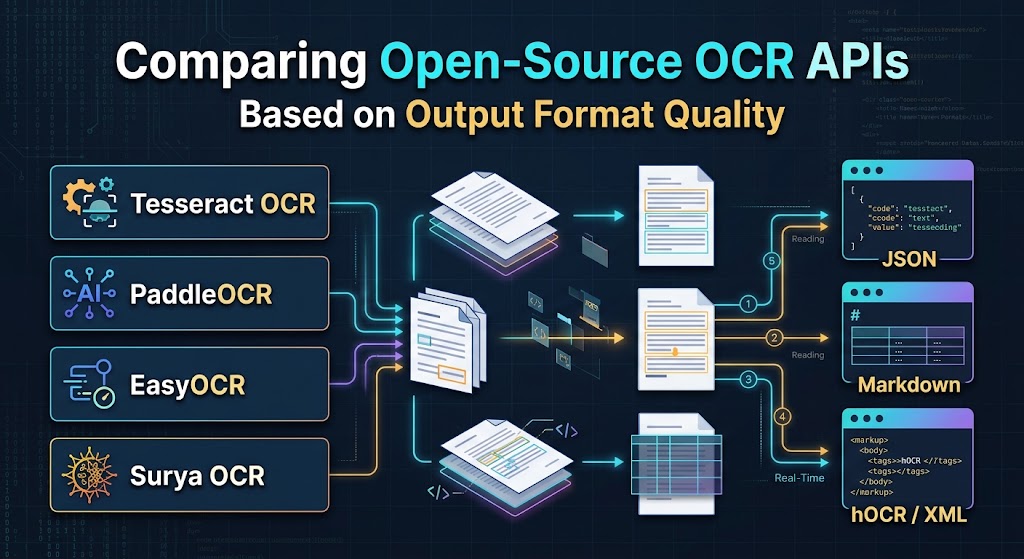
आउटपुट फ़ॉर्मेट क्वालिटी के आधार पर ओपन-सोर्स OCR API की तुलना
जब इंजीनियर ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) इंजनों का मूल्यांकन करते हैं, तो कैरेक्टर एरर रेट (CER) और वर्ड एरर रेट (WER) आमतौर पर बेंचमार्क को हावी करते हैं। जबकि पहचान की सटीकता आवश्यक है, यह उत्पादन में केवल आधी समस्या को हल करता है।
यदि आप जटिल मल्टी-कॉलम PDFs को पार्स कर रहे हैं, रसीदों से लाइन आइटम निकाल रहे हैं, या व्हाइटपेपर को LLM एम्बेडिंग पाइपलाइन में इनजेस्ट कर रहे हैं, तो कच्चे टेक्स्ट डंप्स भारी इंजीनियरिंग ओवरहेड पैदा करते हैं। लेआउट जागरूकता, तार्किक पढ़ने क्रम, या निर्देशांक डेटा के बिना अक्षरों की स्ट्रिंग आपकी टीम को नाज़ुक हीयुरिस्टिक पार्सर लिखने के लिए मजबूर करती है।
आधुनिक दस्तावेज़ वर्कफ़्लो के लिए वास्तविक अंतरकर्ता आउटपुट फ़ॉर्मेट क्वालिटी है: एक इंजन कितनी सुसंगत और साफ़ तरीके से निर्देशांक, पढ़ने का क्रम, संरचनात्मक पदानुक्रम, और तालिका डेटा प्रदान करता है।
नीचे चार प्रमुख ओपन-सोर्स OCR इंजनों—Tesseract, PaddleOCR, EasyOCR, और Surya OCR—की एक इंजीनियरिंग-फ़ोकस्ड तुलना दी गई है, जो यह मूल्यांकन करती है कि उनके आउटपुट स्वचालित पाइपलाइनों के भीतर कैसे व्यवहार करते हैं।
सामान्य आउटपुट फ़ॉर्मेट्स: इंजीनियरों को वास्तव में क्या चाहिए
प्रत्येक OCR API पहचाने गए टेक्स्ट को अलग-अलग पैकेज करता है। इन फ़ॉर्मैट्स को समझना यह निर्धारित करने में मदद करता है कि आपके पाइपलाइन को कितना पोस्ट-प्रोसेसिंग चाहिए:
- सादा पाठ (
.txt): सबसे सरल प्रतिनिधित्व। यह सभी स्थितीय मेटाडेटा को हटा देता है और बहु-स्तंभ लेआउट को क्षैतिज पढ़ने में बदल देता है, जिससे पैराग्राफ़ बिखर सकते हैं। - आर्काइव मानक (
hOCR,ALTO XML): लाइब्रेरी अभिलेख में मानक XML/HTML-आधारित फ़ॉर्मैट। ये कोऑर्डिनेट्स, फ़ॉन्ट अनुमान, और विश्वसनीयता रेटिंग्स को DOM नोड्स में एम्बेड करते हैं। दस्तावेज़ पुनर्निर्माण के लिए अत्यधिक मजबूत, लेकिन माइक्रोसर्विसेज़ के लिए भारी। - संरचित JSON: आधुनिक वेब बैकएंड के लिए डिफ़ॉल्ट विकल्प। यह कोऑर्डिनेट एरेज़ (बाउंडिंग बॉक्स या पॉलीगॉन), विश्वसनीयता रेटिंग्स, और पदानुक्रमित ब्लॉक/लाइन/शब्द संरचनाएँ प्रदान करता है।
- मार्कडाउन (
.md) / HTML टेबल्स: Retrieval-Augmented Generation (RAG) के लिए आधुनिक मानक। यह अर्थपूर्ण सेक्शन (हेडर, सूची, बोल्ड टेक्स्ट) और तालिकीय मैट्रिक्स को संरक्षित रखता है बिना डाउनस्ट्रीम स्पेशियल पुनर्निर्माण की आवश्यकता के।
1. Tesseract OCR
Google द्वारा बनाए रखा गया, Tesseract ओपन-सोर्स OCR का मूलभूत कार्यकर्ता बना हुआ है। इसकी आर्किटेक्चर पारंपरिक पेज सेगमेंटेशन एल्गोरिदम पर भारी निर्भर करती है, जिसे LSTM-आधारित कैरेक्टर इंजन द्वारा पूरक किया गया है।
देशी आउटपुट फ़ॉर्मेट
- मुख्य आउटपुट: सादा पाठ, hOCR (HTML), ALTO XML, TSV (Tab-Separated Values), और searchable PDF/A.
- लेआउट जागरूकता: पेज सेगमेंटेशन मोड्स (PSM) के माध्यम से नियम-आधारित हीयुरिस्टिक्स।
आउटपुट फ़ॉर्मेट विश्लेषण
- जहाँ यह उत्कृष्ट है: Tesseract का
TSVऔरhOCRनिर्यात मानकीकृत और पूर्वानुमेय हैं। एकल TSV निर्यातlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,height, औरconfके लिए संरचित कॉलम लौटाता है। यदि आप कागज़ी अभिलेखों को searchable PDFs में बदल रहे हैं या संस्थागत मानकों का कड़ा पालन आवश्यक है, तो Tesseract इसे बिना किसी कस्टम ग्लू कोड के स्वाभाविक रूप से संभालता है। - जहाँ यह कम पड़ता है: Tesseract के पास मूल JSON API नहीं है। इसका आउटपुट Python या Node.js में उपयोग करने के लिए XML/TSV फ़ाइलों को पार्स करना या
pytesseractजैसे रैपर का उपयोग करना आवश्यक है। इसका लेआउट इंजन भी गैर-मानक कॉलम प्रवाह के साथ संघर्ष करता है, अक्सर निकटवर्ती कॉलमों से पाठ को मिलाता है जब तक कि मैन्युअल बाउंडिंग क्रॉप प्रदान न किए जाएँ।
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Baidu के PaddlePaddle फ्रेमवर्क द्वारा समर्थित, PaddleOCR ने अपने हल्के मॉडल, व्यापक बहु-भाषा कवरेज, और समर्पित दस्तावेज़ विश्लेषण टूलकिट (PP-Structure) के कारण व्यापक अपनापन प्राप्त किया है।
देशी आउटपुट फ़ॉर्मेट
- मुख्य आउटपुट: Python सूची/डिक्शनरी, कच्चा JSON, विज़ुअलाइज़ेशन ओवरले, और PP-Structure के माध्यम से संरचित HTML।
- लेआउट जागरूकता: उच्च (लेआउट पार्सिंग, अभिविन्यास वर्गीकरण, और टेबल पुनर्प्राप्ति के लिए डीप लर्निंग मॉडलों का उपयोग करके)।
आउटपुट फ़ॉर्मेट विश्लेषण
- जहाँ यह उत्कृष्ट है: Standard PaddleOCR 4-बिंदु बहुभुज निर्देशांक (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) को टेक्स्ट स्ट्रिंग्स और कॉन्फिडेंस स्कोर के साथ लौटाता है। यह तिरछे या वक्र टेक्स्ट को सहजता से संभालता है। हालांकि, इसकी वास्तविक शक्ति PP-Structure सूट में निहित है, जो लेआउट क्षेत्रों (शीर्षक, टेक्स्ट, टेबल, चित्र) का पता लगाता है और टेबल को सीधे वैध HTML स्ट्रिंग्स (<table>...</table>) में पार्स करता है। यह बाउंडिंग बॉक्स से सेल स्पैन को मैन्युअल रूप से गणना करने की आवश्यकता को समाप्त करता है। - जहाँ यह कम पड़ता है: बेस API नेस्टेड एरेज़ लौटाता है जिनमें विभिन्न संस्करणों में मानक प्रॉपर्टी कुंजियाँ नहीं होतीं। संरचित अनुप्रयोगों के लिए, डेवलपर्स आमतौर पर फ़ील्ड नामों (
bbox,text,confidence) को मानकीकृत करने के लिए एक मध्यवर्ती एडाप्टर लिखते हैं।
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
JaidenAI द्वारा PyTorch पर निर्मित, EasyOCR तेज़ डेवलपर अपनाने के लिए बनाया गया है। यह CRAFT (टेक्स्ट डिटेक्शन के लिए कैरेक्टर रीजन अवेयरनेस) को डीप लर्निंग रिकग्निशन नेटवर्क्स के साथ एक न्यूनतम API में पैकेज करता है।
देशी आउटपुट फ़ॉर्मेट
- मुख्य आउटपुट: Python सूचियाँ जिनमें निर्देशांक के ट्यूपल, पहचाने गए स्ट्रिंग्स, और विश्वसनीयता मान होते हैं।
- लेआउट जागरूकता: कम से मध्यम (केवल टेक्स्ट-लाइन डिटेक्शन; दस्तावेज़-स्तर की संरचनात्मक पार्सिंग नहीं)।
आउटपुट फ़ॉर्मेट विश्लेषण
- जहाँ यह उत्कृष्ट है: रिटर्न ऑब्जेक्ट की सरलता बेजोड़ है:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
इस आउटपुट को एक मानक REST प्रतिक्रिया में मैप करना या इसे सीधे GeoJSON/कस्टम स्कीमा में सीरियलाइज़ करना केवल कुछ लाइनों के कोड में हो जाता है। यह प्राकृतिक दृश्य टेक्स्ट, लाइसेंस प्लेट, और अलग‑अलग दस्तावेज़ क्रॉप्स पर विश्वसनीय रूप से कार्य करता है।
- जहाँ यह कम पड़ता है: EasyOCR समग्र दस्तावेज़ लेआउट विश्लेषण नहीं करता। यह तालिकाएँ, शीर्षक पदानुक्रम, या जटिल कॉलमों में पढ़ने के क्रम की पहचान नहीं करता। दो‑कॉलम शैक्षणिक पेपर पर EasyOCR का उपयोग अक्सर आपस में जुड़े टेक्स्ट स्निपेट्स उत्पन्न करता है, जब तक कि इसे अपस्ट्रीम लेआउट डिटेक्शन मॉडल (जैसे YOLO या LayoutLM) के साथ नहीं जोड़ा जाता।
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. सूर्य OCR
Surya एक आधुनिक डीप-लर्निंग OCR फ्रेमवर्क है जो विशेष रूप से जटिल दस्तावेज़ समझ और LLM इन्जेस्ट पाइपलाइन के लिए डिज़ाइन किया गया है।
मूल आउटपुट फ़ॉर्मेट
- मुख्य आउटपुट: Pydantic-आधारित JSON संरचनाएँ, तार्किक पढ़ने क्रम सूचकांक, लेआउट बाउंडिंग क्षेत्र, और लाइन डिटेक्शन पॉलीगॉन।
- लेआउट जागरूकता: अत्यधिक उच्च (डीप-लर्निंग-आधारित लेआउट विश्लेषण और रीडिंग ऑर्डर सॉर्टिंग)।
आउटपुट फ़ॉर्मेट विश्लेषण
- जहाँ यह उत्कृष्ट है: Surya सीधे आधुनिक AI इंजीनियरिंग की चुनौतियों को संबोधित करता है। दस्तावेज़ों को ऊपर‑से‑नीचे, बाएँ‑से‑दाएँ पढ़ा जाने का अनुमान लगाने के बजाय, Surya एक समर्पित मॉडल को reading order की भविष्यवाणी करने के लिए तैनात करता है। यह पंक्तियों को तर्कसंगत सेमांटिक ब्लॉकों में समूहित करता है, बहु‑स्तंभ स्पैन को स्वाभाविक रूप से संभालता है, और Pydantic के माध्यम से टाइप्ड संरचनाएँ आउटपुट करता है। इससे वेक्टर डेटाबेस और Markdown कनवर्टर्स में डाउनस्ट्रीम इन्जेशन सीधे और विश्वसनीय बनता है।
- जहाँ यह कम पड़ता है: एक नई, भारी PyTorch‑आधारित फ्रेमवर्क होने के नाते, Surya को अनुकूलित C++ इंजनों जैसे Tesseract या क्वांटाइज़्ड Paddle मॉडलों की थ्रूपुट से मेल खाने के लिए समर्पित GPU कंप्यूट की आवश्यकता होती है। यह hOCR या ALTO जैसे पुरानी अभिलेखीय मानकों को लक्षित नहीं करता।
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
सामने-सामने तुलना मैट्रिक्स
| क्षमता / फ़ॉर्मेट | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| मूल hOCR / ALTO XML | मूल समर्थन | केवल तृतीय‑पक्ष | कोई नहीं | कोई नहीं |
| बाउंडिंग बॉक्स ज्यामिति | अक्ष‑संरेखित (x, y, w, h) | 4‑बिंदु बहुभुज | 4‑बिंदु बहुभुज | बहुभुज + लेआउट ब्लॉक्स |
| टेबल पार्सिंग | केवल समन्वय TSV | HTML टेबल स्ट्रिंग्स | कोई नहीं | सेल समन्वय ग्रिड्स |
| रीडिंग ऑर्डर डिटेक्शन | नियम-आधारित (बहु-स्तंभ पर ब्रेक्स) | एमएल लेआउट विश्लेषण | बेसिक लाइन ग्रुपिंग | समर्पित पढ़ने-क्रम मॉडल |
| सीधे JSON स्कीमा | परिवर्तन की आवश्यकता है | Python डिक्शनरी / JSON | Python सूची / JSON | टाइप्ड Pydantic मॉडल |
| आदर्श डाउनस्ट्रीम लक्ष्य | आर्काइव PDF, लेगेसी DMS | फ़ॉर्म/रसीद डेटा, ईआरपीज़ | त्वरित स्क्रिप्ट्स, सीन टेक्स्ट | एलएलएम इनजेस्ट, आरएजी आर्किटेक्चर |
पाइपलाइन सिफ़ारिशें: आपको कौन सा चुनना चाहिए?
- Choose Tesseract यदि आपके अनुपालन आवश्यकताएँ मानकीकृत
hOCR,ALTO XML, या खोज योग्य PDF/A डिलिवरेबल्स की मांग करती हैं सरकारी या अभिलेखीय रिकॉर्ड्स के लिए। - Choose PaddleOCR यदि आप संचालनात्मक वित्तीय दस्तावेज़ (इनवॉइस, रसीदें, कर फ़ॉर्म) प्रोसेस कर रहे हैं जिनमें जटिल, बिना सीमा वाली तालिकाएँ हैं जिन्हें HTML या स्प्रेडशीट में बदलना आवश्यक है।
- Choose EasyOCR यदि आपको एक हल्का, पाइथनिक लाइब्रेरी चाहिए जो प्राकृतिक छवियों, सड़क संकेतों, या क्रॉप किए गए UI तत्वों से टेक्स्ट का पता लगा सके और निकाल सके, बिना कॉन्फ़िगरेशन झंझट के।
- Choose Surya OCR यदि आप असंरचित व्यावसायिक रिपोर्ट्स, शोध पत्र, और तकनीकी गाइड्स को एक एलएलएम या वेक्टर सर्च इंजन में फीड कर रहे हैं जहाँ तार्किक पढ़ने का क्रम और साफ़ संरचनात्मक सीमाएँ अत्यंत महत्वपूर्ण हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
1. कौन सा ओपन-सोर्स OCR आउटपुट फ़ॉर्मेट बड़े भाषा मॉडलों में फ़ीड करने में सबसे आसान है?
Surya OCR की रीडिंग-ऑर्डर-एवेयर JSON और PaddleOCR PP-Structure की HTML तालिकाएँ एलएलएम प्रॉम्प्ट संदर्भों और आरएजी इंडेक्सिंग के लिए सबसे साफ़ प्रतिनिधित्व प्रदान करती हैं।
2. क्या टेस्सरैक्ट बिना थर्ड-पार्टी टूल्स के मूल रूप से JSON प्रतिक्रियाएँ उत्पन्न कर सकता है?
नहीं, Tesseract मूल रूप से टेक्स्ट, TSV, PDF, और hOCR/ALTO XML आउटपुट करता है; JSON बनाने के लिए उसके TSV या hOCR आउटपुट को एक मध्यवर्ती पार्सर का उपयोग करके परिवर्तित करना आवश्यक है।
3. 4-बिंदु बहुभुज निर्देशांक अक्ष-समरेखित बाउंडिंग बॉक्स से कैसे भिन्न होते हैं?
एक्सिस-एलाइन्ड बॉक्स [x, y, width, height] का उपयोग करते हैं, मानते हुए कि टेक्स्ट सपाट है, जबकि 4-बिंदु बहुभुज चार निर्देशांक जोड़े प्रदान करते हैं ताकि घुमाए गए, तिरछे, या वक्र टेक्स्ट लाइनों को सटीक रूप से घेर सकें।
4. कौन सा इंजन तालिका संरचनाओं को ढीले निर्देशांक के बजाय सीधे कोड में आउटपुट करता है?
PaddleOCR के PP-Structure मॉड्यूल द्वारा पहचाने गए टेबल सीमाओं को पूर्ण HTML टेबल टैग्स (<table>, <tr>, <td>) में पुनर्निर्मित किया जाता है, जिससे कस्टम स्पेशियल गणना से बचा जा सके।
5. मानक EasyOCR आउटपुट मल्टी-कॉलम वैज्ञानिक पेपरों पर क्यों संघर्ष करता है?
EasyOCR स्थानीय निकटता के आधार पर टेक्स्ट लाइनों की पहचान करता है, न कि वैश्विक लेआउट पदानुक्रम पर, जिससे पड़ोसी कॉलमों का टेक्स्ट आपस में मिल जाता है जब तक कि इसे बाहरी लेआउट इंजन द्वारा सीमित न किया जाए।