अंतिम अपडेट: 20 Aug, 2026
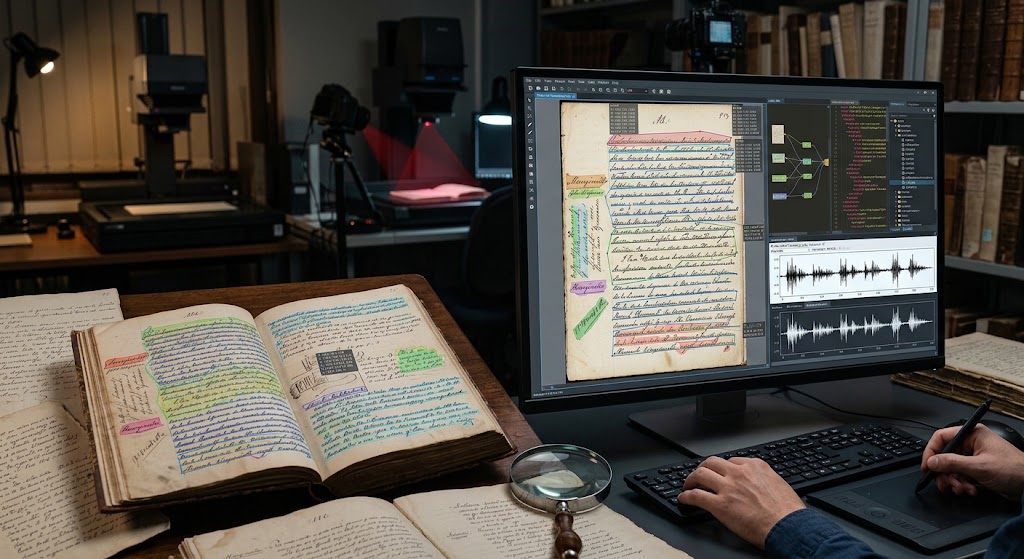
ऐतिहासिक और हस्तलिखित दस्तावेज़ों के लिए OCR फ़ाइल फ़ॉर्मेट
डिजिटलीकरण के माध्यम से सांस्कृतिक विरासत को संरक्षित करना एक पुनर्जागरण में प्रवेश कर चुका है। जबकि शुरुआती ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) सिस्टम को साफ़, मशीन-प्रिंटेड बीसवीं सदी के कागजात को पढ़ने के लिए डिज़ाइन किया गया था, आधुनिक सांस्कृतिक विरासत संस्थानों को एक बहुत ही जटिल और समृद्ध चुनौती का सामना करना पड़ रहा है: मध्ययुगीन पांडुलिपियाँ, उन्नीसवीं सदी की कर्सिव पत्राचार, नाज़ुक प्रकाशित पन्ने, और सदी पुरानी रजिस्टर।
ऐतिहासिक दस्तावेज़ों का प्रतिलेख अब केवल साधारण ASCII टेक्स्ट निकालने तक सीमित नहीं रहा। इसमें संदर्भ—पृष्ठ की भौतिक ज्यामिति, बेसलाइन वक्र, ब्लीड-थ्रू सुधार, मार्जिनलिया, संक्षेप, और पेलियोग्राफिक अनिश्चितता को कैप्चर करना आवश्यक है। यह विशिष्ट क्षेत्र, अक्सर Handwritten Text Recognition (HTR) के अंतर्गत वर्गीकृत किया जाता है, फ़ाइल फ़ॉर्मेट पर अत्यधिक निर्भर करता है जो इमेज कोऑर्डिनेट्स और टेक्स्ट लेयर्स दोनों को संग्रहीत और विनिमय करने के लिए उपयोग किया जाता है।
गलत स्कीमा चुनने से महत्वपूर्ण बेसलाइन डेटा हट सकता है, IIIF (International Image Interoperability Framework) मैनिफेस्ट्स के साथ संरेखण टूट सकता है, या दीर्घकालिक डिजिटल संरक्षण को रोक सकता है। यहाँ ऐतिहासिक दस्तावेज़ों के लिए प्रमुख OCR और HTR फ़ाइल फ़ॉर्मेट्स, उनके संरचनात्मक ताकतों, और आपके अभिलेखीय पाइपलाइन के लिए सही चयन कैसे निर्धारित करें, इस पर एक निश्चित मार्गदर्शिका प्रस्तुत है।
ऐतिहासिक दुविधा: क्यों सादा पाठ और मानक पीडीएफ विफल होते हैं
मशीन-प्रिंटेड OCR अक्सर सरल .txt फ़ाइलें या “सैंडविच” PDFs उत्पन्न करता है जिनमें स्कैन के नीचे छिपी टेक्स्ट लेयर्स होती हैं। ऐतिहासिक पांडुलिपियों और कर्सिव हस्तलेख के लिए, ये आउटपुट तीन मुख्य कारणों से विफल होते हैं:
- गैर-रेखीय पाठ और जटिल लेआउट: ऐतिहासिक लिपिकार साफ़ आयताकार ग्रिड्स का पालन नहीं करते थे। पाठ मार्जिन में बहता है, प्रकाशित प्रारंभिक अक्षरों के चारों ओर लिपटता है, डाली गई अंतःरेखीय सुधारों के बीच बुनता है, या रीढ़ के साथ लंबवत चलता है।
- वक्र और तिरछी बेसलाइन: कर्सिव लेखन शायद ही कभी कठोर क्षैतिज अक्ष का पालन करता है। ट्रांसक्रिबस, क्रेकेन और ईस्क्रिप्टोरियम जैसे HTR इंजन लिगेचर-भारी लिपियों की व्याख्या करने के लिए बाउंडिंग बॉक्स की बजाय पॉलीलाइन बेसलाइन पर निर्भर करते हैं।
- पैलियोग्राफी जटिलता और मेटाडेटा: अभिलेखीय अनुसंधान को संक्षेप, ऐतिहासिक वर्तनी विविधताएँ, क्षतिग्रस्त पठन, और पंक्ति-स्तर के विश्वास स्कोर को ट्रैक करने की आवश्यकता होती है। मानक दस्तावेज़ फ़ॉर्मेट इस सूक्ष्मता को त्याग देते हैं।
मूल कलाकृति की सच्चाई को बनाए रखने के लिए, अभिलेखीय समुदाय संरचित XML स्कीमा पर निर्भर करता है जो प्रतिलेखित पाठ के साथ लेआउट टोपोलॉजी को संरक्षित करने के लिए डिज़ाइन किए गए हैं।
1. PAGE XML: हस्तलिखित पाठ पहचान (HTR) के लिए स्वर्ण मानक
PRImA (पैटर्न रिकग्निशन & इमेज एनालिसिस) रिसर्च लैब द्वारा विकसित, PAGE XML (पेज एनालिसिस और ग्राउंडट्रुथ एलिमेंट्स) को हस्तलिखित पाठ पहचान और उन्नत लेआउट विश्लेषण के लिए अत्याधुनिक फ़ॉर्मेट माना जाता है।
मुख्य संरचना
PAGE XML भौतिक दस्तावेज़ को एक पदानुक्रमित संरचना के रूप में मानता है:
PcGts(रूट)Page(छवि आयाम और समग्र पढ़ने का क्रम)TextRegion(पैराग्राफ, शीर्षक, मार्जिन नोट्स, कैचवर्ड्स)TextLineCoords(लाइन के आसपास बहुभुज निर्देशांक)Baseline(स्क्रिप्ट की वास्तविक बेसलाइन का अनुसरण करने वाले बिंदुओं की श्रृंखला)TextEquiv(पहचाना गया पाठ, वैकल्पिक विश्वास मेट्रिक्स के साथ)
यह ऐतिहासिक पांडुलिपियों के लिए क्यों उत्कृष्ट है
- बहुभुज और पॉलीलाइन सटीकता: अक्षरों को आयताकार बाउंडिंग बॉक्स में मजबूर करने के बजाय, PAGE XML बहु-बिंदु बहुभुज सीमाओं और निरंतर बेसलाइन का उपयोग करता है। यह ओवरलैपिंग कर्सिव एस्केंडर और डिसेंडर को सेगमेंटेशन में बाधा डालने से रोकता है।
- सूक्ष्म संरचनात्मक प्रकार: क्षेत्रों को सटीक रूप से वर्गीकृत किया जा सकता है (उदा.,
marginalia,drop-capital,signature-mark,header,editorial-note). - व्यापक सॉफ़्टवेयर इकोसिस्टम: यह प्रमुख HTR प्लेटफ़ॉर्म जैसे Transkribus, eScriptorium, और Kraken के लिए मुख्य आंतरिक और निर्यात स्कीमा के रूप में कार्य करता है।
2. ALTO XML: पुस्तकालय और अभिलेखीय शक्ति केंद्र
ALTO (Analyzed Layout and Text Object) एक खुला XML मानक है जिसे लाइब्रेरी ऑफ़ कांग्रेस द्वारा बनाए रखा जाता है और यह राष्ट्रीय पुस्तकालयों द्वारा व्यापक रूप से अपनाया गया है, जिसमें Bibliothèque nationale de France (BnF) और ब्रिटिश लाइब्रेरी शामिल हैं।
मुख्य संरचना
ALTO लेआउट को階层िक रूप से Page से PrintSpace तक, फिर TextBlock, TextLine, और String (व्यक्तिगत शब्द या टोकन) तक संरचित करता है। इसे अक्सर METS (Metadata Encoding and Transmission Standard) रैपर के भीतर पैकेज किया जाता है ताकि संरचनात्मक मेटाडेटा को उच्च-रिज़ॉल्यूशन मास्टर इमेज़ के साथ जोड़ा जा सके।
मुख्य ताकतें और उपयोग के मामले
- मास डिजिटाइज़ेशन वर्कफ़्लोज़: ALTO को औद्योगिक-स्तर के समाचारपत्र और पुस्तक डिजिटाइज़ेशन को ध्यान में रखकर डिज़ाइन किया गया था। यह फ़ॉन्ट गुण, शब्द-स्तर निर्देशांक, अक्षर विश्वसनीयता, और खाली स्थानों को साफ़ तरीके से एन्कोड करता है।
- आधुनिक HTR समर्थन (ALTO 4): ALTO के पहले संस्करण आयताकार निर्देशांक (
HPOS,VPOS,WIDTH,HEIGHT) पर बहुत अधिक निर्भर थे। हालांकि, ALTO संस्करण 4 से शुरू होकर, स्कीमा ने<Shape>बहुभुज और पॉलीलाइन बेसलाइन पेश किए, जिससे हस्तलिखित सामग्री के लिए PAGE XML के साथ कार्यात्मक अंतर समाप्त हो गया। - दीर्घकालिक संरक्षण: क्योंकि यह अंतरराष्ट्रीय पुस्तकालय संघों द्वारा समर्थित एक आधिकारिक मानक है, ALTO दीर्घकालिक स्थिरता और अभिलेख-स्तर की बैकवर्ड संगतता की गारंटी देता है।
3. hOCR: वेब-फ़र्स्ट, हल्का मानक
थॉमस ब्रॉयर द्वारा निर्मित, hOCR एक व्यावहारिक दृष्टिकोण अपनाता है: पूरी तरह नया XML स्कीमा बनाने के बजाय, यह लेआउट और प्रतिलेख मेटाडेटा को सीधे सेमान्टिक HTML/XHTML में माइक्रोफ़ॉर्मेट्स और क्लास एट्रिब्यूट्स का उपयोग करके एम्बेड करता है।
सामान्य सिंटैक्स उदाहरण
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class=\"ocr_line\" id=\"line_1_1\" title=\"bbox 150 320 2200 410; baseline 0 -5\">\n        <span class=\"ocrx_word\" id=\"word_1_1\" title=\"bbox 150 325 380 405; x_wconf 92\">प्रारम्भ</span>\n      </span>
    </p>
  </div>
</div>
ऐतिहासिक सामग्री के फायदे और नुकसान
- फायदे: ब्राउज़र इसे मूल रूप से रेंडर कर सकते हैं। इसे वैनिला CSS और JavaScript का उपयोग करके आसानी से परिवर्तित किया जा सकता है, और यह Tesseract जैसे इंजन के लिए डिफ़ॉल्ट संरचित निर्यात फ़ॉर्मेट है।
- नुकसान: जटिल, मुक्त-रूप बहु-बिंदु बेसलाइन कर्व्स के लिए मूल समर्थन सीमित है। जबकि शुरुआती मुद्रित कार्यों (इन्कुना या साफ़ ब्रोडसाइड) के लिए व्यावहारिक है, hOCR असंगत पांडुलिपि लेआउट और बहु-परतीय मार्जिनलिया के साथ संघर्ष करता है।
4. TEI-XML: शैक्षणिक और डिजिटल मानविकी मानक
Text Encoding Initiative (TEI) फ़ॉर्मेट केवल OCR इंजन आउटपुट फ़ॉर्मेट नहीं है; बल्कि यह साहित्यिक और ऐतिहासिक ग्रंथों के आलोचनात्मक डिजिटल संस्करणों और विद्वतापूर्ण प्रतिनिधित्व के लिए प्रमुख मानक है।
OCR/HTR को TEI से जोड़ना
आधुनिक पाइपलाइनें शायद ही कच्ची अक्षर पहचान पर रुकती हैं। विद्वान Transkribus TEI Exporter जैसे उपकरणों या स्वचालित XSLT पाइपलाइन का उपयोग करके PAGE XML या ALTO फ़ाइलों को TEI-अनुरूप XML में परिवर्तित करते हैं:
- संक्षेपों का विस्तार किया जाता है (
<choice><abbr>...</abbr><expan>...</expan></choice>). - हटाव, जोड़ और लिपिक हाथों को औपचारिक रूप से वर्गीकृत किया जाता है (
<add>,<del>,<handShift>). - लेआउट डेटा को
<facsimile>और<surface>तत्वों के माध्यम से साहित्यिक विश्लेषण के साथ संरक्षित किया जाता है।
यदि आपका ऐतिहासिक प्रोजेक्ट एक इंटरैक्टिव आलोचनात्मक संस्करण या अर्थपूर्ण खोज योग्य विद्वतापूर्ण अभिलेख बनाने का लक्ष्य रखता है, तो आपके OCR/HTR डेटा को TEI-XML में परिवर्तित करना अक्सर आवश्यक अंतिम चरण होता है।
तुलनात्मक मैट्रिक्स: OCR/HTR स्वरूपों का एक नज़र में अवलोकन
| विशेषता / मानदंड | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| प्राथमिक डोमेन | हस्तलेख HTR & पांडुलिपियाँ | वृहद पुस्तकालय डिजिटलीकरण | वेब OCR & लाइट सर्च | शैक्षणिक आलोचनात्मक संस्करण |
| बेसलाइन समर्थन | स्थानीय, बहु-बिंदु बहुरेखाएँ | समर्थित (v4.0 से) | मूलभूत (ढाल/ऑफ़सेट) | फ़ैक्सिमाइल मैपिंग के माध्यम से |
| असामान्य बहुभुज | पूर्ण | पूर्ण | सीमित | निर्देशांक तत्वों के माध्यम से |
| उपकरण पारिस्थितिकी तंत्र | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, वेब व्यूअर्स | ऑक्सीजन, TEI पब्लिशर |
| मानकीकरण निकाय | PRImA समूह / ओपन | कांग्रेस पुस्तकालय | समुदाय विनिर्देशन | TEI कंसोर्टियम |
व्यावहारिक सिफ़ारिशें: अपनी अभिलेखीय पाइपलाइन चुनना
एक कुशल, भविष्य-प्रूफ डिजिटलीकरण पाइपलाइन स्थापित करने के लिए:
- शुद्ध हस्तलिखित पांडुलिपियों और अभिलेखों के लिए: अपनी प्रतिलिपि और लेआउट निष्कर्षण को PAGE XML पर मानकीकृत करें। इसका बेसलाइन गणना और बहुभुज कंटूरिंग गैर-मानक लेखन शैलियों को न्यूनतम डेटा हानि के साथ संभालता है।
- बड़े पैमाने की लाइब्रेरी और मिश्रित संग्रहों के लिए: ALTO XML (v4.2 या उससे ऊपर) को METS के साथ चुनें। यह मानक डिजिटल रिपॉजिटरी आर्किटेक्चर और डिजिटल एसेट मैनेजमेंट सिस्टम (DAMS) में सहज एकीकरण सुनिश्चित करता है।
- वेब प्रस्तुति और पूर्ण-पाठ खोज सूचकांकों के लिए: इंटरैक्टिव IIIF व्यूअर्स (जैसे Mirador या Universal Viewer) को लाइव इन-ब्राउज़र टेक्स्ट ओवरले के साथ चलाने के लिए hOCR का उपयोग करें या PAGE XML से हल्की GeoJSON/Web Annotation संरचनाएँ निकालें।
- शैक्षणिक संस्करणों और पेलियोग्राफिक अनुसंधान के लिए: PAGE XML में अपना ग्राउंड ट्रुथ उत्पन्न करें, पहचान करें, और आउटपुट को एक स्वचालित कनवर्टर के माध्यम से पाइप करके संपादकीय मार्कअप के लिए TEI-XML उत्पन्न करें।
इन स्वरूपों की संरचनात्मक क्षमताओं को आपके स्रोत सामग्री की पेलियोग्राफिक आवश्यकताओं से मिलाकर, आप सुनिश्चित करते हैं कि प्रत्येक स्ट्रोक, संक्षेप, और ऐतिहासिक बारीकियाँ आने वाले सदियों तक समझी जा सकें।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
Q1. मानक OCR और HTR के बीच मूलभूत अंतर क्या है? OCR लगातार मशीन-प्रिंटेड टाइपोग्राफी को पहचानता है, जबकि HTR (हैंडरिटेन टेक्स्ट रिकग्निशन) निरंतर, परिवर्तनीय मानव हस्तलेख और वक्र बेसलाइन को डिकोड करने के लिए गहरी न्यूरल नेटवर्क का उपयोग करता है।
Q2. क्या Tesseract OCR ऐतिहासिक दस्तावेज़ों के लिए PAGE XML या ALTO आउटपुट उत्पन्न कर सकता है? हाँ, Tesseract मूल ALTO XML और hOCR आउटपुट बना सकता है, और तृतीय-पक्ष रैपर्स इन परिणामों को PAGE XML में परिवर्तित कर सकते हैं।
Q3. हस्तलेखित पाठ प्रतिलेखन में बाउंडिंग बॉक्स की तुलना में बेसलाइन अधिक महत्वपूर्ण क्यों हैं? बेसलाइन मानव लेखन की प्राकृतिक, लहरदार रेखा को ट्रैक करती हैं, जिससे सॉफ़्टवेयर को कठोर बाउंडिंग बॉक्स के भीतर टकराने वाले ओवरलैपिंग एस्केंडर्स और डिसेंडर्स को अलग करने की सुविधा मिलती है।
Q4. IIIF मानक इन OCR फ़ाइल स्वरूपों के साथ कैसे इंटरैक्ट करता है? IIIF उच्च-रिज़ॉल्यूशन छवियों को खुले वेब API के माध्यम से प्रदान करता है, जबकि ALTO या PAGE XML जैसे स्वरूप समन्वय डेटा प्रदान करते हैं जिन्हें IIIF कंटेंट सर्च एनोटेशन में परिवर्तित किया जा सकता है।
Q5. कौन सा फ़ाइल स्वरूप सीधे एक सर्चेबल PDF में बदलना सबसे आसान है? दोनों hOCR और ALTO XML को मूल पृष्ठ छवियों के साथ जोड़ा जा सकता है ताकि OCRmyPDF जैसे टूल्स का उपयोग करके सर्चेबल ड्यूल-लेयर PDF फ़ाइलें बनाई जा सकें।