अंतिम अपडेट: 30 Sept, 2026
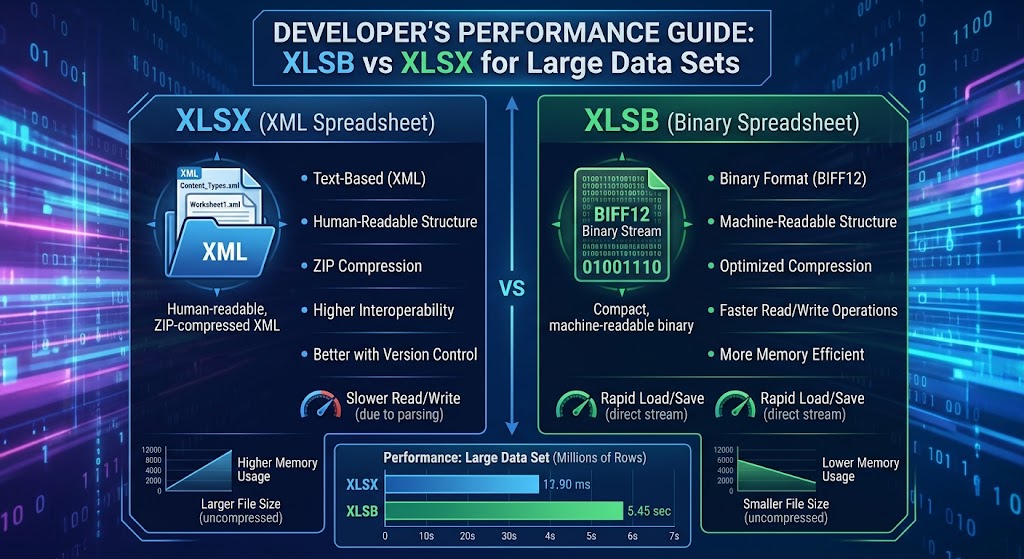
बड़े डेटा सेटों के लिए XLSB बनाम XLSX: एक डेवलपर का प्रदर्शन गाइड
यदि आप डेटा पाइपलाइन, बैकएंड रिपोर्टिंग इंजन, या विश्लेषण टूल बनाते हैं जो Microsoft Excel के साथ इंटरफ़ेस करते हैं, तो आप संभवतः "दीवार" से टकरा चुके होंगे।
एक उपयोगकर्ता 450,000-पंक्तियों वाली वर्कबुक अपलोड करता है। आपका सर्वर वर्कर थ्रेड्स शुरू करता है, मेमोरी उपयोग गीगाबाइट्स में बढ़ जाता है, गार्बेज कलेक्शन रनटाइम को फ्रीज़ कर देता है, और आपका निष्पादन टाइमआउट हो जाता है। आप पेलोड की जांच करते हैं: यह एक मानक .xlsx फ़ाइल है।
इसे हल करने के लिए, डेवलपर्स अक्सर चंकिंग, स्ट्रीमिंग पार्सर लागू करने या फ़ाइलों को बैकग्राउंड वर्कर्स में ऑफलोड करने में कई दिन खर्च करते हैं। फिर भी, सबसे प्रभावी अनुकूलनों में से एक को किसी भी वास्तुशिल्प पुनःडिज़ाइन की आवश्यकता नहीं होती: फ़ाइल एक्सटेंशन को .xlsx से .xlsb में बदलना।
इस गाइड में, हम दोनों फ़ॉर्मैट्स के अंदर झाँकते हैं, यह जांचते हैं कि उनके आंतरिक आर्किटेक्चर क्यों अत्यधिक अलग प्रदर्शन विशेषताएँ उत्पन्न करते हैं, Python और .NET में ठोस बेंचमार्क की तुलना करते हैं, और उत्पादन में बाइनरी वर्कबुक्स को कब डिप्लॉय करना है, इसके स्पष्ट नियमों की रूपरेखा प्रस्तुत करते हैं।
1. पर्दे के पीछे: OpenXML बनाम BIFF12
यह समझने के लिए कि बड़े डेटासेट्स पर प्रदर्शन इतना नाटकीय रूप से क्यों अलग होता है, हमें देखना होगा कि प्रत्येक फ़ॉर्मेट डिस्क पर रिकॉर्ड्स को कैसे संग्रहीत करता है।
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
दोनों .xlsx और .xlsb फ़ाइलें संकुचित ZIP कंटेनर हैं जो Open Packaging Conventions (OPC) का पालन करती हैं। यदि आप किसी भी फ़ाइल का नाम .zip रखकर उसे निकालते हैं, तो आपको एक परिचित डायरेक्टरी लेआउट दिखाई देगा: _rels, docProps, और xl/worksheets/।
महत्वपूर्ण अंतर xl/worksheets/ फ़ोल्डर के भीतर स्थित है:
- XLSX शीट्स को साधारण XML टेक्स्ट (
sheet1.xml) के रूप में संग्रहीत करता है। - XLSB शीट्स को स्वामित्व बाइनरी स्ट्रीम (
sheet1.bin) के रूप में संग्रहीत करता है, जो Microsoft के BIFF12 (Binary Interchange File Format 12) का उपयोग करके एन्कोड किया गया है।
कैसे XLSX डेटा एन्कोड करता है (XML DOM ओवरहेड)
एक XLSX वर्कशीट में, प्रत्येक सेल को स्पष्ट XML टैग्स के साथ घोषित किया जाता है:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
इस पंक्ति को पढ़ते समय, आपके रनटाइम को करना चाहिए:
- कच्ची डिफ्लेट स्ट्रीम को टेक्स्ट में डीकम्प्रेस करें।
- स्ट्रिंग अक्षरों को टोकनाइज़ करके XML DOM या SAX इवेंट स्ट्रीम में पार्स करें।
- खुलने और बंद होने वाले टैग्स को सत्यापित करें (
<c>,</c>,<v>,</v>). - एक अलग
sharedStrings.xmlतालिका से स्ट्रिंग लुकअप को हल करें। - ASCII टेक्स्ट
"98234.55"को IEEE 754 64-बिट फ्लोटिंग-पॉइंट संख्या में पार्स करें।
प्रत्येक सेल स्ट्रिंग पार्सिंग, स्ट्रिंग आवंटन और लेक्सिकल विश्लेषण के लिए CPU ओवरहेड उत्पन्न करता है। इसे 500,000 पंक्तियों और 30 कॉलम (15 मिलियन सेल) में गुणा करें, और CPU सिंटैक्स पार्स करने में डोमेन मानों को प्रोसेस करने की तुलना में बहुत अधिक साइकिल खर्च करता है।
कैसे XLSB डेटा एन्कोड करता है (BIFF12 बाइनरी स्ट्रीम)
BIFF12 पूरी तरह से टेक्स्ट सीरियलाइज़ेशन को त्याग देता है। स्ट्रिंग मार्कअप के बजाय, डेटा को वैरिएबल-लेंथ बाइनरी रिकॉर्ड्स की क्रमिक श्रृंखला के रूप में व्यवस्थित किया जाता है:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12 में एक फ्लोटिंग-पॉइंट सेल "98234.55" जैसी स्ट्रिंग प्रतिनिधित्व का उपयोग नहीं करता। इसे सीधे दर्शाया जाता है:
- रिकॉर्ड ID के लिए 2 बाइट्स (उदा.,
BrtCellRkयाBrtCellReal) - कॉलम/रो इंडेक्स के लिए 4 बाइट्स
- 8 बाइट्स जिसमें कच्चा, IEEE 754 डबल-प्रिसीजन बाइट संरचना शामिल है
जब आपका पार्सर एक XLSB फ़ाइल पढ़ता है, तो यह लेक्सिकल पार्सिंग को पूरी तरह बायपास कर देता है। यह रिकॉर्ड हेडर पढ़ता है, बफ़र से 8 कच्चे बाइट्स लेता है, उन्हें सीधे मेमोरी में कॉपी करता है, और पॉइंटर को आगे बढ़ाता है। वैधता के लिए कोई टैग नहीं होते, स्ट्रिंग-से-नंबर प्रकार रूपांतरण नहीं होते, और संख्यात्मक डेटा के लिए UTF-8 डिकोडिंग ओवरहेड शून्य होता है।
2. मात्रात्मक बेंचमार्क: डिस्क, मेमोरी, और थ्रूपुट
वास्तविक प्रभाव को दर्शाने के लिए, एक सिम्युलेटेड डेटासेट पर विचार करें जिसमें 750,000 पंक्तियाँ और 25 कॉलम (टाइमस्टैम्प, फ्लोटिंग-पॉइंट नंबर, पूर्णांक, और श्रेणी कोड का मिश्रण) शामिल हैं।
नीचे दिए गए परीक्षण समान तालिकीय डेटा का मूल्यांकन करते हैं जो दोनों XLSX और XLSB के रूप में सहेजा गया है।
परीक्षण वातावरण
- CPU: AMD Ryzen 9 5900X (12 कोर, 24 थ्रेड्स)
- RAM: 64 GB DDR4-3600
- स्टोरेज: PCIe 4.0 NVMe SSD
- रनटाइम: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
मुख्य प्रदर्शन मीट्रिक
| मेट्रिक | XLSX (OpenXML) | XLSB (BIFF12) | डेल्टा / सुधार |
|---|---|---|---|
| डिस्क पर फ़ाइल आकार | 128.4 MB | 68.2 MB | ~47% छोटा |
| सेव / सीरियलाइज़ेशन समय | 42.6 s | 14.1 s | 3.0x तेज़ |
| पढ़ने का समय (Python DOM parser) | 38.2 s | 8.9 s | 4.3x तेज़ |
| पढ़ने का समय (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x तेज़ |
| पढ़ने के दौरान अधिकतम हीप आवंटन | ~1.85 GB | ~510 MB | ~72% कमी |
XLSB फ़ाइलें क्यों छोटी होती हैं
जबकि दोनों फ़ॉर्मेट मानक ZIP संपीड़न का उपयोग करते हैं, बाइनरी स्ट्रीम्स बड़बड़ाते XML टेक्स्ट की तुलना में बहुत अधिक कुशलता से संपीड़ित होते हैं:
- अधिकांश दोहराव वाला सिंटैक्स हटाया गया: XML प्रत्येक रिकॉर्ड पर दोहराव वाले टैग (
<c r="AA1" s="1">) रखता है। जबकि ZIP संपीड़न दोहराए गए स्ट्रिंग्स को कम करता है, अनकम्प्रेस्ड डेटा स्ट्रीम बहुत बड़ी होती है। - संख्यात्मक घनत्व: XML में, संख्या
12345678.9012को 14 बाइट ASCII टेक्स्ट की आवश्यकता होती है। BIFF12 में, इसे 8-बाइट डबल के रूप में संग्रहीत किया जाता है (या यदि यह विशिष्ट सटीकता नियमों में फिट होता है तो 4-बाइटRKरिकॉर्ड में पैक किया जाता है)।
3. मेमोरी फुटप्रिंट और गार्बेज कलेक्शन दबाव
वेब सेवाओं और माइक्रोसर्विसेज़ के लिए जो समवर्ती अनुरोधों को संभालते हैं, CPU गति केवल आधा संघर्ष है; मेमोरी फुटप्रिंट वह जगह है जहाँ एप्लिकेशन वास्तव में विफल होते हैं।
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
जब एक XML पार्सर 100 MB XLSX फ़ाइल को प्रोसेस करता है, तो उसे हजारों अस्थायी स्ट्रिंग टोकन, स्ट्रिंग स्लाइस बफ़र, और शब्दकोश लुकअप बनाना पड़ता है। गार्बेज-कलेक्टेड भाषाओं (Java, C#, Go, Node.js, Python) में, यह अत्यधिक हीप फ्रैगमेंटेशन पैदा करता है और रनटाइम को बार-बार गैरेज कलेक्शन (GC) पॉज़ में धकेलता है।
क्योंकि XLSB पार्सिंग सीधे फिक्स्ड-विड्थ बाइट स्लाइस पर काम करती है, पार्सर डेटा को स्टैक-एलोकेटेड स्ट्रक्चर या पुन: उपयोग योग्य बाइट बफ़र में पढ़ सकते हैं। परिणामस्वरूप मेमोरी फुटप्रिंट में नाटकीय रूप से कमी आती है और रनटाइम एलोकेटर का कोई थ्रैशिंग नहीं होता।
4. डेवलपर कार्यान्वयन उदाहरण
आइए देखें कि सामान्य डेवलपर टूलचेन में XLSB का उपयोग कैसे किया जा सकता है।
Python: OpenPyXL से Calamine / PyXLSB में माइग्रेट करना
मानक pandas.read_excel('data.xlsx') डिफ़ॉल्ट रूप से openpyxl का उपयोग करता है, जो एक भारी इन‑मेमोरी ट्री बनाता है।
बड़ी XLSB फ़ाइलों को अधिकतम गति से प्रोसेस करने के लिए, Rust‑पावर्ड calamine इंजन का उपयोग करें (जो python-calamine के माध्यम से उपलब्ध है और आधुनिक Pandas में एकीकृत है):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
यदि आप पूरे मैट्रिक्स को DataFrame में लोड किए बिना पंक्ति‑दर‑पंक्ति बड़े डेटासेट पर इटरेट कर रहे हैं, तो pyxlsb एक हल्का स्ट्रीमिंग इटररेटर प्रदान करता है:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: उच्च-प्रदर्शन स्ट्रीम इन्जेस्टशन
.NET में, ClosedXML या EPPlus जैसी लाइब्रेरीज़ मानक जेनरेशन के लिए उत्कृष्ट हैं, लेकिन बड़ी फ़ाइलों को मेमोरी समाप्ति के बिना इन्जेस्ट करने के लिए, XLSB समर्थन वाला ExcelDataReader अत्यंत तेज़ है:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. वास्तुशिल्पीय समझौते: XLSB का उपयोग कब नहीं करना चाहिए
अपनी अभूतपूर्व प्रदर्शन लाभों के बावजूद, XLSB कोई जादुई समाधान नहीं है। इसे अपने स्टैक में लागू करने से पहले आपको कई ऑपरेशनल ट्रेड‑ऑफ़ को तौलना चाहिए:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. इकोसिस्टम और लाइब्रेरी समर्थन
- XLSX: सार्वभौमिक। लगभग हर भाषा, लाइब्रेरी, SaaS टूल (Google Sheets, Airtable, Tableau), और वेब पार्सर मूल रूप से OpenXML का समर्थन करते हैं।
- XLSB: कम व्यापक। जबकि Excel, LibreOffice, और परिपक्व डेवलपर लाइब्रेरीज़ (
ExcelDataReader,pyxlsb,calamine,Aspose) इसका समर्थन करती हैं, कई हल्के पैकेज या शुद्ध वेब-आधारित जावास्क्रिप्ट पार्सर (जैसेSheetJSके पुराने संस्करण) सीमित या केवल-रीड समर्थन रखते हैं।
2. Git और संस्करण नियंत्रण अंतर तुलना
- XLSX: क्योंकि यह ZIP कंटेनर के भीतर टेक्स्ट XML रखता है, कमांड-लाइन यूटिलिटीज़ और Git हुक्स इसे अनज़िप करके XML को फॉर्मेट कर सकते हैं, जिससे कमिट्स के बीच पढ़ने योग्य संरचनात्मक अंतर उत्पन्न होते हैं।
- XLSB: शुद्ध बाइनरी डेटा। संस्करण नियंत्रण प्रणालियाँ इसे सख्ती से एक अस्पष्ट बाइनरी ब्लॉब के रूप में मानती हैं, जिससे सूक्ष्म अंतर या लाइन-स्तर मर्ज की कोई संभावना समाप्त हो जाती है।
3. वेब क्लाइंट रेंडरिंग
यदि आपका आर्किटेक्चर WebAssembly या क्लाइंट-साइड जावास्क्रिप्ट के माध्यम से ब्राउज़र में सीधे स्प्रेडशीट रेंडर करने पर निर्भर करता है, तो XLSX पार्सर काफी अधिक परिपक्व हैं और क्लाइंट-साइड बाइनरी पार्सरों की तुलना में किनारी-केस रेंडरिंग बग्स के प्रति कम प्रवण होते हैं।
4. तृतीय‑पक्ष इन्जेस्टशन पाइपलाइन
यदि आप बाहरी एंटरप्राइज़ क्लाइंट्स के लिए फ़ाइलें निर्यात कर रहे हैं, तो कई सख्त कॉर्पोरेट सुरक्षा नीतियां .xlsb फ़ाइलों को फ़्लैग करती हैं। क्योंकि BIFF12 फ़ाइलें VBA मैक्रो को .xlsm फ़ाइलों की तरह ही संग्रहीत कर सकती हैं (अलग एक्सटेंशन की आवश्यकता नहीं होती), कुछ मेल फ़िल्टर और फ़ायरवॉल स्कैनर .xlsb अपलोड को संभावित मैक्रो-धारीत खतरे के रूप में क्वारंटाइन कर देते हैं।
6. सारांश तुलना: कौन सा फ़ॉर्मेट जीतता है?
| विशेषता | XLSX | XLSB | विजेता |
|---|---|---|---|
| पढ़ने / पार्स गति | मध्यम से खराब | बहुत तेज़ | XLSB |
| लेखन / जनरेशन गति | CPU-गहन | तेज़ | XLSB |
| फ़ाइल संपीड़न | अच्छा | उत्कृष्ट (~40-50% छोटा) | XLSB |
| मेमोरी आवंटन | उच्च (भारी GC दबाव) | निम्न (सीधा बाइट पढ़ना) | XLSB |
| टूलिंग इंटरऑपरेबिलिटी | सार्वभौमिक | उच्च, लेकिन चयनात्मक | XLSX |
| सुरक्षा स्कैनिंग घर्षण | न्यूनतम | कभी-कभी गलत सकारात्मक | XLSX |
| मैक्रो क्षमता | नहीं (.xlsm आवश्यक) | हाँ (मैक्रोज़ को मूल रूप से समर्थन करता है) | टाई |
7. डेवलपर का निर्णय
जब XLSX का उपयोग करें:
- फ़ाइलें आकार में छोटी से मध्यम हैं (< 50,000 पंक्तियाँ).
- आपकी फ़ाइलें तृतीय‑पक्ष SaaS प्लेटफ़ॉर्म या उपभोक्ता ऐप्स द्वारा ग्रहण की जानी चाहिए (उदा., Google Sheets).
- आप फ़ाइल पढ़ने वाले अंतिम क्लाइंट के वातावरण को नियंत्रित नहीं कर सकते.
जब XLSB पर स्विच करें:
- आप आंतरिक पाइपलाइन, बैच जॉब्स, ETL सिस्टम, या वर्कर टास्क बना रहे हैं जो बड़े डेटा निष्कर्षण (> 100,000 पंक्तियाँ) को संभालते हैं.
- आपके सर्वर स्प्रेडशीट सीरियलाइज़ेशन या डीसीरियलाइज़ेशन के दौरान आउट-ऑफ़-मैमोरी (OOM) त्रुटियों का सामना कर रहे हैं।
- आपको बड़े आवर्ती वित्तीय मॉडल या डेटा निर्यात के लिए S3/blob स्टोरेज फुटप्रिंट और नेटवर्क ट्रांज़िट समय को न्यूनतम करना चाहिए।
XLSB में स्विच करना अक्सर आपके निर्यात सेवा में एक कॉन्फ़िगरेशन स्ट्रिंग बदलने जितना सरल होता है, फिर भी यह 3x to 5x थ्रूपुट वृद्धि प्रदान करता है, जो सामान्यतः कोड अनुकूलन के कई हफ्तों की आवश्यकता होती है।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
**Q1: क्या एक XLSB फ़ाइल वही सटीक पंक्तियों और स्तंभ सीमाओं को समर्थन देती है जो एक XLSX फ़ाइल में होती हैं? हाँ; दोनों XLSB और XLSX समान ग्रिड सीमा 1,048,576 पंक्तियों और 16,384 स्तंभों प्रति वर्कशीट साझा करते हैं।
**Q2: क्या एक XLSB फ़ाइल अपने फ़ाइल एक्सटेंशन को बदले बिना VBA मैक्रो को सुरक्षित रूप से संग्रहीत कर सकती है?
हाँ, XLSX के विपरीत (जिसके लिए कोड चलाने हेतु XLSM के रूप में सहेजना आवश्यक है), XLSB बाइनरी VBA मैक्रो स्टोरेज को मूल रूप से उसी .xlsb फ़ाइल फ़ॉर्मेट के भीतर समर्थन करता है।
**Q3: यदि दोनों फ़ॉर्मेट पहले से ही ZIP संपीड़ित हैं, तो फ़ाइल को XLSB के रूप में सहेजने से उसका आकार क्यों घट जाता है? XLSB विस्तृत टेक्स्ट मार्कअप टैग्स को समाप्त करता है और सेल स्थितियों, रिकॉर्ड्स, तथा कच्चे संख्यात्मक मानों को सघन बाइनरी बाइट स्ट्रीम में एन्कोड करता है, जो साधारण XML स्ट्रिंग्स की तुलना में बहुत अधिक घनीभूत रूप से संकुचित होते हैं।
**Q4: क्या Google Sheets सीधे XLSB फ़ाइलें आयात और संपादित कर सकता है?
नहीं; Google Sheets मूल रूप से .xlsb फ़ाइलों को सीधे खोल या परिवर्तित नहीं कर सकता, इसलिए आपको उन्हें आयात करने से पहले .xlsx या CSV में बदलना पड़ता है।
**Q5: क्या XLSB फ़ाइलें XLSX फ़ाइलों की तुलना में डेटा भ्रष्टाचार के प्रति अधिक संवेदनशील हैं? जब XML फ़ाइलें आंशिक रूप से भ्रष्ट हों तो उन्हें कभी‑कभी टेक्स्ट एडिटर से मैन्युअल रूप से जांचा या ठीक किया जा सकता है, लेकिन बाइनरी BIFF12 स्ट्रीम्स को सख्त बाइट ऑफ़सेट की आवश्यकता होती है और यदि संरचनात्मक सेक्टर क्षतिग्रस्त हों तो उन्हें मैन्युअल रूप से पुनर्प्राप्त करना कठिन होता है।