Legutóbb frissítve: 2026. aug. 20.
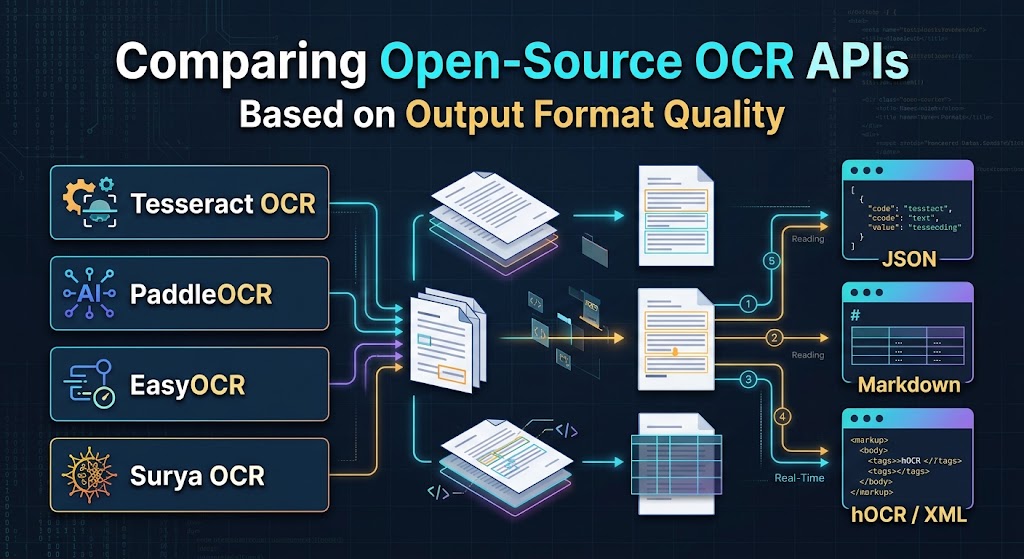
Open-Source OCR API-k összehasonlítása a kimeneti formátum minősége alapján
Amikor a mérnökök az Optikai Karakterfelismerő (OCR) motorokat értékelik, a karakterhibaarány (CER) és a szavakhibaarány (WER) általában uralják a mérőszámokat. Bár a felismerési pontosság elengedhetetlen, csak a feladat felét oldja meg a gyártásban.
Ha összetett többoszlopos PDF-eket dolgozol fel, számlákról vonal tételeket nyersz ki, vagy fehér könyveket viszel be egy LLM beágyazási csővezetékbe, a nyers szövegkiíratások hatalmas mérnöki terhet jelentenek. A karakterlánc elrendezésérzékelés, logikai olvasási sorrend vagy koordinátaadatok nélkül arra kényszeríti a csapatodat, hogy törékeny heurisztikus elemzőket írjon.
Az igazi megkülönböztető a modern dokumentumáramlásoknál a kimeneti formátum minősége: hogy a motor mennyire következetesen és tisztán adja át a koordinátákat, az olvasási sorrendet, a struktúra hierarchiáját és a táblázati adatokat.
Az alábbiakban egy mérnöki szempontú összehasonlítás látható négy vezető nyílt forráskódú OCR motorról — Tesseract, PaddleOCR, EasyOCR, és Surya OCR — amely értékeli, hogy kimeneteik hogyan viselkednek az automatizált csővezetékekben.
A gyakori kimeneti formátumok: Amit a mérnökök valójában igényelnek
Minden OCR API másképp csomagolja a felismert szöveget. Ezen formátumok megértése segít meghatározni, mennyi utófeldolgozásra van szükség a csővezetékben:
- Plain Text (
.txt): A legegyszerűbb ábrázolás. Eltávolítja az összes pozíciós metaadatot, és a többoszlopos elrendezéseket vízszintes olvasássá fűzi össze, ami összekuszálhatja a bekezdéseket. - Archival Standards (
hOCR,ALTO XML): XML/HTML-alapú formátumok, amelyek szabványosak a könyvtári archiválásban. Koordinátákat, betűtípus becsléseket és megbízhatósági értékeléseket ágyaznak be a DOM csomópontokba. Rendkívül robusztus a dokumentumújraépítéshez, de nehézkes a mikroszolgáltatások számára. - Structured JSON: Az alapértelmezett választás a modern web háttérrendszerekhez. Koordináta tömböket (keretdobozokat vagy poligonokat), megbízhatósági értékeléseket és hierarchikus blokk/sor/szó struktúrákat biztosít.
- Markdown (
.md) / HTML Tables: A modern szabvány a Retrieval-Augmented Generation (RAG) számára. Megőrzi a szemantikus szekciókat (fejlécek, listák, félkövér szöveg) és a táblázatos mátrixokat anélkül, hogy lejjebb folyó térbeli újraépítést igényelne.
1. Tesseract OCR
A Google által karbantartott Tesseract továbbra is az nyílt forráskódú OCR alapvető munkagépe. Architektúrája erősen támaszkodik a hagyományos oldal-szegmentációs algoritmusokra, amelyeket egy LSTM-alapú karaktermotor egészít ki.
Natív kimeneti formátumok
- Elsődleges kimenetek: Egyszerű szöveg, hOCR (HTML), ALTO XML, TSV (Tabulált értékek), és kereshető PDF/A.
- Elrendezés-érzékelés: Szabályalapú heurisztikák a Page Segmentation Modes (PSM) segítségével.
Kimeneti formátum elemzése
- Ahol kiemelkedik: A Tesseract
TSVéshOCRexportjai szabványosak és kiszámíthatóak. Egyetlen TSV export strukturált oszlopokat ad vissza alevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightésconfszámára. Ha papírarchívumokat kereshető PDF-ekre konvertálsz, vagy szigorú intézményi szabványok betartására van szükséged, a Tesseract ezt natívan kezeli egyedi összekötő kód nélkül. - Ahol hiányosságai vannak: A Tesseract nem rendelkezik natív JSON API-val. Kimenetének felhasználása Pythonban vagy Node.js-ben XML/TSV fájlok elemzését vagy olyan csomagok, mint a
pytesseract, használatát igényli. Az elrendezés-motorja szintén nehezen kezeli a nem szabványos oszlopos áramlást, gyakran keveri a szomszédos oszlopok szövegét, hacsak nem biztosítanak manuális körülhatároló vágásokat.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
A Baidu PaddlePaddle keretrendszerével támogatott PaddleOCR széles körű elterjedést ért el könnyű modelljei, kiterjedt többnyelvű lefedettsége és dedikált dokumentumelemző eszközkészlete (PP-Structure) miatt.
Natív kimeneti formátumok
- Elsődleges kimenetek: Python listák/szótárak, nyers JSON, vizualizációs átfedések, és strukturált HTML a PP-Structure segítségével.
- Elrendezés-érzékelés: Magas (mélytanuló modellek használatával az elrendezés elemzéséhez, orientáció osztályozásához és táblázat helyreállításhoz).
Kimeneti formátum elemzése
- Ahol kiemelkedik: A standard PaddleOCR 4 pontból álló sokszög koordinátákat (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) ad vissza a szöveges karakterláncokkal és a megbízhatósági pontszámokkal együtt. Ez könnyedén kezeli a ferde vagy ívelt szöveget. Azonban valódi ereje a PP-Structure csomagban rejlik, amely felismeri az elrendezési területeket (cím, szöveg, táblázat, ábra) és a táblázatokat közvetlenül érvényes HTML karakterláncokká (<table>...</table>) alakítja. Ez megszünteti a cella átfedések kézi számításának szükségességét a határoló dobozokból. - Ahol hiányosságai vannak: Az alap API beágyazott tömböket ad vissza, amelyek különböző verziókban nem rendelkeznek szabványos tulajdonságkulcsokkal. Strukturált alkalmazások esetén a fejlesztők általában egy köztes adaptert írnak a mezőnevek (
bbox,text,confidence) szabványosításához.
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
A PyTorch-ra építve a JaibleAI által, az EasyOCR gyors fejlesztői elfogadást céloz meg. A CRAFT (Character Region Awareness for Text Detection) és a mélytanuló felismerő hálózatokat egy minimális API-ba csomagolja.
Natív kimeneti formátumok
- Elsődleges kimenetek: Python listák, amelyek koordinátákat, felismert karakterláncokat és bizalmi értékeket tartalmazó tuple-öket tartalmaznak.
- Elrendezés-érzékelés: Alacsony-tól közepes szintű (csak szövegsor-észlelés; nincs dokumentumszintű struktúra elemzés).
Kimeneti formátum elemzése
- Ahol kiemelkedik: A visszatérő objektum egyszerűsége páratlan:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Ennek a kimenetnek a leképezése egy szabványos REST válaszra vagy közvetlenül GeoJSON/egyedi sémákba történő sorosítása csak néhány kódsort igényel. Megbízhatóan működik természetes jelenet szövegeken, rendszámokon és elkülönített dokumentumkivágásokon.
- Ahol elmarad: Az EasyOCR nem végez holisztikus dokumentumelrendezés-elemzést. Nem azonosít táblázatokat, címsor-hierarchiákat vagy olvasási sorrendeket összetett oszlopokban. Az EasyOCR kétoszlopos tudományos dolgozaton való használata gyakran összefonódott szövegrészleteket eredményez, hacsak nem párosítják egy előzetes elrendezés-észlelő modellel (például YOLO vagy LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya egy modern mélytanulásos OCR keretrendszer, amely kifejezetten összetett dokumentumértéshez és LLM betáplálási csővezetékekhez lett tervezve.
Natív kimeneti formátumok
- Elsődleges kimenetek: Pydantic-modellű JSON struktúrák, logikai olvasási sorrend indexek, elrendezés-körülhatároló régiók és sor-észlelési poligonok.
- Elrendezésérzékelés: Kivételesen magas (mélytanuláson alapuló elrendezés-elemzés és olvasási sorrend rendezés).
Kimeneti formátum elemzése
- Ahol kiemelkedik: A Surya közvetlenül a modern AI mérnöki kihívásokat célozza meg. Ahelyett, hogy azt feltételezné, hogy a dokumentumok felülről lefelé, balról jobbra olvasódnak, a Surya egy dedikált modellt használ a olvasási sorrend előrejelzésére. A sorokat logikai szemantikai blokkokba csoportosítja, természetesen kezeli a többoszlopos kiterjedéseket, és a Pydantic segítségével típusos struktúrákat ad ki. Ez lehetővé teszi, hogy a vektoradatbázisokba és a Markdown konvertálókba történő további beolvasás közvetlen és megbízható legyen.
- Ahol hiányosságai vannak: Mivel egy újabb, nehezebb, PyTorch-alapú keretrendszer, a Surya dedikált GPU számítási kapacitást igényel, hogy elérje a Tesseract-hez vagy a kvantált Paddle modellekhez hasonló optimalizált C++ motorok áteresztőképességét. Nem célozza meg a régi archiválási szabványokat, mint például a hOCR vagy az ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Fej-fej összehasonlítási mátrix
| Képesség / Formátum | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Natív hOCR / ALTO XML | Natív támogatás | Csak harmadik fél | Nincs | Nincs |
| Keretdoboz geometria | Tengelyhez igazított (x, y, w, h) | 4 pontú sokszög | 4 pontú sokszög | Sokszög + elrendezési blokkok |
| Táblázat feldolgozás | Csak koordináta TSV | HTML táblázat karakterláncok | Nincs | Cellakoordináta rácsok |
| Olvasási sorrend felismerés | Szabályalapú (törés többoszlopos esetén) | ML elrendezés elemzés | Alapvető sorcsoportosítás | Dedikált olvasási sorrend modell |
| Közvetlen JSON sémák | Átalakítást igényel | Python szótár / JSON | Python lista / JSON | Típusos Pydantic modellek |
| Ideális downstream cél | Archivált PDF-ek, örökölt DMS | Űrlap/nyugta adatok, ERP-k | Gyors szkriptek, jelenet szöveg | LLM beolvasás, RAG architektúrák |
Folyamatajánlások: melyiket válasszon?
- Válassza a Tesseract-ot ha megfelelőségi követelményei szabványos
hOCR,ALTO XMLvagy kereshető PDF/A kimeneteket igényelnek kormányzati vagy archiválási feljegyzésekhez. - Válassza a PaddleOCR-t ha működési pénzügyi dokumentumokat (számlákat, nyugtákat, adóbevallásokat) dolgoz fel, amelyek összetett, szegély nélküli táblázatokat tartalmaznak, és ezeket HTML-re vagy táblázatokra kell konvertálni.
- Válassza az EasyOCR-t ha egy könnyű, Pythonos könyvtárra van szüksége, amely képes szöveget felismerni és kinyerni természetes képekről, utcajelzésekről vagy levágott UI elemekről konfigurációs gondok nélkül.
- Válassza a Surya OCR-t ha strukturálatlan üzleti jelentéseket, kutatási anyagokat és technikai útmutatókat táplál be egy LLM-be vagy vektorkereső motorba, ahol a logikus olvasási sorrend és a tiszta szerkezeti határok kiemelten fontosak.
Gyakran Ismételt Kérdések (GYIK)
1. Melyik nyílt forráskódú OCR kimeneti formátum a legegyszerűbb a nagy nyelvi modellekbe való betápláláshoz?
A Surya OCR olvasási sorrendet figyelembe vevő JSON-ja és a PaddleOCR PP-Structure HTML táblázatai a legtisztább ábrázolásokat nyújtják az LLM prompt kontextusokhoz és a RAG indexeléshez.
2. Tud-e a Tesseract natívan JSON válaszokat előállítani harmadik féltől származó eszközök nélkül?
Nem, a Tesseract natívan szöveget, TSV-t, PDF-et és hOCR/ALTO XML-t ad ki; a JSON előállítása a TSV vagy hOCR kimenet köztes elemzővel történő átalakítását igényli.
3. Hogyan különböznek a 4 pontból álló sokszög koordinátái a tengelyre igazított határoló dobozoktól?
Az tengelyhez igazított dobozok [x, y, width, height] formátumot használnak, feltételezve a sík szöveget, míg a 4-pontos sokszögek négy koordináta-párt biztosítanak a forgatott, ferde vagy ívelt szövegsorok pontos körülhatárolásához.
4. Melyik motor adja ki a táblázatszerkezeteket közvetlenül kódként a laza koordináták helyett?
A PaddleOCR PP-Structure modulja a detektált táblázatkereteket teljes HTML táblázatcímkékké (<table>, <tr>, <td>) állítja vissza, elkerülve az egyedi térbeli számításokat.
5. Miért nehézségekbe ütközik a standard EasyOCR kimenete a többoszlopos tudományos cikkeknél?
Az EasyOCR a szövegsorokat helyi közelség alapján azonosítja, nem pedig a globális elrendezési hierarchia szerint, ami miatt a szomszédos oszlopok szövege összefonódik, hacsak nem egy külső elrendezésmotor korlátozza.