Utoljára frissítve: 2026. szeptember 30.
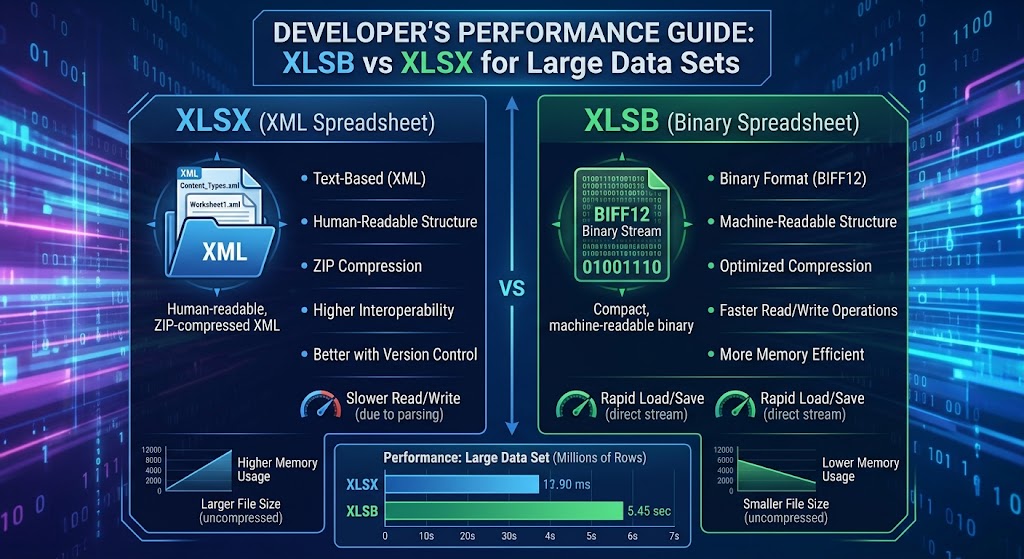
XLSB vs XLSX nagy adathalmazokhoz: Fejlesztői teljesítmény útmutató
Ha adatcsővezetékeket, háttérjelentés-motorokat vagy elemzőeszközöket építesz, amelyek a Microsoft Excel‑lel interfészelnek, valószínűleg már a “a falat” érintetted.
Egy felhasználó feltölt egy 450 000 soros munkafüzetet. A szervered elindít munkás szálakat, a memóriahasználat gigabájtokra ugrik, a szemétgyűjtés lefagyasztja a futtatókörnyezetet, és a végrehajtás időtúllépést kap. Megvizsgálod a terhet: ez egy szabványos .xlsx fájl.
Ennek megoldására a fejlesztők gyakran napokat töltenek a darabolás, streaming elemzők megvalósításával vagy a fájlok háttérmunkaerőkhöz való áthelyezésével. Ennek ellenére a leghatékonyabb optimalizációk egyike nulla architekturális áttervezést igényel: a fájlkiterjesztés megváltoztatása .xlsx‑ről .xlsb‑re.
Ebben az útmutatóban alaposan megvizsgáljuk mindkét formátumot, elemezzük, miért eredményeznek belső architektúráik radikálisan eltérő teljesítményjellemzőket, összehasonlítjuk a konkrét benchmarkokat Python és .NET környezetben, és világos szabályokat vázolunk fel arra vonatkozóan, mikor érdemes bináris munkafüzeteket üzembe helyezni.
1. A háttérben: OpenXML vs. BIFF12
Ahhoz, hogy megértsük, miért tér el annyira drámaian a teljesítmény nagy adathalmazok esetén, meg kell vizsgálnunk, hogyan tárolja az egyes formátum a rekordokat a lemezen.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
A .xlsx és .xlsb fájlok tömörített ZIP konténerek, amelyek megfelelnek az Open Packaging Conventions (OPC) szabványnak. Ha bármelyik fájlt .zip-re nevezed át és kibontod, egy ismerős könyvtárstruktúrát látsz: _rels, docProps, és xl/worksheets/.
A kritikus különbség a xl/worksheets/ mappában található:
- Az XLSX lapokat egyszerű XML szövegként (
sheet1.xml) tárolja. - Az XLSB lapokat saját tulajdonú bináris adatfolyamokként (
sheet1.bin) tárolja, amelyeket a Microsoft BIFF12 (Binary Interchange File Format 12) kódolásával kódolnak.
Hogyan kódolja a XLSX az adatokat (XML DOM terhelés)
Egy XLSX munkalapon minden cellát explicit XML címkékkel deklarálnak:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Ennek a sornak az olvasásakor a futtatókörnyezetnek a következőt kell tennie:
- A nyers deflate adatfolyamot szöveggé kell kitömöríteni.
- A karakterlánc karaktereit tokenizálni és XML DOM vagy SAX eseményfolyammá elemezni.
- Érvényesítse a nyitó és záró címkéket (
<c>,</c>,<v>,</v>). - Oldja fel a karakterlánc kereséseket egy külön
sharedStrings.xmltáblából. - Elemezze az ASCII szöveget
"98234.55"egy IEEE 754 64 bites lebegőpontos számmá.
Minden egyes cella CPU terhet jelent a karakterlánc elemzés, a karakterlánc lefoglalás és a lexikális elemzés miatt. Ha ezt 500 000 sorra és 30 oszlopra (15 millió cella) alkalmazzuk, a CPU sokkal több ciklust tölt a szintaxis elemzésével, mint a domain értékek feldolgozásával.
Hogyan kódolja a XLSB az adatokat (BIFF12 bináris adatfolyam)
A BIFF12 teljesen elhagyja a szöveg sorosítást. A karakterlánc jelölés helyett az adat egy sorozatos, változó hosszúságú bináris rekordok sorozataként van elrendezve:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
A BIFF12 lebegőpontos cellája nem használ karakterlánc ábrázolást, mint a "98234.55". Közvetlenül van ábrázolva:
- 2 bájt a rekordazonosítóhoz (pl.
BrtCellRkvagyBrtCellReal) - 4 bájt az oszlop/sor indexekhez
- 8 bájt, amely a nyers IEEE 754 dupla pontosságú bájtstruktúrát tartalmaz
Amikor a parsered egy XLSB fájlt olvas, teljesen kihagyja a lexikális elemzést. Kiolvassa a rekordfejlécet, megragadja a 8 nyers bájtot a pufferből, közvetlenül a memóriába másolja, és előre mozgatja a mutatót. Nincsenek érvényesítendő címkék, nincs karakterlánc-szám típuskonverzió, és nulla UTF-8 dekódolási terhelés a numerikus adatoknál.
2. Kvantitatív mérőszámok: lemez, memória és áteresztőképesség
A valós hatás bemutatásához vegyünk egy szimulált adatkészletet, amely 750,000 sor és 25 oszlop tartalmaz (időbélyegek, lebegőpontos számok, egész számok és kategória kódok keveréke).
Az alábbi tesztek azonos táblázatos adatokat értékelik, amelyek XLSX és XLSB formátumban is el vannak mentve.
Tesztkörnyezet
- CPU: AMD Ryzen 9 5900X (12 mag, 24 szál)
- RAM: 64 GB DDR4-3600
- Tároló: PCIe 4.0 NVMe SSD
- Futtatás: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Kulcsfontosságú teljesítménymutatók
| Mérőszám | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Javulás |
|---|---|---|---|
| Fájlméret a lemezen | 128.4 MB | 68.2 MB | ~47% kisebb |
| Mentés / Sorosítási idő | 42.6 s | 14.1 s | 3.0x gyorsabb |
| Olvasási idő (Python DOM parser) | 38.2 s | 8.9 s | 4.3x gyorsabb |
| Olvasási idő (Rust/C motor) | 6.4 s | 1.9 s | 3,3-szer gyorsabb |
| Csúcs heap lefoglalás olvasás során | ~1.85 GB | ~510 MB | ~72%-os csökkenés |
Miért kisebbek az XLSB fájlok
Míg mindkét formátum a szabványos ZIP tömörítést használja, a bináris adatfolyamok sokkal hatékonyabban tömörítenek, mint a felesleges XML szöveg:
- A redundáns szintaxis eltávolításra kerül: Az XML ismétlődő címkéket (
<c r="AA1" s="1">) tartalmaz minden egyes rekordban. Bár a ZIP tömörítés csökkenti az ismétlődő karakterláncokat, a tömörítetlen adatfolyam hatalmas. - Numerikus sűrűség: Az XML-ben a
12345678.9012szám 14 bájt ASCII szöveget igényel. A BIFF12-ben ez egy 8 bájtos doubleként tárolódik (vagy egy 4 bájtosRKrekordba csomagolva, ha megfelel a specifikus pontossági szabályoknak).
3. Memória lábnyoma és szemétgyűjtési nyomás
Webszolgáltatások és mikroszolgáltatások esetén, amelyek egyidejű kéréseket kezelnek, a CPU sebesség csak a harc felét jelenti; a memória lábnyoma az, ahol az alkalmazások valójában elbuknak.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Amikor egy XML elemző egy 100 MB-os XLSX fájlt dolgoz fel, ezreket kell létrehoznia átmeneti karakterlánc tokeneknek, karakterlánc szelet buffernek és szótár kereséseknek. A szemétgyűjtéses nyelvekben (Java, C#, Go, Node.js, Python) ez extrém heap fragmentációt eredményez, és a futtatókörnyezetet gyakori Garbage Collection (GC) szünetek felé tereli.
Mivel az XLSB elemzés közvetlenül rögzített szélességű bájt szeleteken működik, a parserek adatokat olvashatnak a stack-re allokált struktúrákba vagy újrahasználható bájt pufferekbe. Ennek eredményeként drámaian csökken a memóriahasználat, és nincs memória-frissítés a futásidejű allokátorban.
4. Fejlesztői megvalósítási példák
Nézzük meg, hogyan használhatjuk ki az XLSB-t a gyakori fejlesztői eszközláncokban.
Python: áttérés az OpenPyXL-ről a Calamine / PyXLSB-re
Az alapértelmezett pandas.read_excel('data.xlsx') a openpyxl-t használja, amely egy nehéz memóriában tárolt fát épít.
Nagy XLSB fájlok maximális sebességgel történő feldolgozásához használja a Rust-alapú calamine motorját (elérhető a python-calamine-on keresztül, és integrálva a modern Pandasba):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Ha hatalmas adatkészleteken soronként iterál anélkül, hogy az egész mátrixot betöltené egy DataFrame-be, a pyxlsb egy könnyűsúlyú streaming iterátort biztosít:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Nagyteljesítményű adatfolyam befogadás
.NET környezetben a ClosedXML vagy az EPPlus könyvtárak nagyszerűek a szabványos generáláshoz, de nagy fájlok memória-kimerülés nélküli beolvasásához a XLSB támogatással rendelkező ExcelDataReader kivételesen gyors:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Architektúrábeli kompromisszumok: Mikor NEM kell XLSB-t használni
Annak ellenére, hogy az XLSB lenyűgöző teljesítményelőnyökkel jár, nem csodaszer. Érdemes mérlegelni több operációs kompromisszumot, mielőtt kötelezővé tenné a stack-jében:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ökoszisztéma és könyvtár támogatás
- XLSX: Univerzális. Gyakorlatilag minden nyelv, könyvtár, SaaS eszköz (Google Sheets, Airtable, Tableau), és webes elemző natívan támogatja az OpenXML-et.
- XLSB: Kevésbé elterjedt. Bár az Excel, a LibreOffice és a kiforrott fejlesztői könyvtárak (
ExcelDataReader,pyxlsb,calamine,Aspose) támogatják, sok könnyűcsomag vagy tisztán webalapú JavaScript-elemző (például aSheetJSrégebbi verziói) korlátozott vagy csak olvasási támogatással rendelkezik.
2. Git és verziókezelő diffelés
- XLSX: Mivel szöveges XML-t tartalmaz egy ZIP konténerben, a parancssori segédprogramok és a Git hookok ki tudják csomagolni és formázni az XML-t, hogy olvasható struktúrált különbségeket (diff-eket) generáljanak a commitok között.
- XLSB: Tiszta bináris adat. A verziókezelő rendszerek szigorúan átlátszatlan bináris blobként kezelik, ezzel kiküszöbölve a részletes diff-elés vagy sor-szintű egyesítés lehetőségét.
3. Webkliens renderelés
Ha az architektúrája közvetlenül a böngészőben, WebAssembly vagy kliensoldali JavaScript segítségével jeleníti meg a táblázatokat, az XLSX-elemzők lényegesen érettebbek és kevésbé hajlamosak a szélsőséges esetekre jellemző megjelenítési hibákra, mint a kliensoldali bináris elemzők.
4. Harmadik fél általi befogadási csővezetékek
Ha külső vállalati ügyfeleknek exportál fájlokat, számos szigorú vállalati biztonsági irányelv jelzi a .xlsb fájlokat. Mivel a BIFF12 fájlok VBA makrókat ugyanúgy tárolhatják, mint a .xlsm fájlok (külön kiterjesztés nélkül), egyes levélszűrők és tűzfal szkennerek karanténba helyezik a .xlsb feltöltéseket potenciális makrókat tartalmazó fenyegetésként.
6. Összegző összehasonlítás: Melyik formátum nyer?
| Funkció | XLSX | XLSB | Győztes |
|---|---|---|---|
| Olvasási / Feldolgozási Sebesség | Közepes-től Gyenge | Villámgyors | XLSB |
| Írási / Generálási Sebesség | CPU-igényes | Gyors | XLSB |
| Fájl tömörítés | Jó | Kiváló (~40-50% kisebb) | XLSB |
| Memóriafoglalás | Magas (Nehéz GC nyomás) | Alacsony (Közvetlen bájtolvasás) | XLSB |
| Eszközök közötti interoperabilitás | Univerzális | Magas, de szelektív | XLSX |
| Biztonsági szkennelés súrlódása | Minimális | Ritka hamis pozitívok | XLSX |
| Makróképesség | Nem (.xlsm szükséges) | Igen (Natív módon támogatja a makrókat) | Döntetlen |
7. A fejlesztő véleménye
Használja a XLSX-et, ha:
- A fájlok kicsi‑közepes méretűek (< 50,000 sor).
- A fájljaidat harmadik fél SaaS platformoknak vagy fogyasztói alkalmazásoknak (pl. Google Sheets) kell feldolgozniuk.
- Nem tudja irányítani a végfelhasználó környezetét, amely a fájlt olvassa.
Váltson XLSB-re, ha:
- Belső adatcsatornákat, kötegelt feladatokat, ETL rendszereket vagy munkavégző feladatokat épít, amelyek hatalmas adatkinyeréseket kezelnek (> 100,000 sor).
- A szervereid memóriahiány (OOM) hibákat tapasztalnak a táblázat sorosítása vagy deszerializálása során.
- Minimalizálnod kell az S3/blob tárolási lábnyomát és a hálózati átvitel idejét nagy, ismétlődő pénzügyi modellek vagy adatexportok esetén.
Az XLSB-re való áttérés gyakran olyan egyszerű, mint egy konfigurációs karakterlánc módosítása az exportszolgáltatásban, mégis olyan 3‑5‑szörös áteresztőképesség‑növekedést biztosít, amely általában hetekig tartó kódoptimalizálást igényel.
Gyakran Ismételt Kérdések (GYIK)
**Q1: Támogat egy XLSB fájl pontosan ugyanazt a sor- és oszlopszám‑korlátot, mint egy XLSX fájl? Igen; mind az XLSB, mind az XLSX ugyanazt a rács‑felső határt osztja meg, amely 1 048 576 sort és 16 384 oszlopot tesz ki munkalaponként.
**Q2: Biztonságosan tárolhat egy XLSB fájl VBA makrókat a fájlkiterjesztés megváltoztatása nélkül?
Igen, a XLSX-től (amelyhez a kód végrehajtásához XLSM‑ként kell menteni) eltérően, az XLSB natívan támogatja a bináris VBA makrók tárolását ugyanabban a .xlsb fájlformátumban.
**Q3: Miért csökkenti egy fájl XLSB‑ként való mentése a méretét, ha mindkét formátum már ZIP‑tömörítést használ? Az XLSB megszünteti a felesleges szöveges jelölőcímkéket, és a cellapozíciókat, rekordokat, valamint a nyers numerikus értékeket szoros bináris bájtfolyamokba kódolja, amelyek sokkal sűrűbben tömörítenek, mint az egyszerű XML karakterláncok.
**Q4: A Google Sheets közvetlenül importálhat és szerkeszthet XLSB fájlokat?
Nem; a Google Sheets nem képes natívan megnyitni vagy közvetlenül konvertálni a .xlsb fájlokat, ezért először .xlsx vagy CSV formátumba kell konvertálni őket az importálás előtt.
**Q5: Az XLSB fájlok nagyobb valószínűséggel szenvednek adatkorruptiót, mint az XLSX fájlok? Miközben az XML fájlokat részben korrupt állapotban néha manuálisan is meg lehet vizsgálni vagy javítani szövegszerkesztővel, a bináris BIFF12 folyamok szigorú bájteltolásokat igényelnek, és nehéz őket manuálisan helyreállítani, ha a strukturális szektorok megsérülnek.