Terakhir Diperbarui: 20 Aug, 2026
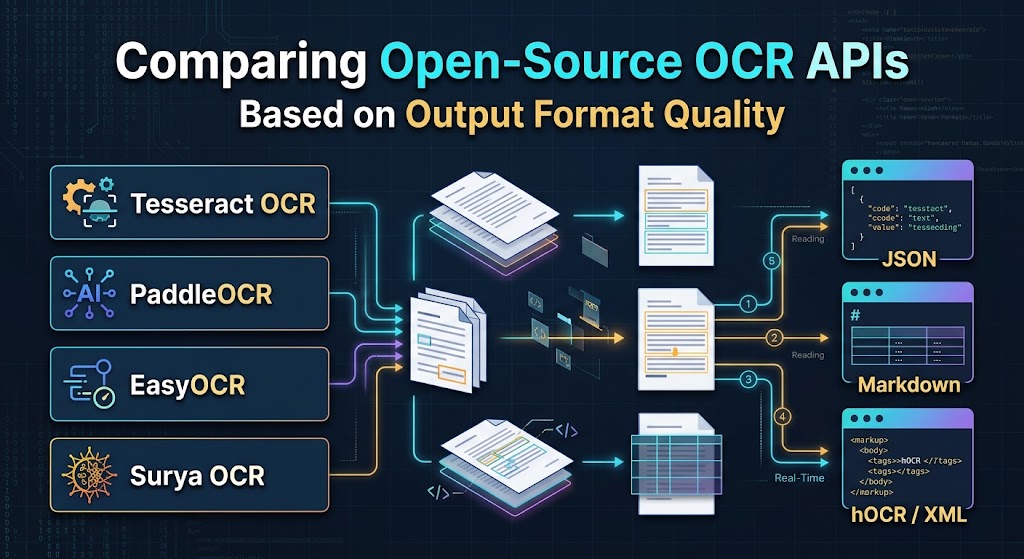
Membandingkan API OCR Open-Source Berdasarkan Kualitas Format Output
Ketika insinyur mengevaluasi mesin Optical Character Recognition (OCR), tingkat kesalahan karakter (CER) dan tingkat kesalahan kata (WER) biasanya mendominasi tolok ukur. Meskipun akurasi pengenalan penting, hal itu hanya menyelesaikan setengah masalah dalam produksi.
Jika Anda sedang mem-parsing PDF kompleks berkolom ganda, mengekstrak item baris dari kwitansi, atau memasukkan whitepaper ke dalam pipeline embedding LLM, dump teks mentah menciptakan beban teknik yang besar. Sekumpulan karakter tanpa kesadaran tata letak, urutan baca logis, atau data koordinat memaksa tim Anda menulis parser heuristik yang rapuh.
Pembeda sejati untuk alur kerja dokumen modern adalah kualitas format output: seberapa konsisten dan bersih sebuah mesin memberikan koordinat, urutan baca, hierarki struktural, dan data tabel.
Berikut adalah perbandingan yang berfokus pada teknik dari empat mesin OCR sumber terbuka terkemuka—Tesseract, PaddleOCR, EasyOCR, dan Surya OCR—yang mengevaluasi bagaimana output mereka berperilaku di dalam pipeline otomatis.
Format Output Umum: Apa yang Sebenarnya Dibutuhkan Insinyur
Setiap API OCR mengemas teks yang terdeteksi secara berbeda. Memahami format-format ini membantu menentukan berapa banyak pemrosesan lanjutan yang diperlukan oleh pipeline Anda:
- Plain Text (
.txt): Representasi paling sederhana. Ini menghapus semua metadata posisi dan menggabungkan tata letak multi-kolom menjadi bacaan horizontal, yang dapat mengacak paragraf. - Archival Standards (
hOCR,ALTO XML): Format berbasis XML/HTML yang standar dalam pengarsipan perpustakaan. Mereka menyematkan koordinat, perkiraan font, dan nilai kepercayaan di dalam node DOM. Sangat kuat untuk rekonstruksi dokumen, tetapi berat untuk layanan mikro. - Structured JSON: Pilihan default untuk backend web modern. Menyediakan array koordinat (kotak pembatas atau poligon), nilai kepercayaan, dan struktur hierarkis blok/baris/kata.
- Markdown (
.md) / HTML Tables: Standar modern untuk Retrieval-Augmented Generation (RAG). Mempertahankan bagian semantik (header, daftar, teks tebal) dan matriks tabel tanpa memerlukan rekonstruksi spasial di hilir.
1. Tesseract OCR
Dipelihara oleh Google, Tesseract tetap menjadi kuda kerja dasar OCR sumber terbuka. Arsitekturnya sangat bergantung pada algoritma segmentasi halaman tradisional yang dilengkapi dengan mesin karakter berbasis LSTM.
Format Output Asli
- Output Utama: Plain text, hOCR (HTML), ALTO XML, TSV (Tab-Separated Values), dan PDF/A yang dapat dicari.
- Kesadaran Tata Letak: Heuristik berbasis aturan melalui Mode Segmentasi Halaman (PSM).
Analisis Format Output
- Di Mana Ia Unggul: Ekspor
TSVdanhOCRTesseract bersifat standar dan dapat diprediksi. Satu ekspor TSV mengembalikan kolom terstruktur untuklevel,page_num,block_num,par_num,line_num,word_num,left,top,width,height, danconf. Jika Anda mengonversi arsip kertas menjadi PDF yang dapat dicari atau memerlukan kepatuhan ketat pada standar institusi, Tesseract menangani ini secara native tanpa kode pengikat khusus. - Di Mana Ia Kurang: Tesseract tidak memiliki API JSON native. Mengonsumsi outputnya di Python atau Node.js memerlukan parsing file XML/TSV atau menggunakan pembungkus seperti
pytesseract. Mesin tata letaknya juga kesulitan dengan aliran kolom non-standar, sering mencampur teks dari kolom bersebelahan kecuali dipotong secara manual dengan batasan.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Didukung oleh kerangka kerja PaddlePaddle milik Baidu, PaddleOCR telah mendapatkan adopsi luas karena modelnya yang ringan, cakupan multi-bahasa yang luas, dan toolkit analisis dokumen khusus (PP-Structure).
Format Output Asli
- Output Utama: Python list/dictionary, JSON mentah, overlay visualisasi, dan HTML terstruktur melalui PP-Structure.
- Kesadaran Tata Letak: Tinggi (menggunakan model deep learning untuk parsing tata letak, klasifikasi orientasi, dan pemulihan tabel).
Analisis Format Output
- Di Mana Ia Unggul: PaddleOCR standar mengembalikan koordinat poligon 4 titik (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) bersama dengan string teks dan skor kepercayaan. Ini menangani teks yang miring atau melengkung dengan baik. Namun, kekuatan sebenarnya terletak pada suite PP-Structure, yang mendeteksi wilayah tata letak (judul, teks, tabel, gambar) dan mengurai tabel langsung menjadi string HTML yang valid (<table>...</table>). Ini menghilangkan kebutuhan untuk menghitung rentang sel secara manual dari kotak pembatas. - Di Mana Ia Kurang: API dasar mengembalikan array bersarang yang tidak memiliki kunci properti standar di berbagai versi. Untuk aplikasi terstruktur, pengembang biasanya menulis adaptor menengah untuk menstandarisasi nama bidang (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Dibangun di atas PyTorch oleh JaidedAI, EasyOCR dirancang untuk adopsi cepat oleh pengembang. Ia mengemas CRAFT (Character Region Awareness for Text Detection) dengan jaringan pengenalan deep learning ke dalam API minimal.
Format Output Asli
- Output Utama: Daftar Python yang berisi tuple koordinat, string yang dikenali, dan nilai kepercayaan.
- Kesadaran Tata Letak: Rendah hingga sedang (hanya deteksi baris teks; tidak ada parsing struktural tingkat dokumen).
Analisis Format Output
- Di Mana Ia Unggul: Kesederhanaan objek pengembalian tidak tertandingi:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Memetakan output ini ke respons REST standar atau menyerialkannya langsung ke GeoJSON/skema khusus hanya memerlukan beberapa baris kode. Ia berfungsi secara andal pada teks adegan alami, plat nomor, dan potongan dokumen terisolasi.
- Di Mana Ia Kurang: EasyOCR tidak melakukan analisis tata letak dokumen secara holistik. Ia tidak mengidentifikasi tabel, hierarki judul, atau urutan baca di seluruh kolom kompleks. Menggunakan EasyOCR pada makalah akademik dua kolom sering menghasilkan potongan teks yang terjalin kecuali dipasangkan dengan model deteksi tata letak hulu (seperti YOLO atau LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya adalah kerangka kerja OCR pembelajaran mendalam modern yang dirancang khusus untuk pemahaman dokumen kompleks dan pipeline ingest LLM.
Format Output Asli
- Output Utama: Struktur JSON yang dimodelkan dengan Pydantic, indeks urutan baca logis, wilayah pembatas tata letak, dan poligon deteksi baris.
- Kesadaran Tata Letak: Sangat tinggi (analisis tata letak berbasis pembelajaran mendalam dan penyortiran urutan baca).
Analisis Format Output
- Di Mana Ia Unggul: Surya secara langsung menangani tantangan rekayasa AI modern. Alih-alih mengasumsikan dokumen dibaca dari atas ke bawah, kiri ke kanan, Surya menggunakan model khusus untuk memprediksi urutan baca. Ia mengelompokkan baris menjadi blok semantik logis, menangani rentang multi‑kolom secara alami, dan menghasilkan struktur bertipe melalui Pydantic. Ini membuat proses ingest downstream ke basis data vektor dan konverter Markdown menjadi langsung dan dapat diandalkan.
- Di Mana Ia Kurang: Sebagai kerangka kerja berbasis PyTorch yang lebih baru dan lebih berat, Surya memerlukan komputasi GPU khusus untuk menyamai throughput mesin C++ yang dioptimalkan seperti Tesseract atau model Paddle yang dikuantisasi. Ia tidak menargetkan standar arsip warisan seperti hOCR atau ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Matriks Perbandingan Langsung
| Kemampuan / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Asli hOCR / ALTO XML | Dukungan asli | Hanya pihak ketiga | Tidak ada | Tidak ada |
| Geometri Kotak Pembatas | Sejajar sumbu (x, y, w, h) | Poligon 4 titik | Poligon 4 titik | Poligon + Blok Tata Letak |
| Parsing Tabel | Koordinat TSV saja | String Tabel HTML | Tidak ada | Grid koordinat sel |
| Deteksi Urutan Bacaan | Berbasis aturan (memutus pada multi-kolom) | Analisis tata letak ML | Pengelompokan baris dasar | Model urutan bacaan khusus |
| Skema JSON Langsung | Membutuhkan konversi | Python Dict / JSON | Python List / JSON | Model Pydantic Bertipe |
| Target Hilir Ideal | PDF Arsip, DMS Warisan | Data Form/Resi, ERP | Skrip Cepat, Teks Adegan | Ingest LLM, Arsitektur RAG |
Rekomendasi Pipeline: Mana yang Harus Anda Pilih?
- Pilih Tesseract jika persyaratan kepatuhan Anda membutuhkan deliverable standar
hOCR,ALTO XML, atau PDF/A yang dapat dicari untuk catatan pemerintah atau arsip. - Pilih PaddleOCR jika Anda memproses dokumen keuangan operasional (faktur, resi, formulir pajak) yang berisi tabel kompleks tanpa batas yang harus dikonversi ke HTML atau spreadsheet.
- Pilih EasyOCR jika Anda membutuhkan pustaka ringan dan bersifat Pythonic untuk mendeteksi dan mengekstrak teks dari gambar alami, rambu jalan, atau elemen UI yang dipotong tanpa kerepotan konfigurasi.
- Pilih Surya OCR jika Anda memasukkan laporan bisnis tidak terstruktur, makalah penelitian, dan panduan teknis ke dalam LLM atau mesin pencari vektor di mana urutan baca logis dan batas struktural yang bersih sangat penting.
Pertanyaan yang Sering Diajukan (FAQ)
1. Format output OCR open-source mana yang paling mudah dimasukkan ke Model Bahasa Besar?
JSON yang menyadari urutan baca dari Surya OCR dan tabel HTML PP-Structure dari PaddleOCR menyediakan representasi paling bersih untuk konteks prompt LLM dan pengindeksan RAG.
2. Bisakah Tesseract menghasilkan respons JSON secara native tanpa alat pihak ketiga?
Tidak, Tesseract secara native menghasilkan teks, TSV, PDF, dan hOCR/ALTO XML; menghasilkan JSON memerlukan konversi output TSV atau hOCR menggunakan parser perantara.
3. Bagaimana koordinat poligon 4‑titik berbeda dari kotak pembatas yang sejajar sumbu?
Kotak yang sejajar sumbu menggunakan [x, y, width, height] dengan asumsi teks datar, sementara poligon 4-titik menyediakan empat pasangan koordinat untuk secara akurat melingkupi baris teks yang diputar, miring, atau melengkung.
4. Mesin mana yang menghasilkan struktur tabel langsung ke dalam kode daripada koordinat longgar?
Modul PP-Structure dari PaddleOCR merekonstruksi batas tabel yang terdeteksi menjadi tag tabel HTML lengkap (<table>, <tr>, <td>), menghindari matematika spasial khusus.
5. Mengapa output standar EasyOCR kesulitan pada makalah ilmiah berkolom ganda?
EasyOCR mengidentifikasi baris teks berdasarkan kedekatan lokal bukan hierarki tata letak global, menyebabkan teks dari kolom bersebelahan saling terjalin kecuali dibatasi oleh mesin tata letak eksternal.