Terakhir Diperbarui: 30 Sep, 2026
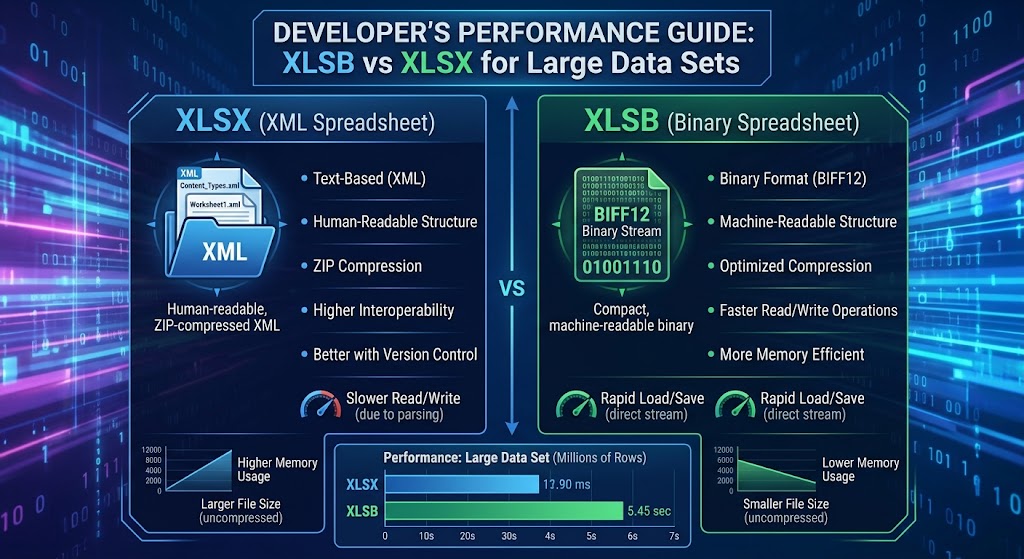
XLSB vs XLSX untuk Set Data Besar: Panduan Kinerja Pengembang
Jika Anda membangun pipeline data, mesin pelaporan backend, atau alat analitik yang berinteraksi dengan Microsoft Excel, Anda kemungkinan besar telah menemui “tembok.”
Seorang pengguna mengunggah buku kerja dengan 450.000 baris. Server Anda memulai thread pekerja, konsumsi memori melonjak ke gigabyte, pengumpulan sampah membekukan runtime, dan eksekusi Anda kehabisan waktu. Anda memeriksa payload: itu adalah file .xlsx standar.
Untuk mengatasinya, pengembang sering menghabiskan hari-hari untuk mengimplementasikan chunking, parser streaming, atau memindahkan file ke pekerja latar belakang. Namun, salah satu optimasi paling efektif tidak memerlukan redesign arsitektur sama sekali: mengubah ekstensi file dari .xlsx menjadi .xlsb.
Dalam panduan ini, kami menyelami bagian dalam kedua format, memeriksa mengapa arsitektur internal mereka menghasilkan karakteristik kinerja yang sangat berbeda, membandingkan benchmark konkret di Python dan .NET, serta merumuskan aturan jelas kapan harus menggunakan buku kerja biner dalam produksi.
1. Di Balik Layar: OpenXML vs. BIFF12
Untuk memahami mengapa kinerja berdivergensi begitu dramatis pada dataset besar, kita harus melihat bagaimana setiap format menyimpan catatan di disk.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Baik file .xlsx maupun .xlsb merupakan kontainer ZIP terkompresi yang mematuhi Open Packaging Conventions (OPC). Jika Anda mengganti nama salah satu file menjadi .zip dan mengekstraknya, Anda akan melihat tata letak direktori yang familiar: _rels, docProps, dan xl/worksheets/.
Perbedaan kritis terletak di dalam folder xl/worksheets/:
- XLSX menyimpan lembar kerja sebagai teks XML biasa (
sheet1.xml). - XLSB menyimpan lembar kerja sebagai aliran biner proprietari (
sheet1.bin), yang dikodekan menggunakan BIFF12 milik Microsoft (Binary Interchange File Format 12).
Bagaimana XLSX Mengkode Data (Overhead XML DOM)
Dalam lembar kerja XLSX, setiap sel dideklarasikan dengan tag XML yang eksplisit:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Saat membaca baris ini, runtime Anda harus:
- Mende-kompres aliran deflate mentah menjadi teks.
- Menganalisis token dan mengurai karakter string menjadi DOM XML atau aliran peristiwa SAX.
- Validasi tag pembuka dan penutup (
<c>,</c>,<v>,</v>). - Selesaikan pencarian string dari tabel
sharedStrings.xmlterpisah. - Parse teks ASCII
"98234.55"menjadi angka floating-point 64-bit IEEE 754.
Setiap sel menimbulkan overhead CPU untuk parsing string, alokasi string, dan analisis leksikal. Kalikan ini pada 500,000 baris dan 30 kolom (15 juta sel), dan CPU menghabiskan jauh lebih banyak siklus parsing sintaks daripada memproses nilai domain.
Bagaimana XLSB Mengkode Data (Aliran Biner BIFF12)
BIFF12 mengabaikan serialisasi teks sepenuhnya. Alih-alih markup string, data diatur sebagai urutan berurutan dari record biner dengan panjang variabel:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Sel floating-point dalam BIFF12 tidak menggunakan representasi string seperti "98234.55". Itu direpresentasikan secara langsung:
- 2 byte untuk ID record (mis.,
BrtCellRkatauBrtCellReal) - 4 byte untuk indeks kolom/baris
- 8 byte yang berisi struktur byte mentah IEEE 754 double-precision
Ketika parser Anda membaca file XLSB, ia melewati parsing leksikal sepenuhnya. Ia membaca header record, mengambil 8 byte mentah dari buffer, menyalinnya langsung ke memori, dan memindahkan pointer ke depan. Tidak ada tag yang perlu divalidasi, tidak ada konversi tipe string-ke-angka, dan tidak ada overhead decoding UTF-8 untuk data numerik.
2. Tolok Ukur Kuantitatif: Disk, Memori, dan Laju Transfer
Untuk menggambarkan dampak dunia nyata, pertimbangkan dataset simulasi yang berisi 750.000 baris dan 25 kolom (campuran timestamp, angka floating-point, integer, dan kode kategori).
Tes di bawah ini mengevaluasi data tabular identik yang disimpan sebagai XLSX dan XLSB.
Lingkungan Pengujian
- CPU: AMD Ryzen 9 5900X (12 inti, 24 utas)
- RAM: 64 GB DDR4-3600
- Storage: PCIe 4.0 NVMe SSD
- Runtime: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Metrik Kinerja Utama
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Peningkatan |
|---|---|---|---|
| Ukuran File di Disk | 128.4 MB | 68.2 MB | ~47% lebih kecil |
| Simpan / Waktu Serialisasi | 42.6 s | 14.1 s | 3.0x lebih cepat |
| Waktu Baca (parser DOM Python) | 38.2 s | 8.9 s | 4.3x lebih cepat |
| Waktu Baca (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x lebih cepat |
| Alokasi Heap Puncak selama Baca | ~1.85 GB | ~510 MB | ~72% pengurangan |
Mengapa File XLSB Lebih Kecil
Meskipun kedua format menggunakan kompresi ZIP standar, aliran biner mengompres jauh lebih efisien dibandingkan teks XML yang berlebihan:
- Sintaks berlebih dihilangkan: XML berisi tag berulang (
<c r="AA1" s="1">) pada setiap catatan. Meskipun kompresi ZIP mengurangi string yang berulang, aliran data yang tidak terkompresi tetap sangat besar. - Kepadatan numerik: Dalam XML, angka
12345678.9012memerlukan 14 byte teks ASCII. Dalam BIFF12, angka tersebut disimpan sebagai double 8-byte (atau dipak menjadi recordRK4-byte jika memenuhi aturan presisi tertentu).
3. Jejak Memori dan Tekanan Pengumpulan Sampah
Untuk layanan web dan mikrolayanan yang menangani permintaan bersamaan, kecepatan CPU hanya setengah dari perjuangan; jejak memori adalah tempat aplikasi sebenarnya gagal.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Ketika parser XML memproses file XLSX berukuran 100 MB, ia harus membuat ribuan token string sementara, buffer irisan string, dan pencarian kamus. Dalam bahasa yang menggunakan pengumpulan sampah (Java, C#, Go, Node.js, Python), hal ini menyebabkan fragmentasi heap yang ekstrem dan memaksa runtime ke jeda Pengumpulan Sampah (GC) yang sering.
Karena parsing XLSB beroperasi langsung pada irisan byte lebar tetap, parser dapat membaca data ke dalam struktur yang dialokasikan di stack atau buffer byte yang dapat digunakan kembali. Hasilnya adalah jejak memori yang berkurang secara dramatis dan tidak ada thrashing pada allocator runtime.
4. Contoh Implementasi Pengembang
Mari kita lihat bagaimana memanfaatkan XLSB di seluruh rantai alat pengembang yang umum.
Python: Migrasi dari OpenPyXL ke Calamine / PyXLSB
Standar pandas.read_excel('data.xlsx') secara default menggunakan openpyxl, yang membangun pohon memori berat.
Untuk memproses file XLSB besar dengan kecepatan maksimum, gunakan mesin calamine yang didukung Rust (tersedia melalui python-calamine dan terintegrasi ke dalam Pandas modern):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Jika Anda mengiterasi dataset besar baris demi baris tanpa memuat seluruh matriks ke dalam DataFrame, pyxlsb menyediakan iterator streaming yang ringan:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Ingesti Aliran Berkinerja Tinggi
Di .NET, pustaka seperti ClosedXML atau EPPlus sangat bagus untuk pembuatan standar, tetapi untuk mengimpor file besar tanpa kehabisan memori, ExcelDataReader dengan dukungan XLSB sangat cepat:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Pertukaran Arsitektur: Kapan TIDAK Menggunakan XLSB
Meskipun memiliki keunggulan kinerja yang luar biasa, XLSB bukanlah solusi ajaib. Anda harus mempertimbangkan beberapa trade‑off operasional sebelum menerapkannya di seluruh stack Anda:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Dukungan Ekosistem dan Perpustakaan
- XLSX: Universal. Hampir setiap bahasa, perpustakaan, alat SaaS (Google Sheets, Airtable, Tableau), dan parser web mendukung OpenXML secara native.
- XLSB: Kurang umum. Sementara Excel, LibreOffice, dan perpustakaan pengembang yang matang (
ExcelDataReader,pyxlsb,calamine,Aspose) mendukungnya, banyak paket ringan atau parser JavaScript berbasis web murni (seperti versi lamaSheetJS) memiliki dukungan terbatas atau hanya baca.
2. Git & Perbandingan Kontrol Versi
- XLSX: Karena berisi XML teks di dalam kontainer ZIP, utilitas baris perintah dan hook Git dapat mengekstrak dan memformat XML untuk menghasilkan diff struktural yang dapat dibaca antara commit.
- XLSB: Data biner murni. Sistem kontrol versi memperlakukannya secara ketat sebagai blob biner yang tidak dapat dilihat, menghilangkan segala kemungkinan diff granular atau penggabungan tingkat baris.
3. Rendering Klien Web
Jika arsitektur Anda bergantung pada merender spreadsheet secara langsung di browser melalui WebAssembly atau JavaScript sisi klien, parser XLSX secara signifikan lebih matang dan kurang rentan terhadap bug rendering kasus pinggir dibandingkan parser biner sisi klien.
4. Pipeline Ingesti Pihak Ketiga
Jika Anda mengekspor file untuk klien perusahaan eksternal, banyak kebijakan keamanan korporat yang ketat menandai file .xlsb. Karena file BIFF12 dapat menyimpan makro VBA secara identik dengan file .xlsm (tanpa memerlukan ekstensi terpisah), beberapa filter email dan pemindai firewall mengarantina unggahan .xlsb sebagai potensi ancaman yang membawa makro.
6. Perbandingan Ringkas: Format Mana yang Menang?
| Fitur | XLSX | XLSB | Pemenang |
|---|---|---|---|
| Kecepatan Baca / Parsing | Sedang hingga Buruk | Sangat Cepat | XLSB |
| Kecepatan Tulis / Pembuatan | Intensif CPU | Cepat | XLSB |
| Kompresi File | Baik | Luar biasa (~40-50% lebih kecil) | XLSB |
| Alokasi Memori | Tinggi (Tekanan GC berat) | Rendah (Pembacaan byte langsung) | XLSB |
| Interoperabilitas Alat | Universal | Tinggi, tetapi selektif | XLSX |
| Gesekan Pemindaian Keamanan | Minimal | Positif palsu sesekali | XLSX |
| Kemampuan Makro | Tidak (.xlsm diperlukan) | Ya (Mendukung makro secara native) | Seri |
7. Putusan Pengembang
Gunakan XLSX ketika:
- File berukuran kecil hingga sedang (< 50.000 baris).
- File Anda harus diambil oleh platform SaaS pihak ketiga atau aplikasi konsumen (mis., Google Sheets).
- Anda tidak dapat mengontrol lingkungan klien akhir yang membaca file.
Beralih ke XLSB ketika:
- Anda sedang membangun pipeline internal, pekerjaan batch, sistem ETL, atau tugas pekerja yang menangani ekstrak data masif (> 100.000 baris).
- Server Anda mengalami kesalahan out-of-memory (OOM) saat serialisasi atau deserialisasi spreadsheet.
- Anda perlu meminimalkan jejak penyimpanan S3/blob dan waktu transit jaringan untuk model keuangan berulang yang besar atau ekspor data.
Beralih ke XLSB seringkali sesederhana mengubah string konfigurasi di layanan ekspor Anda, namun memberikan peningkatan throughput sebesar 3x hingga 5x yang biasanya memerlukan minggu-minggu optimasi kode.
Pertanyaan yang Sering Diajukan (FAQ)
**Q1: Apakah file XLSB mendukung batas baris dan kolom yang persis sama dengan file XLSX? Ya; baik XLSB maupun XLSX memiliki batas grid yang persis sama yaitu 1.048.576 baris oleh 16.384 kolom per lembar kerja.
**Q2: Apakah file XLSB dapat menyimpan makro VBA dengan aman tanpa mengubah ekstensi file-nya?
Ya, tidak seperti XLSX (yang memerlukan penyimpanan sebagai XLSM untuk mengeksekusi kode), XLSB mendukung penyimpanan makro VBA biner secara native di dalam format file .xlsb yang sama.
**Q3: Mengapa menyimpan file sebagai XLSB mengurangi ukurannya jika kedua format sudah dikompresi ZIP? XLSB menghilangkan tag markup teks yang bertele-tele dan mengkodekan posisi sel, catatan, serta nilai numerik mentah ke dalam aliran byte biner yang rapat, yang mengompres jauh lebih padat dibandingkan string XML biasa.
**Q4: Apakah Google Sheets dapat mengimpor dan mengedit file XLSB secara langsung?
Tidak; Google Sheets tidak dapat membuka atau mengonversi file .xlsb secara native, sehingga Anda harus mengonversinya ke .xlsx atau CSV sebelum mengimpor.
**Q5: Apakah file XLSB lebih rentan terhadap korupsi data dibandingkan file XLSX? Meskipun file XML kadang dapat diperiksa atau diperbaiki secara manual dengan editor teks ketika sebagian korup, aliran biner BIFF12 memerlukan offset byte yang ketat dan sulit dipulihkan secara manual jika sektor strukturalnya rusak.