Ultimo aggiornamento: 20 Aug, 2026
Quali sono i formati di file GIS cloud-native? Guida per sviluppatori
Se hai mai costruito una pipeline geospaziale, conosci il fastidio del “download-first” bottleneck. Tradizionalmente, se la tua applicazione aveva bisogno di un riquadro di 500x500 pixel da una scena satellitare di 15 GB—o voleva filtrare dieci righe da un dataset municipale di parcelle da 4 GB—dovevi scaricare l’intero file, analizzarlo in memoria e poi estrarre la parte di cui ti interessava davvero.
Caricare semplicemente uno Shapefile, GeoJSON o un GeoTIFF standard in un bucket Amazon S3 o Google Cloud Storage non lo rende nativo al cloud. Lo mette semplicemente un file legacy sul disco rigido di qualcun altro.
Nativo al cloud formati GIS risolvono questo problema ristrutturando il modo in cui i dati spaziali sono organizzati su disco. Invece di costringere i client a leggere i file sequenzialmente dall’inizio alla fine, questi formati sono progettati per letture dirette e parziali attraverso la rete. Per gli sviluppatori, ciò apre architetture serverless, riduce drasticamente i costi di egress e consente ai client web di interrogare dataset massivi direttamente dallo storage statico di oggetti.
La meccanica: come funziona realmente il geospaziale cloud-native
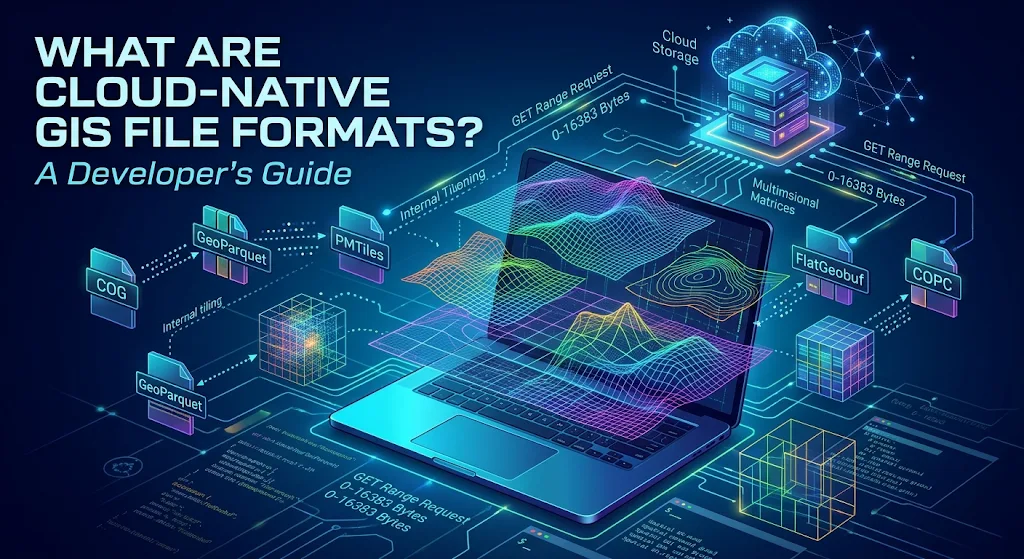
Prima di approfondire le estensioni di file specifiche, è utile comprendere il modello ingegneristico sottostante che le fa funzionare. Quasi tutti i formati geospaziali cloud‑native si basano su tre meccanismi fondamentali:
- Richieste di intervallo HTTP (
GETcon intestazioniRange): HTTP/1.1 e HTTP/2 standard supportano la richiesta di intervalli di byte specifici da un file remoto (ad es.,bytes=0-16383). I servizi di storage cloud come AWS S3, Cloudflare R2 e Azure Blob Storage supportano nativamente questa funzionalità fin da subito. - Metadati e indici spaziali pre-caricati (o prevedibili): Per richiedere i byte esatti che coprono un’area geografica, il client ha prima bisogno di una mappa della struttura interna del file. I formati cloud‑native memorizzano i metadati dell’intestazione e gli indici spaziali (come R‑tree o gerarchie di bounding‑box) in una posizione prevedibile—di solito all’inizio o alla fine del file. Un client effettua una piccola richiesta iniziale per leggere l’indice, calcola gli offset di byte esatti per la regione di destinazione e recupera solo quei blocchi.
- Tiling interno e segmentazione a blocchi: Piuttosto che memorizzare raster riga per riga o vettori come un muro di testo piatto, i dati sono suddivisi in blocchi autonomi e compressi (tile, gruppi di righe o chunk N-dimensionali) che possono essere recuperati e decompressi in modo indipendente.
I formati di file GIS cloud-native principali
Non esiste un formato unico che li governi tutti. Scegliere quello giusto dipende dal fatto se si sta lavorando con immagini, vettori tabulari, tile di mappe, array multidimensionali o nuvole di punti LiDAR.
1. GeoTIFF ottimizzato per il cloud (COG) — Per immagini raster
Un COG non è un tipo di file proprietario completamente nuovo; è un GeoTIFF standard (.tif) con una struttura interna rigorosa adottata come standard OGC ufficiale. Poiché rimane un GeoTIFF valido, gli strumenti desktop legacy come QGIS e ArcGIS possono ancora aprirlo senza problemi.
- Come funziona: Invece di memorizzare i pixel in linee di scansione orizzontali su tutta l’immagine, un COG organizza i pixel in tile interne (comunemente 512×512 pixel). Include anche overviews (piramidi di immagini a risoluzione inferiore pre‑calcolate) nello stesso file. Quando un utente effettua lo zoom out su una mappa web, il client recupera i tile di overview a bassa risoluzione; quando effettua lo zoom in, recupera solo i tile ad alta risoluzione che intersecano il viewport.
- Ideale per: Immagini satellitari, ortomosaici aerei, Modelli Digitali di Elevazione (DEMs) e server dinamici di tile raster (come TiTiler).
Generazione di un COG tramite GDAL:
gdal_translate input.tif output_cog.tif \
  -of COG \
  -co COMPRESS=DEFLATE \
  -co OVERVIEWS=IGNORE_EXISTING
2. GeoParquet — Per l’analisi vettoriale su larga scala e i data warehouse
Se il tuo flusso di lavoro assomiglia più all’ingegneria dei dati che alla cartografia tradizionale, GeoParquet (.parquet) è il protagonista. Basato su Apache Parquet, memorizza le geometrie come Well-Known Binary (WKB) standard ISO insieme a ricchi attributi tabulari.
- Come funziona: A differenza di Shapefile o GeoJSON, che memorizzano i dati riga per riga, Parquet è a colonne. Se esegui un’aggregazione sulla colonna
populationsu 50 milioni di poligoni, il motore salta completamente la lettura dei pesanti byte di geometria. GeoParquet incorpora anche metadati di bounding-box per gruppo di righe (e supporta l’ordinamento spaziale tramite curve di Hilbert o indici H3), consentendo ai motori di query di ignorare blocchi irrilevanti. - Ideale per: Analisi spaziali su larga scala, data warehouse cloud (Snowflake, BigQuery, Databricks) e motori SQL serverless come DuckDB.
Interrogazione di GeoParquet remoto direttamente con DuckDB:
INSTALL spatial;
LOAD spatial;

SELECT land_use, COUNT(*) AS parcel_count
FROM read_parquet('s3://example-bucket/parcels.parquet')
WHERE ST_Intersects(geometry, ST_MakeEnvelope(-122.5, 37.7, -122.3, 37.8))
GROUP BY land_use;
3. FlatGeobuf — Per lo streaming di funzionalità vettoriali sul web
Mentre GeoParquet brilla nei motori analitici, i suoi metadati basati sul piè di pagina e l’orientamento a colonna non sono sempre ideali per lo streaming di geometrie vettoriali grezze direttamente in una mappa del browser. Entra FlatGeobuf (.fgb).
- Come funziona: Basato sulla libreria di serializzazione binaria FlatBuffers di Google, FlatGeobuf posiziona un indice spaziale Hilbert R-tree compresso proprio all’inizio del file. I client web (come MapLibre GL JS, Leaflet o OpenLayers) possono eseguire una query di bounding-box tramite richieste HTTP range e iniziare a renderizzare le feature sullo schermo mentre i byte rimanenti sono ancora in streaming.
- Ideale per: Sostituire file GeoJSON da diversi megabyte nelle applicazioni web interattive senza avviare un backend PostGIS/GeoServer.
4. PMTiles — Per basemap vettoriali e raster senza server
Tradizionalmente, servire tile di mappe interattive (/{z}/{x}/{y}.pbf) richiedeva o l’esecuzione di un server di tile dedicato (come Martin o Tileserver-GL) o il caricamento di milioni di piccoli file .pbf individuali su S3—un incubo per la gestione dei bucket e i costi delle richieste API.
- Come funziona: Creato da Protomaps, PMTiles (
.pmtiles) raggruppa un’intera piramide di Mapbox Vector Tiles (MVT) o tile raster in un unico file di archivio. Utilizza una struttura di directory raggruppata ottimizzata per la località spaziale della curva di Hilbert, il che significa che una libreria di mappe per browser può recuperare le tile direttamente da un singolo file statico su S3 o Cloudflare R2 usando richieste HTTP range. - Ideale per: Basemap personalizzate senza backend, mappe web ad alto traffico e applicazioni di mappatura mobile offline.
5. Zarr — Per dati scientifici multidimensionali
NetCDF e HDF5 hanno dominato la meteorologia, l’oceanografia e la modellazione climatica per decenni, ma le loro strutture di file monolitiche faticano negli ambienti cloud distribuiti. Zarr reimmagina gli array N-dimensionali per l’archiviazione di oggetti.
- Come funziona: Un archivio Zarr suddivide enormi array multidimensionali (ad es.,
time × latitude × longitude × altitude) in piccoli blocchi compressi di dimensioni uniformi. Ogni blocco è memorizzato come un oggetto individuale (o consolidato tramite sharding Zarr v3) con metadati JSON che descrivono le dimensioni dell’array. Decine di worker paralleli possono leggere o scrivere diverse sezioni temporali simultaneamente senza conflitti di blocco dei file. - Ideale per: datacubi satellitari di serie temporali, previsioni meteo, modelli climatici e pipeline distribuite Xarray/Dask.
6. Cloud-Optimized Point Cloud (COPC) — Per LiDAR
Costruito come estensione del formato LiDAR compresso standard LAZ 1.4, COPC (.copc.laz) organizza nuvole di punti 3D in una struttura octree clusterizzata. Come COG, rimane retrocompatibile con i lettori LAS/LAZ esistenti consentendo ai visualizzatori web (come Potree o deck.gl) di trasmettere i punti in base al frustum della telecamera e al livello di dettaglio senza scaricare nuvole di punti multi-gigabyte.
Matrice decisionale per sviluppatori: quale formato scegliere?
| Tipo di Dati | Carico di lavoro principale | Formato migliore | Formato legacy sostituito |
|---|---|---|---|
| Raster / Immagini | Tiling dinamico, analisi dei pixel, visualizzazione web | COG (.tif) | GeoTIFF non indicizzato, JPEG2000 |
| Vettoriale | Analisi SQL, data warehouse, join massivi | GeoParquet (.parquet) | Shapefile, File Geodatabase |
| Vettoriale | Streaming di feature grezze direttamente a un browser | FlatGeobuf (.fgb) | Grande GeoJSON, KML |
| Tile predefinite | Mappe web interattive senza server e offline mobile | PMTiles (.pmtiles) | MBTiles, alberi di cartelle ZXY |
| Array N-D | Dati climatici, raster di serie temporali, calcolo parallelo | Zarr (.zarr) | NetCDF4, HDF5 |
| Nuvole di punti | Visualizzazione web 3D e sottoinsiemi spaziali LiDAR | COPC (.copc.laz) | Standard LAS / LAZ |
Insidie critiche quando si distribuisce in produzione
Passare a formati cloud-native semplifica il tuo backend, ma sposta la responsabilità della configurazione sul livello di storage cloud. Attenzione a questi tre errori comuni:
- Dimenticare le intestazioni CORS: Se un’applicazione browser (che utilizza MapLibre, OpenLayers o
geotiff.js) effettua una richiesta HTTP range al tuo bucket S3, la politica Cross-Origin Resource Sharing (CORS) del bucket deve consentire esplicitamente l’intestazioneRangeinAllowedHeadersed esporreContent-Range,Content-LengtheAccept-RangesinExposeHeaders. Senza ciò, le richieste falliranno silenziosamente nel browser. - Gruppi di righe GeoParquet non ordinati: Convertire un Shapefile disordinato direttamente in GeoParquet non renderà automaticamente veloci le query con bounding-box. Se le feature sono sparse casualmente tra i gruppi di righe, il motore di query deve comunque scansionare ogni gruppo di righe. Ordina sempre le tue geometrie spazialmente (ad esempio, usando una curva di Hilbert tramite
geopandasoDuckDBprima della scrittura) in modo che le feature spazialmente prossime vivano nello stesso gruppo di righe. - Dimensioni di chunk/tile subottimali: Piccoli chunk (ad es., 64×64 pixel) generano migliaia di richieste HTTP, aumentando la latenza e i costi delle API cloud. Chunk massivi (ad es., 4096×4096 pixel) costringono i client a scaricare dati in eccesso. Attieniti ai valori predefiniti standard—512×512 pixel per i COG e 10 MB a 100 MB per chunk per i gruppi di righe Zarr o GeoParquet.
Conclusioni
I formati di file GIS cloud-native rappresentano un cambiamento fondamentale dal spostare i dati al calcolo verso lo spostare il calcolo (e richieste di intervallo leggere) ai dati. Accoppiando formati come COG, GeoParquet, FlatGeobuf e PMTiles con i metadati STAC (SpatioTemporal Asset Catalog), gli sviluppatori possono costruire pipeline di mappatura e analisi su scala planetaria, resilienti, sopra un archivio statico a basso costo—non è necessario un pesante database spaziale.
Domande frequenti (FAQ)
Q1. Cosa rende un formato di file GIS "cloud-native"? Un formato è cloud-native quando combina un indice spaziale pre-caricato con tiling o chunking interno, consentendo ai client di recuperare piccoli sottoinsiemi geografici tramite richieste di intervallo HTTP senza scaricare l’intero file.
Q2. È necessario un server GIS dedicato per ospitare file COG, GeoParquet o PMTiles? No—puoi ospitarli su qualsiasi archivio statico standard che supporti richieste di intervallo HTTP, come AWS S3, Google Cloud Storage, Azure Blob Storage o Cloudflare R2.
Q3. Dovrei usare GeoParquet o FlatGeobuf per i miei dati vettoriali? Usa GeoParquet per query analitiche pesanti, motori SQL (come DuckDB) e data warehouse, e usa FlatGeobuf quando trasmetti direttamente al browser le feature vettoriali grezze.
Q4. Un Cloud-Optimized GeoTIFF (COG) è compatibile con il tradizionale software GIS desktop? Sì, perché un COG è semplicemente un GeoTIFF standard con tasselli interni e piramidi di overview, si apre senza problemi negli strumenti legacy come QGIS, ArcGIS Pro e GDAL.
Q5. In che modo PMTiles differisce da MBTiles? MBTiles si basa su un database SQLite (che richiede codice lato server per interrogare via web), mentre PMTiles organizza le tessere in un archivio statico che i browser web possono leggere direttamente tramite richieste HTTP range.
Vedi anche
Migliori Formati di File GIS per App Mobili
Formati di file GIS su FileFormat.com