Ultimo aggiornamento: 30 set, 2026
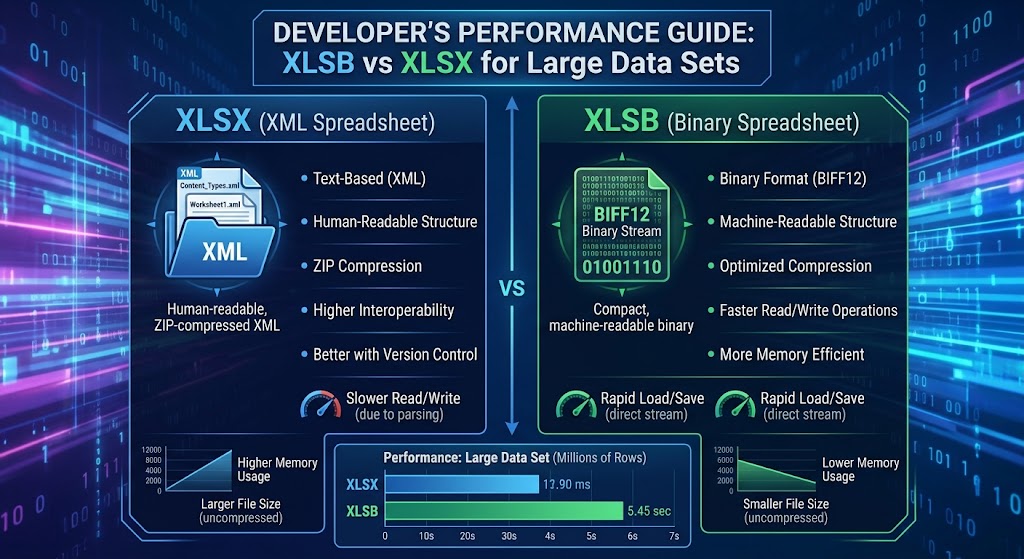
XLSB vs XLSX per Grandi Set di Dati: Guida alle Prestazioni per Sviluppatori
Se costruisci pipeline di dati, motori di reporting backend o strumenti di analisi che si interfacciano con Microsoft Excel, probabilmente hai incontrato "il muro".
Un utente carica una cartella di lavoro di 450.000 righe. Il tuo server avvia thread di lavoro, il consumo di memoria sale a diversi gigabyte, la garbage collection blocca il runtime e la tua esecuzione scade. Ispezioni il payload: è un file .xlsx standard.
Per risolvere questo, gli sviluppatori spesso trascorrono giorni implementando il chunking, parser in streaming o delegando i file a worker in background. Tuttavia, una delle ottimizzazioni più efficaci non richiede alcuna riprogettazione architetturale: cambiare l’estensione del file da .xlsx a .xlsb.
In questa guida, esploriamo a fondo entrambi i formati, esaminiamo perché le loro architetture interne producono caratteristiche di prestazione radicalmente diverse, confrontiamo benchmark concreti su Python e .NET, e delineiamo regole chiare su quando distribuire cartelle di lavoro binarie in produzione.
1. Dietro le quinte: OpenXML vs. BIFF12
Per capire perché le prestazioni divergono così drasticamente su grandi dataset, dobbiamo osservare come ogni formato memorizza i record su disco.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Sia i file .xlsx che i file .xlsb sono contenitori ZIP compressi conformi alle Open Packaging Conventions (OPC). Se rinomini uno dei file in .zip ed lo estrai, vedrai una struttura di directory familiare: _rels, docProps e xl/worksheets/.
La differenza fondamentale si trova all’interno della cartella xl/worksheets/:
- XLSX memorizza i fogli come testo XML semplice (
sheet1.xml). - XLSB memorizza i fogli come flussi binari proprietari (
sheet1.bin), codificati usando il BIFF12 di Microsoft (Binary Interchange File Format 12).
Come XLSX Codifica i Dati (Sovraccarico XML DOM)
In un foglio di lavoro XLSX, ogni cella è dichiarata con tag XML espliciti:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Durante la lettura di questa riga, il tuo runtime deve:
- Decomprimere il flusso raw deflate in testo.
- Tokenizzare e analizzare i caratteri della stringa in un DOM XML o in un flusso di eventi SAX.
- Convalida i tag di apertura e chiusura (
<c>,</c>,<v>,</v>). - Risolvi le ricerche di stringhe da una tabella separata
sharedStrings.xml. - Analizza il testo ASCII
"98234.55"in un numero a virgola mobile IEEE 754 a 64 bit.
Ogni singola cella comporta un overhead della CPU per l’analisi delle stringhe, l’allocazione delle stringhe e l’analisi lessicale. Moltiplicando questo per 500.000 righe e 30 colonne (15 milioni di celle), la CPU spende di gran lunga più cicli a analizzare la sintassi rispetto all’elaborazione dei valori di dominio.
Come XLSB Codifica i Dati (Flusso Binario BIFF12)
BIFF12 elimina completamente la serializzazione del testo. Invece del markup delle stringhe, i dati sono organizzati come una sequenza sequenziale di record binari a lunghezza variabile:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Una cella a virgola mobile in BIFF12 non utilizza rappresentazioni di stringa come "98234.55". È rappresentata direttamente:
- 2 byte per l’ID del record (ad es.,
BrtCellRkoBrtCellReal) - 4 byte per gli indici di colonna/riga
- 8 byte contenenti la struttura grezza a doppia precisione IEEE 754
Quando il tuo parser legge un file XLSB, evita completamente l’analisi lessicale. Legge l’intestazione del record, preleva gli 8 byte grezzi dal buffer, li copia direttamente in memoria e sposta il puntatore in avanti. Non ci sono tag da convalidare, nessuna conversione di tipo stringa‑numero e zero overhead di decodifica UTF‑8 per i dati numerici.
2. Benchmark Quantitativi: Disco, Memoria e Throughput
Per illustrare l’impatto nel mondo reale, considera un dataset simulato contenente 750.000 righe e 25 colonne (un mix di timestamp, numeri in virgola mobile, interi e codici di categoria).
I test seguenti valutano dati tabulari identici salvati sia come XLSX sia come XLSB.
Ambiente di Test
- CPU: AMD Ryzen 9 5900X (12 core, 24 thread)
- RAM: 64 GB DDR4‑3600
- Storage: PCIe 4.0 NVMe SSD
- Runtime: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Metriche Chiave di Prestazione
| Metrica | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Miglioramento |
|---|---|---|---|
| Dimensione del file su disco | 128.4 MB | 68.2 MB | ~47% più piccolo |
| Tempo di salvataggio / serializzazione | 42.6 s | 14.1 s | 3.0x più veloce |
| Tempo di lettura (parser DOM Python) | 38.2 s | 8.9 s | 4.3x più veloce |
| Tempo di lettura (motore Rust/C) | 6.4 s | 1.9 s | 3.3x più veloce |
| Allocazione massima dell’heap durante la lettura | ~1.85 GB | ~510 MB | ~72% di riduzione |
Perché i File XLSB Sono Più Piccoli
Mentre entrambi i formati utilizzano la compressione ZIP standard, i flussi binari comprimono molto più efficientemente rispetto al testo XML gonfio:
- La sintassi ridondante è eliminata: XML contiene tag ripetitivi (
<c r="AA1" s="1">) su ogni singolo record. Sebbene la compressione ZIP mitighi le stringhe ripetute, il flusso di dati non compresso è enorme. - Densità numerica: In XML, il numero
12345678.9012richiede 14 byte di testo ASCII. In BIFF12, è memorizzato come un double a 8 byte (o compattato in un recordRKa 4 byte se rientra in regole di precisione specifiche).
3. Impronta di Memoria e Pressione del Garbage Collection
Per i servizi web e i microservizi che gestiscono richieste concorrenti, la velocità della CPU è solo metà della battaglia; l’impronta di memoria è dove le applicazioni realmente falliscono.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Quando un parser XML elabora un file XLSX da 100 MB, deve creare migliaia di token di stringa effimeri, buffer di slice di stringa e ricerche nel dizionario. Nei linguaggi con garbage collection (Java, C#, Go, Node.js, Python), ciò genera una frammentazione estrema dell’heap e spinge il runtime verso frequenti pause di Garbage Collection (GC).
Poiché l’analisi XLSB opera direttamente su slice di byte a larghezza fissa, i parser possono leggere i dati in strutture allocate sullo stack o in buffer di byte riutilizzabili. Il risultato è un’impronta di memoria drasticamente ridotta e zero thrashing dell’allocatore di runtime.
4. Esempi di Implementazione per Sviluppatori
Esaminiamo come sfruttare XLSB nei comuni toolchain per sviluppatori.
Python: Migrazione da OpenPyXL a Calamine / PyXLSB
Lo standard pandas.read_excel('data.xlsx') utilizza per impostazione predefinita openpyxl, che costruisce un albero pesante in memoria.
Per elaborare file XLSB di grandi dimensioni alla massima velocità, utilizza il motore calamine basato su Rust (disponibile tramite python-calamine e integrato nei moderni Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Se stai iterando su enormi dataset riga per riga senza caricare l’intera matrice in un DataFrame, pyxlsb fornisce un iteratore di streaming leggero:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Ingestione di Stream ad Alte Prestazioni
In .NET, librerie come ClosedXML o EPPlus sono ottime per la generazione standard, ma per l’ingestione di file di grandi dimensioni senza esaurire la memoria, ExcelDataReader con supporto XLSB è eccezionalmente veloce:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Compromessi Architetturali: Quando NON usare XLSB
Nonostante i suoi vantaggi di prestazioni schiaccianti, XLSB non è una panacea. Dovresti valutare diversi compromessi operativi prima di adottarlo in tutto il tuo stack:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Supporto dell’Ecosistema e delle Librerie
- XLSX: Universale. Praticamente ogni linguaggio, libreria, strumento SaaS (Google Sheets, Airtable, Tableau) e parser web supportano OpenXML nativamente.
- XLSB: Meno diffuso. Sebbene Excel, LibreOffice e librerie per sviluppatori mature (
ExcelDataReader,pyxlsb,calamine,Aspose) lo supportino, molti pacchetti leggeri o parser JavaScript puramente basati sul web (come versioni più vecchie diSheetJS) hanno un supporto limitato o solo in lettura.
2. Git e Confronto delle Differenze nel Controllo di Versione
- XLSX: Poiché contiene XML di testo all’interno di un contenitore ZIP, le utility da riga di comando e i hook di Git possono decomprimere e formattare l’XML per generare diff strutturali leggibili tra i commit.
- XLSB: Dati binari puri. I sistemi di controllo versione lo trattano strettamente come un blob binario opaco, eliminando qualsiasi possibilità di diff granulari o merge a livello di riga.
3. Rendering del Client Web
Se la tua architettura si basa sul rendering di fogli di calcolo direttamente nel browser tramite WebAssembly o JavaScript lato client, i parser XLSX sono significativamente più maturi e meno soggetti a bug di rendering in casi limite rispetto ai parser binari lato client.
4. Pipeline di Ingestione di Terze Parti
Se stai esportando file per clienti aziendali esterni, molte politiche di sicurezza aziendale rigorose segnalano i file .xlsb. Poiché i file BIFF12 possono memorizzare macro VBA identicamente ai file .xlsm (senza richiedere un’estensione separata), alcuni filtri di posta e scanner dei firewall mettono in quarantena i caricamenti di .xlsb come potenziali minacce contenenti macro.
6. Confronto Riassuntivo: Quale Formato Vince?
| Caratteristica | XLSX | XLSB | Vincitore |
|---|---|---|---|
| Velocità di lettura / analisi | Da moderata a scarsa | Estremamente veloce | XLSB |
| Velocità di scrittura / generazione | Intensivo per CPU | Veloce | XLSB |
| Compressione file | Buono | Eccellente (~40-50% più piccolo) | XLSB |
| Allocazione di memoria | Elevata (Elevata pressione GC) | Bassa (Lettura diretta dei byte) | XLSB |
| Interoperabilità degli Strumenti | Universale | Elevata, ma selettiva | XLSX |
| Attrito nella Scansione di Sicurezza | Minimale | Falsi positivi occasionali | XLSX |
| Capacità delle Macro | No (.xlsm necessario) | Sì (Supporta le macro nativamente) | Pareggio |
7. Il Verdetto dello Sviluppatore
Usa XLSX quando:
- I file sono di dimensioni piccole‑medie (< 50.000 righe).
- I tuoi file devono essere ingeriti da piattaforme SaaS di terze parti o app consumer (ad es., Google Sheets).
- Non puoi controllare l’ambiente del cliente finale che legge il file.
Passa a XLSB quando:
- Stai creando pipeline interne, lavori batch, sistemi ETL o attività di lavoro che gestiscono estrazioni di dati massive (> 100.000 righe).
- I tuoi server stanno riscontrando errori di out-of-memory (OOM) durante la serializzazione o deserializzazione dei fogli di calcolo.
- Devi ridurre al minimo l’impronta di archiviazione S3/blob e il tempo di transito di rete per grandi modelli finanziari ricorrenti o esportazioni di dati.
Il passaggio a XLSB è spesso semplice come cambiare una stringa di configurazione nel tuo servizio di esportazione, ma offre guadagni di throughput da 3x a 5x che normalmente richiederebbero settimane di ottimizzazione del codice.
Domande frequenti (FAQ)
**Q1: Un file XLSB supporta gli stessi limiti di righe e colonne di un file XLSX? Sì; sia XLSB che XLSX condividono lo stesso limite di griglia di 1.048.576 righe per 16.384 colonne per foglio di lavoro.
**Q2: Un file XLSB può memorizzare in modo sicuro macro VBA senza cambiare la sua estensione?
Sì, a differenza di XLSX (che richiede il salvataggio come XLSM per eseguire il codice), XLSB supporta nativamente la memorizzazione binaria delle macro VBA all’interno dello stesso formato file .xlsb.
**Q3: Perché salvare un file come XLSB ne riduce le dimensioni se entrambi i formati sono già compressi ZIP? XLSB elimina i tag di markup testuali verbosi e codifica le posizioni delle celle, i record e i valori numerici grezzi in flussi di byte binari compatti che comprimono molto più densamente rispetto alle semplici stringhe XML.
**Q4: Google Sheets può importare e modificare direttamente i file XLSB?
No; Google Sheets non può aprire o convertire nativamente i file .xlsb direttamente, richiedendo di convertirli in .xlsx o CSV prima dell’importazione.
**Q5: I file XLSB sono più soggetti a corruzione dei dati rispetto ai file XLSX? Mentre i file XML a volte possono essere ispezionati o riparati manualmente con un editor di testo quando sono parzialmente corrotti, i flussi binari BIFF12 richiedono offset di byte rigorosi e sono difficili da recuperare manualmente se i settori strutturali sono danneggiati.