最終更新日: 2026年8月20日
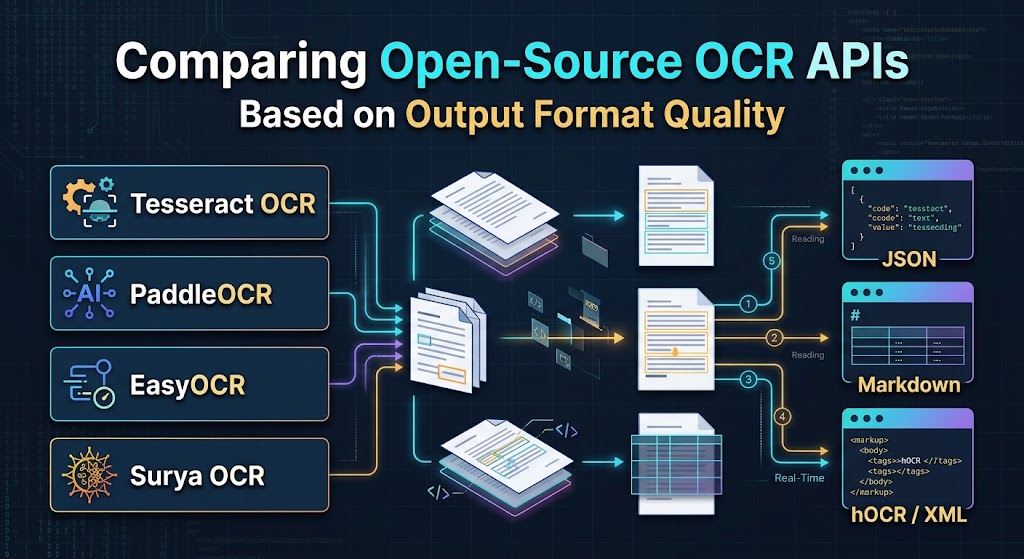
出力形式の品質に基づくオープンソースOCR APIの比較
エンジニアが光学文字認識(OCR)エンジンを評価する際、文字エラー率(CER)と単語エラー率(WER)が通常ベンチマークを支配します。認識精度は重要ですが、実運用では問題の半分しか解決しません。
複雑な多列 PDF を解析したり、領収書から項目を抽出したり、ホワイトペーパーを LLM 埋め込みパイプラインに取り込んだりする場合、生のテキストダンプは膨大なエンジニアリング負荷を生みます。レイアウト認識や論理的な読取順序、座標データがない文字列は、チームに脆弱なヒューリスティックパーサーの作成を強いることになります。
現代の文書ワークフローにおける真の差別化要因は 出力フォーマットの品質 です。エンジンが座標、読取順序、構造階層、テーブルデータをどれだけ一貫してクリーンに提供できるかがポイントです。
以下は、4つの主要な オープンソース OCR エンジン—Tesseract、PaddleOCR、EasyOCR、Surya OCR—のエンジニアリング志向の比較であり、これらの出力が自動化パイプライン内でどのように機能するかを評価しています。
一般的な出力形式:エンジニアが実際に必要とするもの
すべての OCR API は検出されたテキストを異なる形式でパッケージ化します。これらのフォーマットを理解することで、パイプラインが必要とするポストプロセッシングの量を判断できます:
- Plain Text (
.txt): 最もシンプルな表現です。位置メタデータをすべて除去し、マルチカラムレイアウトを横方向の読み取りに統合するため、段落が乱れることがあります。 - Archival Standards (
hOCR,ALTO XML): 図書館のアーカイブで標準となっている XML/HTML ベースのフォーマットです。座標、フォント推定、信頼度評価を DOM ノード内に埋め込みます。文書再構築には非常に堅牢ですが、マイクロサービスには重量があります。 - Structured JSON: 現代のウェブバックエンドでデフォルトの選択肢です。座標配列(バウンディングボックスまたはポリゴン)、信頼度評価、階層的なブロック/行/単語構造を提供します。
- Markdown (
.md) / HTML Tables: Retrieval-Augmented Generation (RAG) の現代標準です。下流での空間再構築を必要とせず、セマンティックなセクション(ヘッダー、リスト、太字テキスト)や表形式のマトリックスを保持します。
1. Tesseract OCR
Google がメンテナンスしている Tesseract は、オープンソース OCR の基礎的な主力エンジンであり続けています。そのアーキテクチャは、従来のページ分割アルゴリズムに大きく依存し、LSTM ベースの文字エンジンで補完されています。
ネイティブ出力フォーマット
- 主な出力: プレーンテキスト、hOCR(HTML)、ALTO XML、TSV(タブ区切り値)、および検索可能な PDF/A。
- レイアウト認識: ページ分割モード(PSM)によるルールベースのヒューリスティック。
出力フォーマット分析
- 優れている点: Tesseract の
TSVとhOCRエクスポートは標準化されており予測可能です。単一の TSV エクスポートはlevel、page_num、block_num、par_num、line_num、word_num、left、top、width、height、confの構造化された列を返します。紙のアーカイブを検索可能な PDF に変換する場合や、機関の標準に厳密に従う必要がある場合、Tesseract はカスタムの接着コードなしでこれをネイティブに処理します。 - 欠点: Tesseract にはネイティブの JSON API がありません。その出力を Python や Node.js で利用するには XML/TSV ファイルの解析または
pytesseractのようなラッパーの使用が必要です。また、レイアウトエンジンは非標準的な列フローに苦労し、手動でバウンディングクロップを提供しない限り、隣接列からのテキストが頻繁に混在します。
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
百度の PaddlePaddle フレームワークを基盤とし、PaddleOCR は軽量モデル、広範な多言語対応、専用の文書解析ツールキット(PP-Structure)により広く採用されています。
ネイティブ出力フォーマット
- 主な出力: Python リスト/辞書、raw JSON、可視化オーバーレイ、そして PP-Structure を介した構造化 HTML。
- レイアウト認識: 高 (レイアウト解析、向き分類、テーブル復元のためにディープラーニングモデルを使用)。
出力フォーマット分析
- 優れた点: 標準の PaddleOCR は、テキスト文字列と信頼度スコアと共に、4点ポリゴン座標(
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]])を返します。これにより、傾いたテキストや曲がったテキストもスムーズに処理できます。しかし、実際の強みは PP-Structure スイートにあり、レイアウト領域(タイトル、テキスト、テーブル、図)を検出し、テーブルを直接有効な HTML 文字列(<table>...</table>)に解析します。これにより、バウンディングボックスからセルのスパンを手動で計算する必要がなくなります。 - 欠点: 基本 API は、バージョン間で標準的なプロパティキーが欠如したネストされた配列を返します。構造化アプリケーションでは、開発者は通常、フィールド名(
bbox、text、confidence)を標準化する中間アダプタを書きます。
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
JaidedAI によって PyTorch 上に構築された EasyOCR は、開発者の迅速な採用を目的としています。テキスト検出のための CRAFT(Character Region Awareness for Text Detection)とディープラーニング認識ネットワークを最小限の API にパッケージ化しています。
ネイティブ出力フォーマット
- 主な出力: Pythonリストは座標のタプル、認識された文字列、信頼度の値を含みます。
- レイアウト認識: 低〜中程度(テキスト行検出のみ;文書レベルの構造解析はなし)。
出力フォーマット分析
- 優れている点: 返却オブジェクトのシンプルさは他に類を見ません:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
この出力を標準的なRESTレスポンスにマッピングしたり、直接GeoJSON/カスタムスキーマにシリアライズしたりするには、数行のコードで済みます。自然シーンのテキスト、ナンバープレート、そして切り出した文書画像でも信頼性高く動作します。
- 欠点: EasyOCRは包括的な文書レイアウト解析を行いません。テーブルや見出し階層、複雑なカラム間の読順を識別しません。二段組の学術論文にEasyOCRを使用すると、上流のレイアウト検出モデル(YOLOやLayoutLMなど)と組み合わせない限り、テキストが交錯したスニペットになることがよくあります。
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya は、複雑な文書理解とLLMインジェストパイプライン向けに特別に設計された最新のディープラーニングOCRフレームワークです。
ネイティブ出力フォーマット
- 主な出力: Pydanticでモデル化されたJSON構造、論理的な読順インデックス、レイアウトのバウンディング領域、そして行検出ポリゴン。
- レイアウト認識: 非常に高い(ディープラーニングベースのレイアウト分析と読み順ソート)。
出力フォーマット分析
- 優れた点: Suryaは、最新のAIエンジニアリングの課題に直接対応します。文書が上から下へ、左から右へ読むと仮定する代わりに、Suryaはreading orderを予測する専用モデルを展開します。行を論理的なセマンティックブロックにグループ化し、マルチカラムの跨りを自然に処理し、Pydanticを介して型付けされた構造を出力します。これにより、ベクトルデータベースやMarkdownコンバータへの下流取り込みが直接的かつ信頼性の高いものになります。
- 課題点: 新しく、重いPyTorchベースのフレームワークとして、SuryaはTesseractや量子化されたPaddleモデルのような最適化されたC++エンジンのスループットに匹敵するために、専用GPU計算が必要です。hOCRやALTOといったレガシーなアーカイブ標準は対象としていません。
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
ヘッドツーヘッド比較マトリックス
| 機能 / フォーマット | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| ネイティブ hOCR / ALTO XML | ネイティブサポート | サードパーティのみ | なし | なし |
| バウンディングボックスジオメトリ | 軸に沿った (x, y, w, h) | 4点ポリゴン | 4点ポリゴン | ポリゴン + レイアウトブロック |
| テーブル解析 | 座標 TSV のみ | HTML テーブル文字列 | なし | セル座標グリッド |
| 読み順検出 | ルールベース(マルチカラムでブレーク) | ML レイアウト分析 | 基本的な行グループ化 | 専用の読み順モデル |
| 直接JSONスキーマ | 変換が必要 | Python辞書 / JSON | Pythonリスト / JSON | 型付きPydanticモデル |
| 理想的な下流ターゲット | アーカイブPDF、レガシーDMS | フォーム/領収書データ、ERP | クイックスクリプト、シーンテキスト | LLMインジェスト、RAGアーキテクチャ |
パイプラインの推奨: どれを選ぶべきですか?
- Tesseractを選択 すると、コンプライアンス要件が政府やアーカイブ記録向けに標準化された
hOCR、ALTO XML、または検索可能な PDF/A の成果物を必要とする場合に適しています。 - PaddleOCRを選択 すると、複雑で枠のないテーブルを含む運用上の財務文書(請求書、領収書、税務フォーム)を処理し、HTMLやスプレッドシートに変換する必要がある場合に適しています。
- EasyOCRを選択 すると、設定の手間なく、自然画像、道路標識、または切り取られた UI 要素からテキストを検出・抽出できる軽量で Python ライクなライブラリが必要な場合に適しています。
- Surya OCRを選択 すると、非構造化のビジネスレポート、研究論文、技術ガイドを LLM やベクトル検索エンジンに投入し、論理的な読順と明確な構造境界が最重要となる場合に適しています。
よくある質問 (FAQ)
1. オープンソースOCR出力フォーマットのうち、どれが大規模言語モデルに最も簡単に入力できますか?
Surya OCR の読順認識 JSON と PaddleOCR の PP-Structure の HTML テーブルは、LLM のプロンプトコンテキストおよび RAG インデックス作成に最もクリーンな表現を提供します。
2. TesseractはサードパーティツールなしでネイティブにJSON応答を生成できますか?
いいえ、Tesseractはテキスト、TSV、PDF、hOCR/ALTO XMLをネイティブに出力します;JSONを生成するには、TSVまたはhOCRの出力を中間パーサーで変換する必要があります。
3. 4点ポリゴン座標は軸に平行なバウンディングボックスとどのように異なりますか?
軸に平行な矩形は平坦なテキストを前提に [x, y, width, height] を使用しますが、4点ポリゴンは4組の座標ペアを提供し、回転したり歪んだり曲がったテキスト行を正確に囲みます。
4. どのエンジンが緩い座標ではなく、テーブル構造を直接コードに出力しますか?
PaddleOCRのPP-Structureモジュールは検出されたテーブル境界を完全なHTMLテーブルタグ(<table>、<tr>、<td>)に再構築し、独自の空間計算を回避します。
5. 標準的な EasyOCR の出力が多列の学術論文でうまく機能しない理由は何ですか?
EasyOCRはグローバルなレイアウト階層ではなくローカルな近接性に基づいてテキスト行を識別するため、外部のレイアウトエンジンで制限しない限り、隣接する列のテキストが交錯してしまいます。