最終更新日: 2026年8月20日
歴史的および手書き文書のためのOCRファイル形式
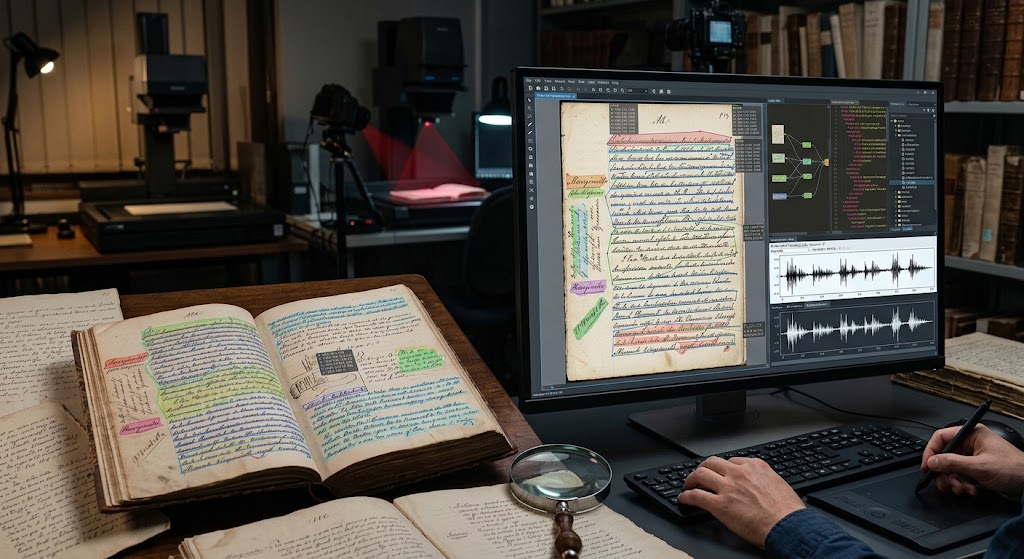
デジタル化による文化遺産の保存はルネサンスに突入しています。初期の光学文字認識(OCR)システムは、清潔で機械印刷された20世紀の書類を解析するよう設計されていましたが、現代の文化遺産機関ははるかに混沌として豊かな課題に直面しています:中世の写本、19世紀の筆記体の書簡、脆い装飾写本、そして何世紀も前のレジストリです。
歴史的文書の転写は、もはや単にプレーンな ASCII テキストを抽出するだけではありません。コンテキスト—ページの物理的ジオメトリ、ベースライン曲線、裏写り補正、余白注、略語、そして古文字学的な不確実性—を捉える必要があります。この専門分野は、しばしば手書き文字認識(HTR)に分類され、画像座標とテキスト層の両方を保存・交換するために使用されるファイル形式に大きく依存しています。
誤ったスキーマを選択すると、重要なベースラインデータが失われ、IIIF(International Image Interoperability Framework)マニフェストとの整合性が崩れ、長期的なデジタル保存が妨げられる可能性があります。ここでは、歴史的文書向けの主要な OCR および HTR ファイル形式、その構造的な強み、そしてアーカイブパイプラインに最適な選択を判断する方法についての決定的なガイドを紹介します。
歴史的ジレンマ:なぜプレーンテキストと標準的なPDFが失敗するのか
機械印刷された OCR は、シンプルな .txt ファイルやスキャンの下に隠しテキスト層を持つ “sandwich” PDF を出力することが多いです。歴史的写本や筆記体の手書きに対しては、これらの出力は次の 3 つの根本的な理由で失敗します:
- 非線形テキストと複雑なレイアウト: 歴史的な写本家は整然とした長方形のグリッドに従わなかった。テキストは余白に流れ込み、装飾されたイニシャルの周りを回り、挿入された行間訂正の間を織り交ぜ、または背表紙に沿って垂直に走る。
- 曲線的かつ斜めのベースライン: 手書き文字は硬直した水平軸に従うことはほとんどない。Transkribus、Kraken、eScriptorium などの HTR エンジンは、リガチャが多いスクリプトを解釈するために、バウンディングボックスではなくポリラインベースラインに依存している。
- 古文字学的複雑性とメタデータ: アーカイブ研究では、略語、歴史的な綴りの変化、損傷した読取、行レベルの信頼度スコアを追跡する必要がある。標準的な文書フォーマットはこの粒度を破棄してしまう。
元の遺物への忠実性を保つために、アーカイブコミュニティは転写テキストと共にレイアウトトポロジーを保存するよう設計された構造化 XML スキーマに依存している。
1. PAGE XML: 手書き文字認識(HTR)のゴールドスタンダード
PRImA(パターン認識&画像解析)研究所が開発した PAGE XML(Page Analysis and Groundtruth Elements)は、手書き文字認識と高度なレイアウト分析のための最先端フォーマットとして広く認識されている。
コアアーキテクチャ
PAGE XML は物理文書を階層構造として扱う:
PcGts(ルート)Page(画像の寸法と全体の読順)TextRegion(段落、見出し、余白注、キャッチワード)TextLineCoords(ライン周囲のポリゴン座標)Baseline(文字の実際のベースラインに沿った点の列)TextEquiv(認識されたテキスト、オプションで信頼度メトリクス付き)
歴史的写本において優れている理由
- ポリゴンとポリラインの精度: 文字を矩形のバウンディングボックスに強制的に入れる代わりに、PAGE XML は複数点のポリゴン境界と連続したベースラインを使用します。これにより、重なり合う筆記体の上昇部や下降部がセグメンテーションの妨げになるのを防ぎます。
- 細分化された構造タイプ: 領域は正確に分類できます(例:
marginalia、drop-capital、signature-mark、header、editorial-note)。 - 広範なソフトウェアエコシステム: これは、Transkribus、eScriptorium、Kraken のような主要な HTR プラットフォーム向けの、内部およびエクスポート用の主要スキーマとして機能します。
2. ALTO XML: 図書館とアーカイブのパワーハウス
ALTO (Analyzed Layout and Text Object) は、米国議会図書館が管理するオープン XML 標準であり、フランス国立図書館 (BnF) や大英図書館など、国立図書館で広く採用されています。
コアアーキテクチャ
ALTO はレイアウトを階層的に Page から PrintSpace、さらに TextBlock、TextLine、String(個々の単語またはトークン)へと構造化します。構造メタデータを高解像度のマスタ画像と結び付けるために、METS(Metadata Encoding and Transmission Standard)ラッパー内に頻繁にパッケージ化されます。
主な強みと使用例
- 大量デジタル化ワークフロー: ALTO は産業規模の新聞や書籍のデジタル化を念頭に設計されています。フォント属性、単語レベルの座標、文字の信頼度、空白を明確にエンコードします。
- モダンHTRサポート (ALTO 4): ALTOの以前のバージョンは、矩形座標(
HPOS、VPOS、WIDTH、HEIGHT)に大きく依存していました。しかし、ALTOバージョン4からは、スキーマが<Shape>ポリゴンとポリラインベースラインを導入し、手書き資料向けのPAGE XMLとの機能的ギャップを埋めました。 - 長期保存: 国際的な図書館コンソーシアムに裏付けられた公式標準であるため、ALTOは長期的な安定性とアーカイブレベルの下位互換性を保証します。
3. hOCR:Webファーストで軽量な標準
Thomas Breuelによって作成されたhOCRは実用的なアプローチを取ります: 全く新しいXMLスキーマを作成する代わりに、マイクロフォーマットとクラス属性を使用して、レイアウトと転写メタデータをセマンティックHTML/XHTMLに直接埋め込みます。
典型的な構文例
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">冒頭</span>
      </span>
    </p>
  </div>
</div>
歴史資料の長所と短所
- 利点: ブラウザはネイティブにレンダリングできます。バニラCSSとJavaScriptを使用して簡単に変換でき、Tesseractのようなエンジンのデフォルト構造化エクスポート形式です。
- 欠点: 複雑で自由形状の多点ベースライン曲線に対するネイティブサポートは限定的です。初期の印刷物(インキュナブラやクリーンブロードサイド)には実用的ですが、hOCRは不規則な手稿レイアウトや多層の余白注釈に苦労します。
4. TEI-XML:学術・デジタル人文科学のベンチマーク
Text Encoding Initiative (TEI) フォーマットは、厳密には OCR エンジンの出力形式ではなく、むしろ文学的・歴史的テキストの批判的デジタル版および学術的表現のための最高標準です。
OCR/HTR と TEI の接続
最新のパイプラインは、単なる文字認識で止まることはほとんどありません。学者は Transkribus TEI Exporter や自動化された XSLT パイプラインなどのツールを使用して、PAGE XML や ALTO ファイルを TEI 準拠の XML に変換します:
- 省略形は展開されます (
<choice><abbr>...</abbr><expan>...</expan></choice>). - 削除、追加、筆者の手は正式に分類されます (
<add>,<del>,<handShift>). - レイアウトデータは、
<facsimile>と<surface>要素を通じて文学分析と共に保存されます。
歴史的プロジェクトでインタラクティブな批判的版や意味的に検索可能な学術アーカイブを作成することが目的であれば、OCR/HTR データを TEI-XML に変換することがしばしば必要な最終ステップとなります。
比較マトリックス:OCR/HTR フォーマットの概要
| 機能 / 基準 | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| 主要ドメイン | 筆記体 HTR と手稿 | 大規模図書館デジタル化 | Web OCR と軽量検索 | 学術的批評版 |
| ベースラインサポート | ネイティブ、マルチポイント ポリライン | サポート (v4.0 以降) | 基本 (勾配/オフセット) | ファクシミリ マッピング経由 |
| 不規則ポリゴン | フル | フル | 限定 | 座標要素経由 |
| ツールエコシステム | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, Webビューア | Oxygen, TEI Publisher |
| 標準化団体 | PRImA Group / Open | 米国議会図書館 | コミュニティ仕様 | TEIコンソーシアム |
実践的な推奨事項:アーカイブパイプラインの選択
効率的で将来に備えたデジタル化パイプラインを構築するために:
- 純粋な手書き原稿とアーカイブ向け: 転写とレイアウト抽出を PAGE XML で標準化しましょう。そのベースライン計算とポリゴン輪郭は、非標準的な筆跡でもデータ損失を最小限に抑えて処理します。
- 大規模図書館および混合コレクション向け: ALTO XML (v4.2 以上) と METS を組み合わせて選択してください。これにより、標準的なデジタルリポジトリアーキテクチャやデジタル資産管理システム(DAMS)へのシームレスな統合が保証されます。
- ウェブプレゼンテーションと全文検索インデックス向け: hOCR を使用するか、PAGE XML から軽量な GeoJSON/Web Annotation 構造を派生させて、インタラクティブな IIIF ビューア(Mirador や Universal Viewer など)でライブのブラウザ内テキストオーバーレイを実現してください。
- 学術版と古文字学研究のために: PAGE XMLでグラウンドトゥルースを生成し、認識を実行し、出力を自動コンバータに通して編集用マークアップのための TEI-XML を生成します。
これらのフォーマットの構造的機能を資料の古文字学的要求に合わせることで、すべての筆跡、略字、歴史的ニュアンスが今後何世紀にもわたって解読可能であることを保証します。
よくある質問 (FAQ)
Q1. 標準OCRとHTRの根本的な違いは何ですか? OCRは一貫した機械印刷のタイポグラフィを認識しますが、HTR(手書き文字認識)はディープニューラルネットワークを利用して、連続的で可変な人間の手書きと曲線のベースラインをデコードします。
Q2. Tesseract OCRは歴史的文書のためにPAGE XMLまたはALTO出力を生成できますか? はい、TesseractはネイティブのALTO XMLとhOCR出力を生成でき、サードパーティのラッパーを使用してこれらの結果をPAGE XMLに変換できます。
Q3. 手書き文字の転写において、ベースラインはなぜバウンディングボックスより重要なのですか? ベースラインは人間の筆跡の自然で波打つ線を追跡し、ソフトウェアが硬直したバウンディングボックス内で衝突する重なり合う上昇部と下降部を分離できるようにします。
Q4. IIIF 標準はこれらの OCR ファイル形式とどのように連携しますか? IIIF はオープンウェブ API を通じて高解像度画像を提供し、ALTO や PAGE XML のような形式は座標データを提供し、IIIF コンテンツ検索アノテーションに変換できます。
Q5. どのファイル形式が検索可能な PDF に直接変換するのが最も簡単ですか? hOCR と ALTO XML の両方は、元のページ画像と組み合わせて、OCRmyPDF のようなツールを使用して検索可能な二層 PDF ファイルを作成できます。