마지막 업데이트: 2026년 8월 20일
역사적 및 손글씨 문서를 위한 OCR 파일 형식
디지털화를 통한 문화유산 보존이 르네상스를 맞이했습니다. 초기 광학 문자 인식(OCR) 시스템은 깨끗하고 기계 인쇄된 20세기 문서를 분석하도록 설계되었지만, 현대 문화유산 기관들은 훨씬 더 복잡하고 풍부한 도전에 직면하고 있습니다: 중세 필사본, 19세기 필기 서신, 부서지기 쉬운 채색 사본, 그리고 수세기 된 기록들.
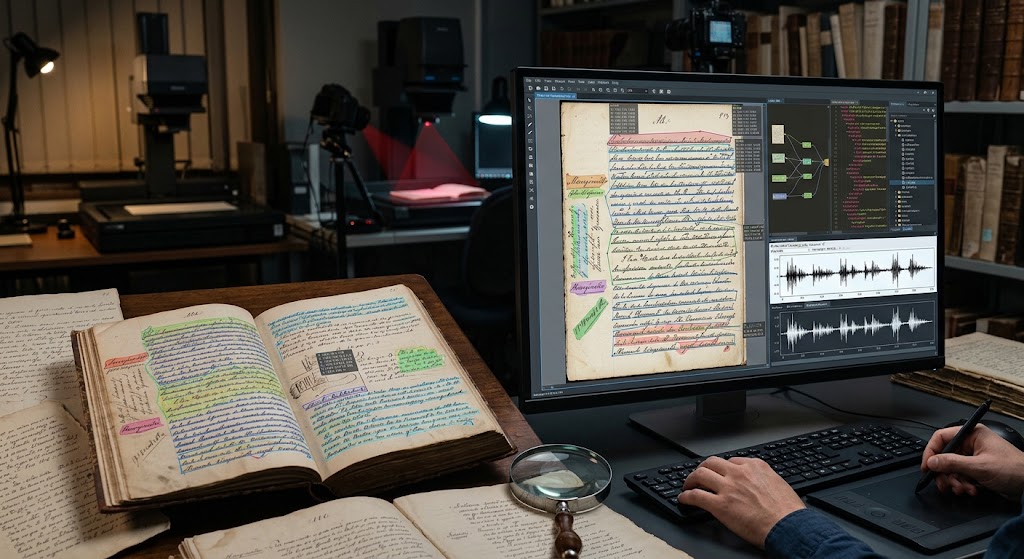
역사 문서를 전사하는 것은 이제 단순히 평범한 ASCII 텍스트를 추출하는 것만이 아닙니다. 페이지의 물리적 기하학, 기준선 곡선, 누출 보정, 여백 주석, 약어, 그리고 고문서학적 불확실성 등 context—을 포착해야 합니다. 이 전문 분야는 종종 손글씨 텍스트 인식(Handwritten Text Recognition, HTR)으로 분류되며, 이미지 좌표와 텍스트 레이어를 모두 저장하고 교환하는 파일 형식에 크게 의존합니다.
잘못된 스키마를 선택하면 중요한 기준선 데이터가 사라지고, IIIF (International Image Interoperability Framework) 매니페스트와의 정렬이 깨지며, 장기 디지털 보존을 방해할 수 있습니다. 여기에는 역사 문서를 위한 주요 OCR 및 HTR 파일 형식, 각 형식의 구조적 강점, 그리고 아카이브 파이프라인에 적합한 선택을 결정하는 방법에 대한 확정적인 가이드가 있습니다.
역사적 딜레마: 왜 일반 텍스트와 표준 PDF가 실패하는가
기계 인쇄 OCR은 종종 간단한 .txt 파일이나 스캔 아래에 숨겨진 텍스트 레이어가 있는 “sandwich” PDF를 출력합니다. 역사적 원고와 필기체 손글씨의 경우, 이러한 출력은 세 가지 핵심 이유로 실패합니다:
- 비선형 텍스트와 복잡한 레이아웃: 역사적인 서기들은 깔끔한 직사각형 격자에 얽매이지 않았습니다. 텍스트는 여백으로 흐르고, 장식된 이니셜 주위를 감싸며, 삽입된 행간 교정 사이를 엮고, 혹은 책등을 따라 수직으로 흐릅니다.
- 곡선 및 기울어진 기준선: 필기체는 드물게 고정된 수평 축을 따릅니다. Transkribus, Kraken, eScriptorium과 같은 HTR 엔진은 결합문자가 많은 스크립트를 해석하기 위해 경계 상자보다 폴리라인 기준선에 의존합니다.
- 고문서학적 복잡성 및 메타데이터: 아카이브 연구는 약어, 역사적 철자 변형, 손상된 판독, 그리고 행 수준 신뢰도 점수를 추적해야 합니다. 표준 문서 형식은 이러한 세부 정보를 버립니다.
원본 유물에 대한 충실성을 유지하기 위해, 아카이브 커뮤니티는 전사된 텍스트와 함께 레이아웃 토폴로지를 보존하도록 설계된 구조화된 XML 스키마에 의존합니다.
1. PAGE XML: 손글씨 텍스트 인식을 위한 최고 표준 (HTR)
PRImA (Pattern Recognition & Image Analysis) 연구실에서 개발한 PAGE XML (Page Analysis and Groundtruth Elements)은 손글씨 텍스트 인식 및 고급 레이아웃 분석을 위한 최첨단 형식으로 널리 인정받고 있습니다.
핵심 아키텍처
PAGE XML은 물리적 문서를 계층 구조로 취급합니다:
PcGts(루트)Page(이미지 차원 및 전체 읽기 순서)TextRegion(단락, 제목, 여백 주석, 캣치워드)TextLineCoords(선 주위의 폴리곤 좌표)Baseline(스크립트의 실제 기준선에 따라 이어지는 일련의 점)TextEquiv(인식된 텍스트, 선택적 신뢰도 메트릭 포함)
역사적 원고에 탁월한 이유
- 다각형 및 폴리라인 정밀도: 문자를 직사각형 경계 상자에 강제로 넣는 대신, PAGE XML은 다점 다각형 경계와 연속 기준선을 사용합니다. 이는 겹치는 필기체 상승선과 하강선이 세분화에 방해가 되는 것을 방지합니다.
- 세분화된 구조 유형: 영역은 정확하게 분류될 수 있습니다 (예:
marginalia,drop-capital,signature-mark,header,editorial-note). - 광범위한 소프트웨어 생태계: 이는 Transkribus, eScriptorium, Kraken과 같은 대표적인 HTR 플랫폼을 위한 기본 내부 및 내보내기 스키마 역할을 합니다.
2. ALTO XML: 도서관 및 아카이브의 핵심 엔진
**ALTO (Analyzed Layout and Text Object)**는 미국 의회도서관이 유지 관리하는 개방형 XML 표준이며, 프랑스 국립도서관(BnF)과 영국 도서관을 포함한 여러 국가 도서관에서 널리 채택되고 있습니다.
핵심 아키텍처
ALTO는 레이아웃을 Page에서 PrintSpace로, 그리고 TextBlock, TextLine, String(개별 단어 또는 토큰)까지 계층적으로 구조화합니다. 구조 메타데이터를 고해상도 원본 이미지와 연결하기 위해 METS(Metadata Encoding and Transmission Standard) 래퍼 안에 자주 패키징됩니다.
핵심 강점 및 활용 사례
- 대량 디지털화 워크플로우: ALTO는 산업 규모의 신문 및 도서 디지털화를 염두에 두고 설계되었습니다. 글꼴 속성, 단어 수준 좌표, 문자 신뢰도 및 공백을 깔끔하게 인코딩합니다.
- 현대 HTR 지원 (ALTO 4): ALTO의 이전 버전은 직사각형 좌표(
HPOS,VPOS,WIDTH,HEIGHT)에 크게 의존했습니다. 하지만 ALTO 버전 4부터는 스키마가<Shape>다각형과 폴리라인 기준선을 도입하여 손필기 자료에 대한 PAGE XML과의 기능 격차를 메웠습니다. - 장기 보존: ALTO는 국제 도서관 연합이 지원하는 공식 표준이기 때문에 장기적인 안정성과 아카이브 수준의 역호환성을 보장합니다.
3. hOCR: 웹 우선, 경량 표준
Thomas Breuel이 만든 hOCR는 실용적인 접근 방식을 취합니다: 완전히 새로운 XML 스키마를 만들기보다는 마이크로포맷과 클래스 속성을 사용하여 레이아웃 및 전사 메타데이터를 의미론적 HTML/XHTML에 직접 삽입합니다.
전형적인 구문 예시
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class=\"ocr_line\" id=\"line_1_1\" title=\"bbox 150 320 2200 410; baseline 0 -5\">\n        <span class=\"ocrx_word\" id=\"word_1_1\" title=\"bbox 150 325 380 405; x_wconf 92\">시작</span>\n      </span>
    </p>
  </div>
</div>
역사 자료의 장단점
- 장점: 브라우저가 이를 기본적으로 렌더링할 수 있습니다. 일반 CSS와 JavaScript를 사용해 쉽게 변환할 수 있으며, Tesseract와 같은 엔진의 기본 구조화된 내보내기 형식입니다.
- 단점: 복잡하고 자유형 다점 기준선 곡선에 대한 기본 지원이 제한적입니다. 초기 인쇄물(인쿠나불라 또는 깔끔한 대형 인쇄물)에는 실용적이지만, hOCR는 불규칙한 원고 레이아웃과 다층 주석에 어려움을 겪습니다.
4. TEI-XML: 학술 및 디지털 인문학 기준
Text Encoding Initiative (TEI) 형식은 엄격히 OCR 엔진 출력 형식이 아니라, 문학 및 역사 텍스트의 비평 디지털 판과 학술적 표현을 위한 최고의 표준입니다.
OCR/HTR을 TEI와 연결하기
현대 파이프라인은 원시 문자 인식 단계에서 거의 멈추지 않습니다. 학자들은 Transkribus TEI Exporter와 같은 도구나 자동화된 XSLT 파이프라인을 사용하여 PAGE XML 또는 ALTO 파일을 TEI 호환 XML로 변환합니다:
- 약어는 확장됩니다 (
<choice><abbr>...</abbr><expan>...</expan></choice>). - 삭제, 추가, 그리고 필사자 손은 공식적으로 분류됩니다 (
<add>,<del>,<handShift>). - 레이아웃 데이터는
<facsimile>및<surface>요소를 통해 문학 분석과 함께 보존됩니다.
귀하의 역사 프로젝트가 인터랙티브 비평 판이나 의미론적으로 검색 가능한 학술 아카이브를 만드는 것을 목표로 한다면, OCR/HTR 데이터를 TEI-XML로 변환하는 것이 종종 필요한 최종 단계입니다.
비교 매트릭스: OCR/HTR 형식 한눈에 보기
| 기능 / 기준 | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| 주요 도메인 | 필기체 HTR 및 원고 | 대규모 도서관 디지털화 | 웹 OCR 및 라이트 검색 | 학술 비평 판본 |
| 기본 지원 | 네이티브, 다중점 폴리라인 | 지원 (v4.0부터) | 기본 (경사/오프셋) | 팩시밀리 매핑을 통해 |
| 불규칙 다각형 | 전체 | 전체 | 제한됨 | 좌표 요소를 통해 |
| 툴링 생태계 | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, 웹 뷰어 | Oxygen, TEI 퍼블리셔 |
| 표준화 기관 | PRImA Group / 오픈 | 미국 의회 도서관 | 커뮤니티 사양 | TEI 컨소시엄 |
실용적인 권고사항: 아카이브 파이프라인 선택하기
효율적이고 미래 지향적인 디지털화 파이프라인을 구축하려면:
- 순수 손필 원고 및 아카이브용: 전사와 레이아웃 추출을 PAGE XML로 표준화하십시오. 이의 기준선 계산 및 폴리곤 윤곽은 비표준 필기체를 최소한의 데이터 손실로 처리합니다.
- 대규모 도서관 및 혼합 컬렉션용: 표준 디지털 저장소 아키텍처와 디지털 자산 관리 시스템(DAMS)에 원활하게 통합될 수 있도록 **ALTO XML (v4.2 이상)**과 METS를 선택하십시오.
- 웹 프레젠테이션 및 전체 텍스트 검색 인덱스용: hOCR를 사용하거나 PAGE XML에서 경량 GeoJSON/웹 주석 구조를 파생시켜 인터랙티브 IIIF 뷰어(예: Mirador 또는 Universal Viewer)를 실시간 브라우저 내 텍스트 오버레이와 함께 구동하십시오.
- 학술 판본 및 고문서 연구를 위해: PAGE XML에서 실제 데이터(ground truth)를 생성하고, 인식을 수행한 뒤 자동 변환기를 통해 출력물을 파이프하여 편집 마크업용 TEI-XML을 생성합니다.
이러한 형식들의 구조적 기능을 원본 자료의 고문서 요구에 맞추면, 모든 획, 약어 및 역사적 뉘앙스가 앞으로 수세기 동안 해독 가능하도록 보장합니다.
자주 묻는 질문 (FAQ)
Q1. 표준 OCR과 HTR의 근본적인 차이점은 무엇인가요? OCR은 일관된 기계 인쇄 타이포그래피를 인식하는 반면, HTR(Handwritten Text Recognition)은 심층 신경망을 활용해 연속적이고 가변적인 인간 손글씨와 곡선 기반선을 해독합니다.
Q2. Tesseract OCR이 역사 문서에 대해 PAGE XML 또는 ALTO 출력을 생성할 수 있나요? 네, Tesseract은 기본 ALTO XML 및 hOCR 출력을 생성할 수 있으며, 서드파티 래퍼를 사용해 이러한 결과를 PAGE XML로 변환할 수 있습니다.
Q3. 손글씨 전사에서 기준선이 경계 상자보다 중요한 이유는 무엇인가요? 기준선은 인간 필체의 자연스럽고 물결치는 라인을 추적하여, 소프트웨어가 경직된 경계 상자 안에서 겹치는 상승선과 하강선을 구분하도록 합니다.
Q4. IIIF 표준은 이러한 OCR 파일 형식과 어떻게 상호 작용합니까? IIIF는 오픈 웹 API를 통해 고해상도 이미지를 제공하고, ALTO 또는 PAGE XML과 같은 형식은 좌표 데이터를 제공하여 IIIF 콘텐츠 검색 주석으로 변환할 수 있습니다.
Q5. 어떤 파일 형식이 검색 가능한 PDF로 직접 변환하기 가장 쉽습니까? hOCR와 ALTO XML 모두 원본 페이지 이미지와 결합하여 OCRmyPDF와 같은 도구를 사용해 검색 가능한 이중 레이어 PDF 파일을 만들 수 있습니다.