마지막 업데이트: 2026년 9월 30일
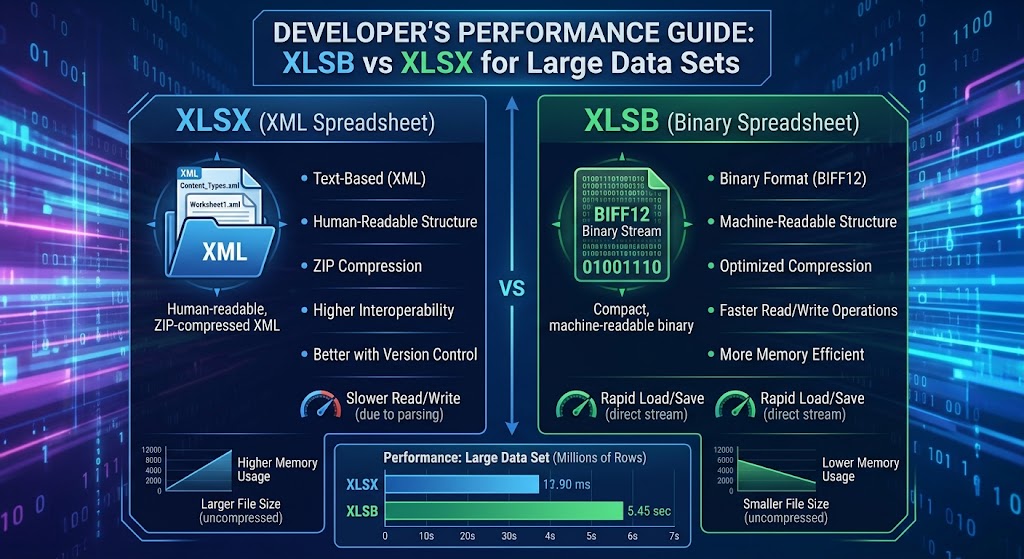
대용량 데이터 세트를 위한 XLSB vs XLSX: 개발자를 위한 성능 가이드
데이터 파이프라인, 백엔드 보고 엔진, 또는 Microsoft Excel과 연동되는 분석 도구를 구축한다면, 아마도 “벽에 부딪혔을 것입니다.”
사용자가 450,000행 워크북을 업로드합니다. 서버는 워커 스레드를 생성하고, 메모리 사용량이 기가바이트 단위로 급증하며, 가비지 컬렉션이 런타임을 멈추게 하고, 실행이 시간 초과됩니다. 페이로드를 검사하면 표준 .xlsx 파일임을 알 수 있습니다.
이를 해결하기 위해 개발자들은 종종 청크 처리, 스트리밍 파서 구현, 또는 파일을 백그라운드 워커로 오프로드하는 데 며칠을 소비합니다. 그러나 가장 효과적인 최적화 중 하나는 아키텍처를 전혀 재설계하지 않고도 할 수 있습니다: 파일 확장자를 .xlsx에서 .xlsb로 변경하는 것입니다.
이 가이드에서는 두 형식의 내부 구조를 자세히 살펴보고, 내부 아키텍처가 왜 급격히 다른 성능 특성을 만들어내는지 분석하며, Python과 .NET에서의 구체적인 벤치마크를 비교하고, 프로덕션에서 바이너리 워크북을 배포할 시점을 위한 명확한 규칙을 제시합니다.
1. 내부 구조 살펴보기: OpenXML vs. BIFF12
대규모 데이터셋에서 성능이 왜 이렇게 극적으로 차이 나는지 이해하려면, 각 형식이 디스크에 레코드를 저장하는 방식을 살펴봐야 합니다.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
.xlsx와 .xlsb 파일은 모두 Open Packaging Conventions (OPC)를 따르는 압축된 ZIP 컨테이너입니다. 파일을 .zip으로 이름을 바꾸고 압축을 풀면 익숙한 디렉터리 구조인 _rels, docProps, 그리고 xl/worksheets/를 볼 수 있습니다.
핵심적인 차이는 xl/worksheets/ 폴더 안에 있습니다:
- XLSX는 시트를 일반 XML 텍스트(
sheet1.xml)로 저장합니다. - XLSB는 시트를 Microsoft의 BIFF12(바이너리 교환 파일 형식 12)로 인코딩된 독점 바이너리 스트림(
sheet1.bin)으로 저장합니다.
XLSX가 데이터를 인코딩하는 방법 (XML DOM 오버헤드)
XLSX 워크시트에서는 모든 셀을 명시적인 XML 태그로 선언합니다:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
이 행을 읽을 때 런타임은 다음을 수행해야 합니다:
- 원시 디플레이트 스트림을 텍스트로 압축 해제합니다.
- 문자열 문자를 토큰화하고 XML DOM 또는 SAX 이벤트 스트림으로 파싱합니다.
- 시작 및 종료 태그 (
<c>,</c>,<v>,</v>)를 검증합니다. - 별도의
sharedStrings.xml테이블에서 문자열 조회를 해결합니다. - ASCII 텍스트
"98234.55"를 IEEE 754 64비트 부동소수점 숫자로 파싱합니다.
각 셀마다 문자열 파싱, 문자열 할당 및 어휘 분석에 대한 CPU 오버헤드가 발생합니다. 이를 500,000행과 30열(1,500만 셀) 전체에 적용하면, CPU는 도메인 값을 처리하기보다 구문을 파싱하는 데 훨씬 더 많은 사이클을 소비합니다.
XLSB가 데이터를 인코딩하는 방법 (BIFF12 바이너리 스트림)
BIFF12는 텍스트 직렬화를 완전히 폐기합니다. 문자열 마크업 대신, 데이터는 가변 길이 바이너리 레코드의 순차적인 시퀀스로 배열됩니다:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12의 부동소수점 셀은 "98234.55"와 같은 문자열 표현을 사용하지 않습니다. 직접적으로 표현됩니다:
- 레코드 ID에 2바이트 (예:
BrtCellRk또는BrtCellReal) - 열/행 인덱스에 4바이트
- 원시 IEEE 754 배정밀도 바이트 구조를 포함하는 8바이트
파서가 XLSB 파일을 읽을 때, 어휘 분석을 완전히 건너뜁니다. 레코드 헤더를 읽고, 버퍼에서 8바이트의 원시 데이터를 가져와 메모리로 바로 복사한 뒤 포인터를 앞으로 이동합니다. 검증할 태그도 없고, 문자열을 숫자로 변환하는 작업도 없으며, 숫자 데이터에 대한 UTF-8 디코딩 오버헤드도 전혀 없습니다.
2. 정량적 벤치마크: 디스크, 메모리 및 처리량
실제 영향을 설명하기 위해, 750,000 행 및 25 열(타임스탬프, 부동소수점 숫자, 정수, 카테고리 코드가 혼합된) 시뮬레이션 데이터셋을 고려해 보세요.
아래 테스트는 XLSX와 XLSB 모두에 저장된 동일한 표 형식 데이터를 평가합니다.
테스트 환경
- CPU: AMD Ryzen 9 5900X (12코어, 24스레드)
- RAM: 64 GB DDR4-3600
- 스토리지: PCIe 4.0 NVMe SSD
- 런타임: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
핵심 성능 지표
| 지표 | XLSX (OpenXML) | XLSB (BIFF12) | 델타 / 개선 |
|---|---|---|---|
| 디스크상의 파일 크기 | 128.4 MB | 68.2 MB | ~47% 더 작음 |
| 저장 / 직렬화 시간 | 42.6 s | 14.1 s | 3.0배 더 빠름 |
| 읽기 시간 (Python DOM 파서) | 38.2 s | 8.9 s | 4.3배 더 빠름 |
| 읽기 시간 (Rust/C 엔진) | 6.4 s | 1.9 s | 3.3배 더 빠름 |
| 읽기 중 최대 힙 할당량 | ~1.85 GB | ~510 MB | ~72% 감소 |
XLSB 파일이 더 작은 이유
두 형식 모두 표준 ZIP 압축을 사용하지만, 바이너리 스트림은 부풀려진 XML 텍스트보다 훨씬 효율적으로 압축됩니다:
- 불필요한 구문이 제거됩니다: XML은 각 레코드마다 반복적인 태그 (
<c r="AA1" s="1">)를 포함합니다. ZIP 압축이 반복 문자열을 완화시키지만, 압축되지 않은 데이터 스트림은 방대합니다. - 숫자 밀도: XML에서는 숫자
12345678.9012가 14바이트의 ASCII 텍스트를 필요로 합니다. BIFF12에서는 8바이트 더블로 저장되며(특정 정밀도 규칙에 맞으면 4바이트RK레코드에 압축될 수도 있습니다).
3. 메모리 사용량 및 가비지 컬렉션 압력
동시 요청을 처리하는 웹 서비스와 마이크로서비스의 경우, CPU 속도는 전투의 절반에 불과합니다; 메모리 사용량이 실제로 애플리케이션이 실패하는 지점입니다.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
XML 파서가 100 MB XLSX 파일을 처리할 때, 수천 개의 일시적인 문자열 토큰, 문자열 슬라이스 버퍼 및 사전 조회를 생성해야 합니다. 가비지 컬렉션이 적용되는 언어(Java, C#, Go, Node.js, Python)에서는 이로 인해 힙 단편화가 심각해지고 런타임이 빈번한 가비지 컬렉션(GC) 일시 정지에 빠지게 됩니다.
XLSB 파싱은 고정 너비 바이트 슬라이스에서 직접 작동하기 때문에 파서는 데이터를 스택에 할당된 구조체나 재사용 가능한 바이트 버퍼로 읽을 수 있습니다. 그 결과 메모리 사용량이 크게 감소하고 런타임 할당자의 스래싱이 전혀 발생하지 않습니다.
4. 개발자 구현 예시
일반적인 개발자 툴체인에서 XLSB를 활용하는 방법을 살펴보겠습니다.
Python: OpenPyXL에서 Calamine / PyXLSB로 마이그레이션
표준 pandas.read_excel('data.xlsx')는 기본적으로 openpyxl을 사용하며, 이는 무거운 인메모리 트리를 구축합니다.
대용량 XLSB 파일을 최대 속도로 처리하려면 Rust 기반 calamine 엔진을 사용하세요(python-calamine을 통해 사용할 수 있으며 최신 Pandas에 통합됩니다).
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
전체 매트릭스를 DataFrame에 로드하지 않고 행 단위로 방대한 데이터셋을 반복하고 있다면, pyxlsb가 가벼운 스트리밍 반복자를 제공합니다.
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: 고성능 스트림 수집
.NET에서는 ClosedXML이나 EPPlus와 같은 라이브러리가 표준 생성에 적합하지만, 메모리 소모 없이 대용량 파일을 읽어들이려면 XLSB를 지원하는 ExcelDataReader가 매우 빠릅니다.
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. 아키텍처 트레이드오프: XLSB를 사용하면 안 되는 경우
압도적인 성능 이점에도 불구하고 XLSB가 만능 해결책은 아닙니다. 스택 전반에 적용하기 전에 여러 운영상의 트레이드오프를 고려해야 합니다.
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. 생태계 및 라이브러리 지원
- XLSX: 범용적입니다. 사실상 모든 언어, 라이브러리, SaaS 도구(Google Sheets, Airtable, Tableau) 및 웹 파서는 OpenXML을 기본적으로 지원합니다.
- XLSB: 덜 보편적입니다. Excel, LibreOffice 및 성숙한 개발자 라이브러리(
ExcelDataReader,pyxlsb,calamine,Aspose)가 이를 지원하지만, 많은 경량 패키지나 순수 웹 기반 JavaScript 파서(예: 오래된 버전의SheetJS)는 제한적이거나 읽기 전용 지원만 제공합니다.
2. Git 및 버전 관리 차이점 비교
- XLSX: ZIP 컨테이너 안에 텍스트 XML을 포함하고 있기 때문에, 명령줄 유틸리티와 Git 훅을 사용해 XML을 압축 해제하고 포맷하여 커밋 간에 읽기 쉬운 구조적 차이를 생성할 수 있습니다.
- XLSB: 순수 바이너리 데이터입니다. 버전 관리 시스템은 이를 완전히 불투명한 바이너리 블롭으로 취급하므로, 세밀한 차이 비교나 라인 수준 병합이 전혀 불가능합니다.
3. 웹 클라이언트 렌더링
아키텍처가 WebAssembly 또는 클라이언트 측 JavaScript를 통해 브라우저에서 스프레드시트를 직접 렌더링하는 데 의존한다면, XLSX 파서는 클라이언트 측 바이너리 파서보다 훨씬 더 성숙하고 경계 상황 렌더링 버그에 덜 취약합니다.
4. 타사 수집 파이프라인
외부 기업 고객에게 파일을 내보내는 경우, 많은 엄격한 기업 보안 정책이 .xlsb 파일을 표시합니다. BIFF12 파일은 .xlsm 파일과 동일하게 VBA 매크로를 별도의 확장자 없이 저장할 수 있기 때문에, 일부 메일 필터와 방화벽 스캐너가 .xlsb 업로드를 매크로가 포함된 잠재적 위협으로 격리합니다.
6. 요약 비교: 어떤 포맷이 승리할까?
| 기능 | XLSX | XLSB | 승자 |
|---|---|---|---|
| 읽기 / 구문 분석 속도 | 보통에서 낮음 | 번개처럼 빠름 | XLSB |
| 쓰기 / 생성 속도 | CPU 집약적 | 빠른 | XLSB |
| 파일 압축 | 좋음 | 우수함 (~40-50% 작게) | XLSB |
| 메모리 할당 | 높음 (높은 GC 압력) | 낮음 (직접 바이트 읽기) | XLSB |
| 툴링 상호 운용성 | 보편적 | 높음, 하지만 선택적 | XLSX |
| 보안 스캔 마찰 | 최소 | 가끔 발생하는 오탐 | XLSX |
| 매크로 기능 | 아니오 (.xlsm 필요) | 예 (매크로를 기본적으로 지원) | 동점 |
7. 개발자의 최종 판단
다음 경우에 XLSX 사용:
- 파일 크기가 작거나 중간 정도 (< 50,000 행)입니다.
- 파일은 서드파티 SaaS 플랫폼이나 소비자 앱(예: Google Sheets)에서 가져와야 합니다.
- 파일을 읽는 최종 클라이언트의 환경을 제어할 수 없습니다.
다음 경우에 XLSB 로 전환하세요:
- 대규모 데이터 추출(> 100,000 행)을 처리하는 내부 파이프라인, 배치 작업, ETL 시스템 또는 워커 작업을 구축하고 있는 경우.
- 서버가 스프레드시트 직렬화 또는 역직렬화 중에 메모리 부족(OOM) 오류가 발생하고 있습니다.
- 대용량 반복 금융 모델이나 데이터 내보내기의 경우 S3/Blob 저장 용량과 네트워크 전송 시간을 최소화해야 합니다.
XLSB로 전환하는 것은 종종 내보내기 서비스의 구성 문자열을 변경하는 것만큼 간단하지만, 일반적으로 몇 주간의 코드 최적화가 필요할 정도인 3배에서 5배의 처리량 향상을 제공합니다.
자주 묻는 질문 (FAQ)
**Q1: XLSB 파일이 XLSX 파일과 정확히 동일한 행 및 열 제한을 지원합니까? 예; XLSB와 XLSX 모두 워크시트당 1,048,576행 및 16,384열이라는 동일한 그리드 상한을 공유합니다.
**Q2: XLSB 파일이 파일 확장자를 변경하지 않고 VBA 매크로를 안전하게 저장할 수 있습니까?
예, XLSX와 달리(코드를 실행하려면 XLSM으로 저장해야 함) XLSB는 동일한 .xlsb 파일 형식 내에서 바이너리 VBA 매크로 저장을 기본적으로 지원합니다.
**Q3: 두 형식 모두 이미 ZIP 압축된 상태인데, 파일을 XLSB로 저장하면 크기가 줄어드는 이유는 무엇입니까? XLSB는 장황한 텍스트 마크업 태그를 없애고 셀 위치, 레코드 및 원시 숫자 값을 촘촘한 바이너리 바이트 스트림으로 인코딩하여 일반 XML 문자열보다 훨씬 더 밀집하게 압축합니다.
**Q4: Google Sheets가 XLSB 파일을 직접 가져오고 편집할 수 있나요?
아니요; Google Sheets는 .xlsb 파일을 직접 열거나 변환할 수 없으며, 가져오기 전에 .xlsx 또는 CSV로 변환해야 합니다.
**Q5: XLSB 파일이 XLSX 파일보다 데이터 손상에 더 취약한가요? XML 파일은 부분적으로 손상될 경우 텍스트 편집기로 수동 검토하거나 복구할 수 있는 경우가 있지만, 바이너리 BIFF12 스트림은 엄격한 바이트 오프셋을 필요로 하며 구조 섹터가 손상되면 수동 복구가 어렵습니다.