Paskutinį kartą atnaujinta: 30 Sep, 2026
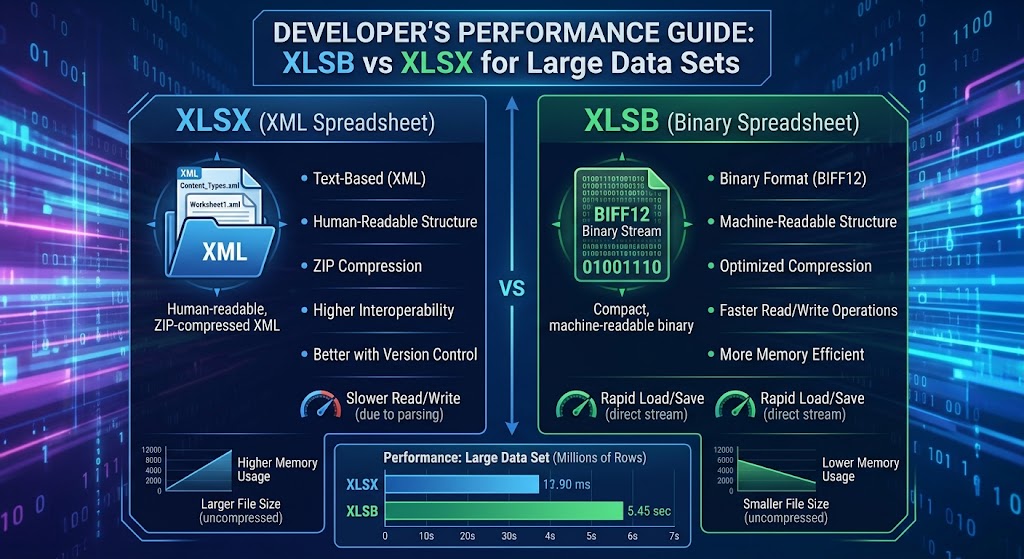
XLSB vs XLSX dideliems duomenų rinkiniams: programuotojo našumo vadovas
Jei kuriate duomenų srautus, backend ataskaitų variklius arba analitikos įrankius, kurie sąveikauja su Microsoft Excel, greičiausiai susidūrėte su „siena“.
Vartotojas įkelia 450 000 eilučių darbaknygę. Jūsų serveris paleidžia darbinį gijas, atminties suvartojimas šokiruojamai išauga iki gigabaitų, šiukšlių surinkimas užšaldo vykdymo laiką, ir jūsų vykdymas baigiasi laiko limitu. Patikrinote duomenų paketą: tai standartinis .xlsx failas.
Norint tai išspręsti, kūrėjai dažnai praleidžia dienas įgyvendindami duomenų skaidymą į dalis, srautinio analizatorių arba perkeldami failus į foninius darbininkus. Vis dėlto viena efektyviausių optimizacijų nereikalauja jokio architektūrinio pertvarkymo: pakeisti failo plėtinį iš .xlsx į .xlsb.
Šiame vadove mes paniriame į abiejų formatų vidų, nagrinėjame, kodėl jų vidinė architektūra sukelia radikaliai skirtingus našumo požymius, lyginame konkrečius našumo matavimus Python ir .NET aplinkose ir pateikiame aiškias taisykles, kada gamyboje naudoti binarines darbaknyges.
1. Užkulisiuose: OpenXML vs. BIFF12
Norint suprasti, kodėl našumas tokį dramatišką skirtumą rodo dideliuose duomenų rinkiniuose, turime pažvelgti, kaip kiekvienas formatas saugo įrašus diske.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Abu .xlsx ir .xlsb failai yra suspausti ZIP konteineriai, atitinkantys Open Packaging Conventions (OPC) standartą. Jei pervadinsite bet kurį failą į .zip ir išskleistumėte jį, pamatysite pažįstamą katalogų struktūrą: _rels, docProps ir xl/worksheets/.
Esminis skirtumas slypi xl/worksheets/ aplanke:
- XLSX saugo lapus kaip paprastą XML tekstą (
sheet1.xml). - XLSB saugo lapus kaip nuosavus binarinius srautus (
sheet1.bin), koduotus naudojant Microsoft BIFF12 (Binary Interchange File Format 12).
Kaip XLSX koduoja duomenis (XML DOM našta)
XLSX darbalapyje kiekviena ląstelė yra apibrėžta aiškiomis XML žymomis:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Skaitant šią eilutę, jūsų vykdymo aplinka turi:
- Išskleisti neapdorotą deflate srautą į tekstą.
- Skaidyti į tokenus ir analizuoti simbolių eilutes į XML DOM arba SAX įvykių srautą.
- Patikrinkite atidarymo ir uždarymo žymas (
<c>,</c>,<v>,</v>). - Išspręskite teksto paieškas iš atskiros
sharedStrings.xmllentelės. - Išanalizuokite ASCII tekstą
"98234.55"į IEEE 754 64‑bitų slankaus kablelio skaičių.
Kiekviena atskira ląstelė sukelia procesoriaus (CPU) išteklių sąnaudas dėl teksto analizės, teksto paskirstymo ir leksikos analizės. Padauginus tai iš 500 000 eilučių ir 30 stulpelių (15 milijonų ląstelių), procesorius praleidžia žymiai daugiau ciklų sintaksės analizei nei domeno verčių apdorojimui.
Kaip XLSB koduoja duomenis (BIFF12 binarinis srautas)
BIFF12 visiškai atsisako teksto serializacijos. Vietoj teksto žymėjimo duomenys išdėlioti kaip nuoseklus kintamo ilgio dvejetainių įrašų sekos:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Slankaus kablelio ląstelė BIFF12 nenaudoja teksto atvaizdų, tokių kaip "98234.55". Ji yra atvaizduojama tiesiogiai:
- 2 baitai įrašo ID (pvz.,
BrtCellRkarbaBrtCellReal) - 4 baitai stulpelio/eilutės indeksams
- 8 baitų, turinčių neapdorotą, IEEE 754 dvigubo tikslumo baitų struktūrą
Kai jūsų analizatorius skaito XLSB failą, jis visiškai apeina leksikinį analizavimą. Jis perskaito įrašo antraštę, paima 8 neapdorotus baitus iš buferio, tiesiogiai kopijuoja juos į atmintį ir perkelia rodyklę į priekį. Nėra žymių, kurias reikėtų patikrinti, nėra eilutės‑į‑skaičių tipų konversijų ir nulio UTF‑8 dekodavimo našta skaitiniams duomenims.
2. Kiekybiniai etalonai: Diskas, Atmintis ir Pralaidumas
Norint pavaizduoti realaus pasaulio poveikį, apsvarstykite simuliuotą duomenų rinkinį, kuriame yra 750 000 eilučių ir 25 stulpeliai (mišinys laiko žymių, slankaus kablelio skaičių, sveikųjų skaičių ir kategorijų kodų).
Žemiau pateikti testai vertina identiškus lentelinius duomenis, išsaugotus tiek XLSX, tiek XLSB formatu.
Testavimo aplinka
- CPU: AMD Ryzen 9 5900X (12 branduolių, 24 gijų)
- RAM: 64 GB DDR4‑3600
- Saugojimas: PCIe 4.0 NVMe SSD
- Vykdymo laikas: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Pagrindiniai našumo rodikliai
| Metrika | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Patobulinimas |
|---|---|---|---|
| Failo dydis diske | 128.4 MB | 68.2 MB | ~47% mažesnis |
| Išsaugojimo / Serializacijos laikas | 42.6 s | 14.1 s | 3.0x greitesnis |
| Skaitymo laikas (Python DOM parser) | 38.2 s | 8.9 s | 4.3x greitesnis |
| Skaitymo laikas (Rust/C variklis) | 6.4 s | 1.9 s | 3.3x greičiau |
| Didžiausia krūvos paskirstymo per skaitymą | ~1.85 GB | ~510 MB | ~72% sumažėjimas |
Kodėl XLSB failai yra mažesni
Nors abu formatai naudoja standartinį ZIP suspaudimą, binariniai srautai suspaudžia žymiai efektyviau nei išplėstinis XML tekstas:
- Pasikartojanti sintaksė pašalinama: XML turi pasikartojančias žymas (
<c r="AA1" s="1">) kiekviename įraše. Nors ZIP suspaudimas sumažina pakartotinius simbolius, nesuspaustas duomenų srautas yra milžiniškas. - Skaitinė tankis: XML faile skaičius
12345678.9012reikalauja 14 baitų ASCII teksto. BIFF12 formate jis saugomas kaip 8 baitų dvigubas skaičius (arba suspaudžiamas į 4 baitųRKįrašą, jei atitinka specifines tikslumo taisykles).
3. Atminties pėdsakas ir šiukšlių surinkimo spaudimas
Web paslaugoms ir mikroservisams, apdorojantiems lygiagrečius užklausimus, procesoriaus greitis yra tik pusė kovos; atminties pėdsakas yra tas, kur programos iš tikrųjų žlunga.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Kai XML analizatorius apdoroja 100 MB XLSX failą, jis turi sukurti tūkstančius laikinų eilutės tokenų, eilutės skilties buferius ir žodyno paieškas. Šiukšlių surinkimo kalbose (Java, C#, Go, Node.js, Python) tai sukelia ekstremalią krūvos fragmentaciją ir verčia vykdymo aplinką dažnai sustoti dėl Šiukšlių surinkimo (GC) pauzių.
Kadangi XLSB analizė veikia tiesiogiai su fiksuoto pločio baitų skiltimis, analizatoriai gali skaityti duomenis į steko paskirstytas struktūras arba pakartotinai naudojamus baitų buferius. Rezultatas – žymiai sumažėjęs atminties pėdsakas ir nulinis vykdymo laiko alokatoriaus trankavimas.
4. Kūrėjo įgyvendinimo pavyzdžiai
Pažvelkime, kaip išnaudoti XLSB įprastose kūrėjų įrankių grandinėse.
Python: Perkėlimas iš OpenPyXL į Calamine / PyXLSB
Standartinis pandas.read_excel('data.xlsx') pagal nutylėjimą naudoja openpyxl, kuris sukuria didelį atminties medį.
Norint apdoroti didelius XLSB failus maksimaliai greitai, naudokite Rust varomą calamine variklį (prieinamą per python-calamine ir integruotą į modernų Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Jei iteruojate per milžiniškus duomenų rinkinius eilutė po eilutės neįkeliant visos matricos į DataFrame, pyxlsb suteikia lengvą srautinį iteratorių:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Aukštos našumo srauto įsisavinimas
.NET aplinkoje bibliotekos kaip ClosedXML ar EPPlus puikiai tinka standartiniam generavimui, tačiau norint įkelti didelius failus be atminties išsekimo, ExcelDataReader su XLSB palaikymu yra nepaprastai greitas:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Architektūriniai kompromisai: Kada NENAUDOTI XLSB
Nors XLSB turi nepaprastai didelį našumo pranašumą, tai nėra stebuklingas sprendimas. Prieš įgyvendindami jį visoje savo sistemoje, turėtumėte apsvarstyti kelis operacinius kompromisus:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosistema ir bibliotekų palaikymas
- XLSX: Universalus. Iš esmės kiekviena kalba, biblioteka, SaaS įrankis (Google Sheets, Airtable, Tableau) ir internetinis parseris natūraliai palaiko OpenXML.
- XLSB: Mažiau paplitęs. Nors Excel, LibreOffice ir išsivysčiusios kūrėjų bibliotekos (
ExcelDataReader,pyxlsb,calamine,Aspose) jį palaiko, daugelis lengvų paketų arba grynai internetinių JavaScript parserių (pvz., senesnėsSheetJSversijos) turi ribotą arba tik skaitymo palaikymą.
2. Git ir versijų kontrolės skirtumų analizė
- XLSX: Kadangi jis turi tekstinį XML ZIP konteineryje, komandų eilutės įrankiai ir Git kabliukai gali išarchyvuoti ir formatuoti XML, kad sukurtų skaitomus struktūrinius skirtumus tarp įsipareigojimų.
- XLSB: Gryni binariniai duomenys. Versijų kontrolės sistemos traktuoja jį griežtai kaip nepermatomą binarinį objektą, pašalindamos bet kokią galimybę atlikti smulkius skirtumus ar eilučių lygio sujungimus.
3. Žiniatinklio kliento atvaizdavimas
Jei jūsų architektūra remiasi skaičiuoklių atvaizdavimu tiesiogiai naršyklėje per WebAssembly arba kliento pusės JavaScript, XLSX parseriai yra žymiai brandesni ir mažiau linkę į kraštutinės situacijos atvaizdavimo klaidas nei kliento pusės binariniai parseriai.
4. Trečiųjų šalių įsisavinimo kanalai
Jei eksportuojate failus išoriniams įmonės klientams, daugelis griežtų įmonės saugumo politikų žymi .xlsb failus. Kadangi BIFF12 failai gali saugoti VBA makrokomandas identiškai kaip .xlsm failai (be būtinybės naudoti atskirą plėtinį), kai kurie el. pašto filtrai ir ugniasienės skeneriai karantinuoja .xlsb įkėlimus kaip galimas makrokomandas turinčias grėsmes.
6. Santrauka ir palyginimas: Kuri formatas laimi?
| Savybė | XLSX | XLSB | Laimėtojas |
|---|---|---|---|
| Skaitymo / Analizės greitis | Vidutinis iki prasto | Labai greitas | XLSB |
| Rašymo / Generavimo greitis | CPU intensyvus | Greita | XLSB |
| Failų suspaudimas | Geras | Puiku (~40-50% mažiau) | XLSB |
| Atminties paskirstymas | Aukštas (Didelis GC spaudimas) | Žemas (Tiesioginis baitų skaitymas) | XLSB |
| Įrankių tarpusavio suderinamumas | Universalus | Aukštas, bet selektyvus | XLSX |
| Saugumo skenavimo trintis | Minimalus | Retkarčiais klaidingi teigiami rezultatai | XLSX |
| Makro galimybės | Ne (.xlsm reikalingas) | Taip (Palaiko makrokomandas natūraliai) | Ryšys |
7. Kūrėjo nuomonė
Naudokite XLSX, kai:
- Failai yra nedidelio arba vidutinio dydžio (< 50 000 eilučių).
- Jūsų failus turi apdoroti trečiųjų šalių SaaS platformos arba vartotojų programos (pvz., Google Sheets).
- Negalite kontroliuoti galutinio kliento, skaitančio failą, aplinkos.
Perjunkite į XLSB, kai:
- Kuriate vidinius duomenų srautus, paketinius darbus, ETL sistemas arba darbo užduotis, kurios apdoroja didelius duomenų ištraukas (> 100 000 eilučių).
- Jūsų serveriai susiduria su atminties trūkumo (OOM) klaidomis, kai vykdoma skaičialapio serializacija arba deserializacija.
- Jums reikia sumažinti S3/bloško saugojimo pėdsakus ir tinklo perdavimo laiką dideliems periodiškiems finansiniams modeliams arba duomenų eksporto procesams.
Perėjimas prie XLSB dažnai yra toks paprastas, kaip pakeisti konfigūracijos eilutę jūsų eksporto tarnyboje, tačiau jis suteikia 3‑5 kartų didesnį pralaidumo padidėjimą, kuris paprastai reikalauja savaičių kodo optimizavimo.
Dažnai užduodami klausimai (DUK)
**Q1: Ar XLSB failas palaiko tą patį eilučių ir stulpelių limitą kaip XLSX failas? Taip; tiek XLSB, tiek XLSX turi tą patį tinklelio maksimumą – 1 048 576 eilučių ir 16 384 stulpelių viename darbalapyje.
**Q2: Ar XLSB failas gali saugiai saugoti VBA makrokomandas nekeisdamas failo plėtimo?
Taip, skirtingai nuo XLSX (kuris reikalauja išsaugoti kaip XLSM, kad būtų vykdomas kodas), XLSB natūraliai palaiko dvejetainį VBA makrokomandų saugojimą tame pačiame .xlsb failo formate.
**Q3: Kodėl išsaugant failą kaip XLSB sumažėja jo dydis, jei abu formatai jau yra suspausti ZIP archyvu? XLSB pašalina išsamias teksto žymėjimo žymas ir koduoja langelių pozicijas, įrašus bei neapdorotas skaitines reikšmes į glaustus dvejetainių baitų srautus, kurie suspaudžiami žymiai tankiau nei paprasti XML eilutės.
**Q4: Ar „Google Sheets“ gali tiesiogiai importuoti ir redaguoti XLSB failus?
Ne; „Google Sheets“ negali natūraliai atverti ar konvertuoti .xlsb failų tiesiogiai, todėl reikia juos konvertuoti į .xlsx arba CSV prieš importuojant.
**Q5: Ar XLSB failai yra labiau linkę į duomenų sugadinimą nei XLSX failai? Nors XML failus kartais galima rankiniu būdu peržiūrėti ar pataisyti teksto redaktoriumi, kai jie yra dalinai sugadinti, binariniai BIFF12 srautai reikalauja griežtų baitų poslinkių ir juos sunku atkurti rankiniu būdu, jei struktūriniai sektoriai yra pažeisti.