Pēdējoreiz atjaunināts: 20 Aug, 2026
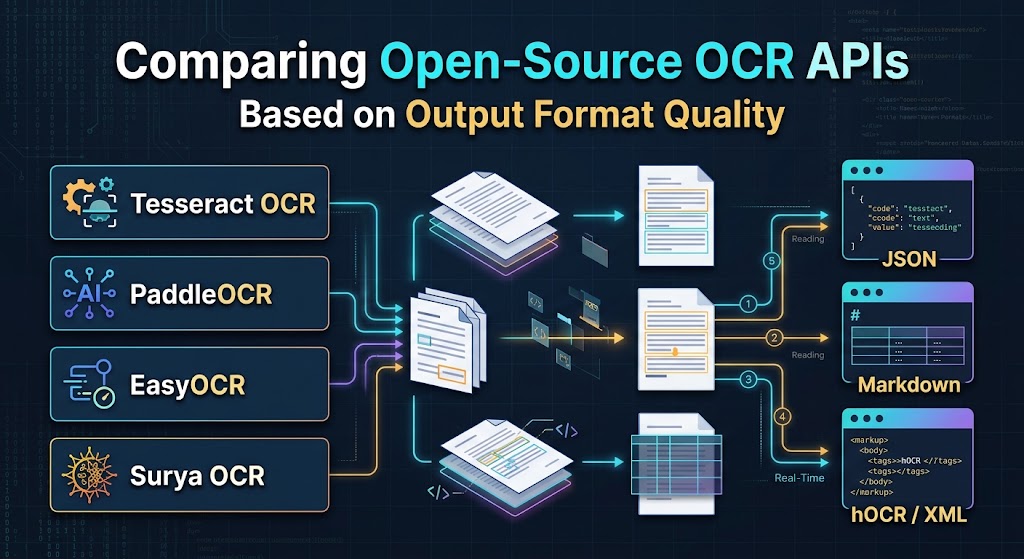
Salīdzinot atvērtā koda OCR API, balstoties uz izvades formāta kvalitāti
Kad inženieri izvērtē optiskās rakstzīmju atpazīšanas (OCR) dzinējus, rakstzīmju kļūdas rādītājs (CER) un vārdu kļūdas rādītājs (WER) parasti dominē pārbaudēs. Lai gan atpazīšanas precizitāte ir būtiska, tā atrisina tikai pusi no problēmas ražošanā.
Ja jūs parsējat sarežģītus daudzkolonu PDF, izvelkat rindu vienības no kvītīm vai ievadāt balto grāmatu saturu LLM iegulšanas caurulē, neapstrādāta teksta izmešana rada milzīgu inženiertehnisko slogu. Rakstzīmju virkne bez izkārtojuma izpratnes, loģiskas lasīšanas kārtības vai koordinātu datiem liek jūsu komandai rakstīt trauslus heuristiskus parsētājus.
Patiesais atšķirīgais faktors mūsdienu dokumentu darba plūsmās ir izvades formāta kvalitāte: cik konsekventi un tīri dzinējs nodrošina koordinātas, lasīšanas kārtību, struktūras hierarhiju un tabulu datus.
Zemāk ir inženieru vērsta salīdzinājums ar četriem vadošajiem open-source OCR dzinējiem—Tesseract, PaddleOCR, EasyOCR un Surya OCR—novērtējot, kā viņu izvada dati uzvedas automatizētās caurulēs.
Biežākie izvades formāti: Ko inženieri patiešām vajag
Katrs OCR API pakotē noteikto tekstu citādāk. Šo formātu izpratne palīdz noteikt, cik daudz pēcapstrādes jūsu cauruļvads prasa:
- Vienkāršais teksts (
.txt): Vienkāršākā pārstāvība. Tas noņem visus pozicionālos metadatus un apvieno vairākkolonu izkārtojumus horizontālās lasīšanas veidā, kas var sajaukt rindkopas. - Arhīvu standarti (
hOCR,ALTO XML): XML/HTML balstīti formāti, kas ir standarti bibliotēku arhivēšanā. Tie iekļauj koordinātas, fonta novērtējumus un pārliecības rādītājus DOM mezglos. Ļoti izturīgi dokumenta rekonstrukcijai, bet apjomīgi mikroservisiem. - Strukturēts JSON: Noklusējuma izvēle mūsdienu tīmekļa aizmugurēm. Nodrošina koordinātu masīvus (apvilku vai daudzstūru), pārliecības rādītājus un hierarhiskās bloku/rindas/vārdu struktūras.
- Markdown (
.md) / HTML tabulas: Mūsdienu standarts Retrieval-Augmented Generation (RAG). Saglabā semantiskās sekcijas (virsraksti, saraksti, treknraksts) un tabulas matricas, neprasot lejupplūstošu telpisko rekonstrukciju.
1. Tesseract OCR
Uzturēts Google, Tesseract joprojām ir pamata darbarīks atvērtā koda OCR. Tā arhitektūra balstās uz tradicionāliem lapas segmentācijas algoritmiem, papildinātiem ar LSTM balstītu rakstzīmju dzinēju.
Dzimtie izvades formāti
- Primārie izvadījumi: Vienkāršs teksts, hOCR (HTML), ALTO XML, TSV (tabulāri atdalītas vērtības) un meklējams PDF/A.
- Izkārtojuma izpratne: Noteikumu balstītas heuristikas, izmantojot lapas segmentācijas režīmus (PSM).
Izvades formāta analīze
- Kur tas izceļas: Tesseract
TSVunhOCReksporti ir standartizēti un paredzami. Viena TSV eksports atgriež strukturētas kolonnaslevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightunconf. Ja pārvēršat papīra arhīvus meklējamos PDF vai jums ir nepieciešama stingra atbilstība institucionālajiem standartiem, Tesseract to apstrādā iebūvēti bez pielāgotas savienošanas koda. - Kur tas trūkst: Tesseract nav iebūvēta JSON API. Izmantot tā izvadi Python vai Node.js prasīs XML/TSV failu parsēšanu vai apvalku izmantošanu, piemēram,
pytesseract. Tā izkārtojuma dzinējs arī cīnās ar nestandarta kolonnu plūsmu, bieži sajaucot tekstu no blakus esošām kolonnām, ja nav nodrošināti manuāli noteikti robežu apgriezieni.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Balstīts uz Baidu PaddlePaddle struktūru, PaddleOCR ir guvis plašu pieņemšanu pateicoties tā vieglajiem modeļiem, plašajam daudzvalodu pārklājumam un specializētajam dokumentu analīzes rīkkopum (PP-Structure).
Dzimtie izvades formāti
- Primārie izvadi: Python saraksti/vārdnīcas, neapstrādāts JSON, vizualizācijas pārklājumi un strukturēts HTML caur PP-Structure.
- Izkārtojuma apziņa: Augsta (izmantojot dziļās mācīšanās modeļus izkārtojuma parsēšanai, orientācijas klasifikācijai un tabulu atjaunošanai).
Izvades formāta analīze
- Kur tas izceļas: Standarta PaddleOCR atgriež 4-punktu daudzstūra koordinātas (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) kopā ar teksta virknēm un pārliecības rādītājiem. Tas eleganti apstrādā slīpu vai izliekto tekstu. Tomēr īstā spēks slēpjas PP-Structure komplektā, kas atpazīst izkārtojuma reģionus (virsraksts, teksts, tabula, attēls) un tieši parsē tabulas par derīgām HTML virknēm (<table>...</table>). Tas likvidē vajadzību manuāli aprēķināt šūnu pārklājumus no robežkastiņām. - Kur tas trūkst: Pamata API atgriež ligzdotas masīvus, kuriem trūkst standarta īpašību atslēgu dažādās versijās. Strukturētām lietojumprogrammām izstrādātāji parasti raksta starpposma adapteri, lai standartizētu lauku nosaukumus (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Izveidots uz PyTorch pamata, ko izstrādājis JaidedAI, EasyOCR ir veidots ātrai izstrādātāju pieņemšanai. Tas apvieno CRAFT (Character Region Awareness for Text Detection) ar dziļās mācīšanās atpazīšanas tīkliem minimālā API.
Dzimtie izvades formāti
- Primārie izvadi: Python saraksti, kas satur koordinātu tupeles, atpazītas virknes un pārliecības vērtības.
- Izkārtojuma apziņa: Zema līdz mērena (tikai teksta rindu noteikšana; nav dokumenta līmeņa struktūras parsēšanas).
Izvades formāta analīze
- Kur tas izceļas: Atgriešanas objekta vienkāršība ir nepārspējama:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Šī izvades pārvēršana par standarta REST atbildi vai tās serializēšana tieši uz GeoJSON/pielāgotām shēmām prasa tikai dažas koda rindas. Tā darbojas uzticami uz dabiskajiem ainas tekstiem, numurzīmēm un atsevišķiem dokumenta fragmentiem.
- Kur tas trūkst: EasyOCR neveic holistisku dokumenta izkārtojuma analīzi. Tas neatpazīst tabulas, virsrakstu hierarhijas vai lasīšanas secību sarežģītās kolonnās. Izmantojot EasyOCR uz divkolonnu akadēmiskā raksta, bieži tiek radīti savīti teksta fragmenti, ja vien tas nav kombinēts ar iepriekšējo izkārtojuma noteikšanas modeli (piemēram, YOLO vai LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya ir mūsdienīgs dziļās mācīšanās OCR ietvars, kas izstrādāts īpaši sarežģītas dokumentu izpratnes un LLM ieguves cauruļvadu vajadzībām.
Dzimtās izvades formāti
- Primārie izvadi: Pydantic modelētas JSON struktūras, loģiskie lasīšanas secības indeksi, izkārtojuma robežreģioni un rindu noteikšanas daudzstūri.
- Izvietojuma apziņa: Ļoti augsta (dziļās mācības balstīta izkārtojuma analīze un lasīšanas secības kārtošana).
Izvades formāta analīze
- Kur tas izceļas: Surya tieši risina mūsdienu AI inženierijas izaicinājumus. Tā vietā, lai pieņemtu, ka dokumenti tiek lasīti no augšas uz leju, no kreisās uz labo, Surya izmanto īpašu modeli, lai prognozētu lasīšanas secību. Tas grupē rindas loģiskos semantiskajos blokos, dabiski apstrādā vairāku kolonnu pārklājumus un izvada tipizētas struktūras, izmantojot Pydantic. Tas ļauj tieši un uzticami integrēt datus vektoru datubāzēs un Markdown pārveidotājos.
- Kur tas nepilnības: Kā jaunāks, smagāks uz PyTorch balstīts ietvars, Surya prasa veltītu GPU skaitļošanu, lai sasniegtu optimizēto C++ dzinēju, piemēram, Tesseract vai kvantizētu Paddle modeļu, caurplūdumu. Tas nevirza uz mantojuma arhīvu standartiem, piemēram, hOCR vai ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Tiešā salīdzinājuma matrica
| Spēja / Formāts | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Vietējais hOCR / ALTO XML | Iebūvētais atbalsts | Tikai trešās puses | Nav | Nav |
| Aploces ģeometrija | Pēc asīm izlīdzināts (x, y, w, h) | 4 punktu daudzstūris | 4 punktu daudzstūris | Daudzstūris + izkārtojuma bloki |
| Tabulas parsēšana | Tikai koordinātu TSV | HTML tabulas virknes | Nav | Šūnu koordinātu režģi |
| Lasīšanas secības noteikšana | Uz noteikumu balstīts (pārtrauc daudzkolonnās) | ML izkārtojuma analīze | Pamata līniju grupēšana | Veltīts lasīšanas secības modelis |
| Tiešas JSON shēmas | Pieprasa konvertēšanu | Python vārdnīca / JSON | Python saraksts / JSON | Tipizēti Pydantic modeļi |
| Ideāls lejupplūsmas mērķis | Arhīva PDF, mantots DMS | Formu/kvīts dati, ERP | Ātrie skripti, ainas teksts | LLM uzņemšana, RAG arhitektūras |
Caurules ieteikumi: kuru vajadzētu izvēlēties?
- Izvēlieties Tesseract ja jūsu atbilstības prasības pieprasa standartizētus
hOCR,ALTO XMLvai meklējamus PDF/A piegādes materiālus valdības vai arhīva ierakstiem. - Izvēlieties PaddleOCR ja jūs apstrādājat operatīvus finanšu dokumentus (rēķinus, kvītus, nodokļu veidlapas), kas satur sarežģītas, bez robežām tabulas, kuras jākonvertē uz HTML vai izklājlapām.
- Izvēlieties EasyOCR ja jums ir vajadzīga viegla, Pythoniska bibliotēka, lai noteiktu un izvilktu tekstu no dabiskām bildēm, ielu zīmēm vai apgrieztiem UI elementiem bez konfigurācijas traucējumiem.
- Izvēlieties Surya OCR ja jūs piegādājat ne strukturētus biznesa pārskatus, pētījumu rakstus un tehniskos ceļvežus LLM vai vektoru meklēšanas dzinējam, kur loģiskā lasīšanas kārtība un skaidras struktūras robežas ir būtiskas.
Biežāk uzdotie jautājumi (BUJ)
1. Kurš atvērtā koda OCR izvades formāts ir visvieglāk integrējams ar lielajiem valodu modeļiem?
Surya OCR lasīšanas kārtību apzinātais JSON un PaddleOCR PP-Structure HTML tabulas nodrošina vistīrākos attēlojumus LLM uzvednes kontekstos un RAG indeksēšanai.
2. Vai Tesseract var radīt JSON atbildes iebūvēti, neizmantojot trešo pušu rīkus?
Nē, Tesseract izvada tekstu, TSV, PDF un hOCR/ALTO XML natīvi; JSON izveidei ir jāpārvērš tā TSV vai hOCR izvade, izmantojot starpposma parsētāju.
3. Kā 4-punktu daudzstūra koordinātas atšķiras no ass-līdzinātām robežkastiņām?
Axiālu līnijās esošas kastes izmanto [x, y, width, height], pieņemot plakanu tekstu, kamēr 4-punktu daudzstūri nodrošina četras koordinātu pārus, lai precīzi aptvertu pagrieztas, slīpas vai izliekas teksta rindas.
4. Kurš dzinējs izvada tabulu struktūras tieši kodā, nevis brīvos koordinātus?
PaddleOCR PP-Structure modulis rekonstruē noteiktās tabulas robežas par pilnīgiem HTML tabulas tagiem (<table>, <tr>, <td>), izvairoties no pielāgotas telpiskās matemātikas.
5. Kāpēc standarta EasyOCR izvade saskaras ar grūtībām daudzkolonu zinātniskajos rakstos?
EasyOCR identificē teksta rindas, balstoties uz lokālu tuvumu, nevis globālu izkārtojuma hierarhiju, kas izraisa blakus esošo kolonnu teksta savīšanu, ja vien tas nav ierobežots ar ārēju izkārtojuma dzinēju.