Pēdējoreiz atjaunināts: 30 sept., 2026
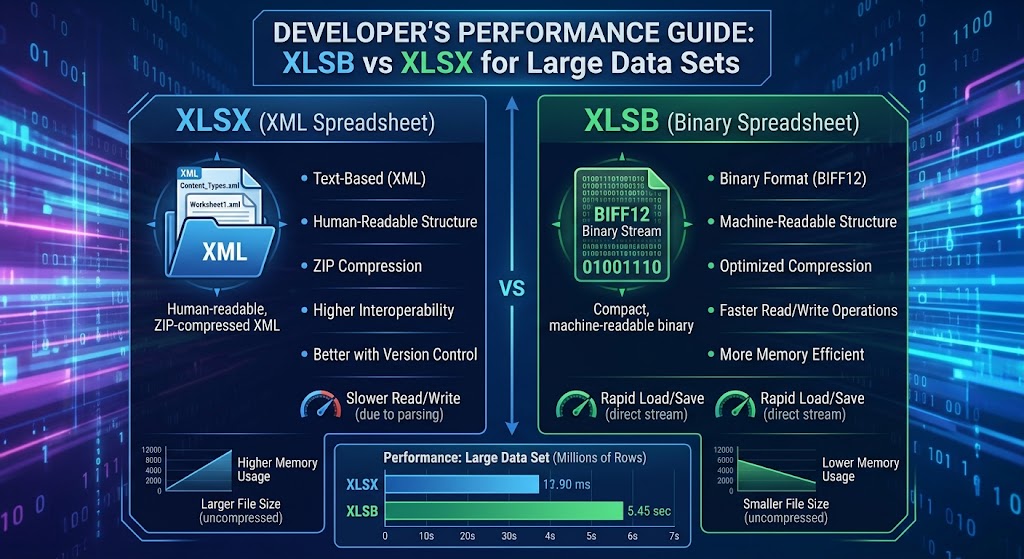
XLSB vs XLSX lieliem datu kopumiem: Izstrādātāja veiktspējas ceļvedis
Ja jūs veidojat datu caurules, aizmugures atskaites dzinējus vai analītikas rīkus, kas integrējas ar Microsoft Excel, jums, visticamāk, ir saskāries ar “sienu”.
Lietotājs augšupielādē 450,000 rindu darblapu. Jūsu serveris palaiž darbinieku pavedienus, atmiņas patēriņš strauji pieaug līdz gigabaitiem, atkritumu savākšana aptur izpildlaiku, un jūsu izpilde beidzas ar laika limitu. Jūs pārbaudāt slodzi: tas ir standarta .xlsx fails.
Lai to atrisinātu, izstrādātāji bieži pavada dienas, īstenojot blokēšanu, straumējošus parsētājus vai pārvietojot failus uz fona darbiniekiem. Tomēr viena no visefektīvākajām optimizācijām neprasa nekādu arhitektūras pārplānošanu: faila paplašinājuma maiņa no .xlsx uz .xlsb.
Šajā ceļvedī mēs iedziļināmies abu formātu struktūrā, izpētām, kāpēc to iekšējās arhitektūras rada radikāli atšķirīgas veiktspējas īpašības, salīdzinām konkrētus veiktspējas rādītājus Python un .NET vidē, un izklāstām skaidrus noteikumus, kad ražošanā jāizmanto binārie darblapas.
1. Zem virsmas: OpenXML pret BIFF12
Lai izprastu, kāpēc veiktspēja tik dramatiski atšķiras lielos datu kopumos, mums jāaplūko, kā katrs formāts saglabā ierakstus uz diska.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Gan .xlsx gan .xlsb faili ir saspiesti ZIP konteineri, kas atbilst Open Packaging Conventions (OPC). Ja pārdēvēsit kādu no failiem uz .zip un to izpakosiet, redzēsiet pazīstamu direktoriju struktūru: _rels, docProps un xl/worksheets/.
Svarīgā atšķirība atrodas xl/worksheets/ mapē:
- XLSX saglabā lapas kā vienkāršu XML tekstu (
sheet1.xml). - XLSB saglabā lapas kā īpašus bināros plūsmas (
sheet1.bin), kodētas, izmantojot Microsoft BIFF12 (Binary Interchange File Format 12).
Kā XLSX kodē datus (XML DOM pārlieku slodze)
XLSX darblapā katra šūna tiek deklarēta ar skaidriem XML tagiem:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Lasa šo rindu, jūsu izpildlaiks jāveic:
- Atspiediet neapstrādāto deflate plūsmu uz tekstu.
- Tokenizējiet un parsējiet virknes rakstzīmes uz XML DOM vai SAX notikumu plūsmu.
- Validējiet atvēršanas un aizvēršanas tagus (
<c>,</c>,<v>,</v>). - Atrisiniet virkņu meklēšanu no atsevišķas
sharedStrings.xmltabulas. - Parsējiet ASCII tekstu
"98234.55"uz IEEE 754 64‑bitu peldošā komata skaitli.
Katrs atsevišķais šūna rada CPU pārslodzi virkņu parsēšanai, virkņu piešķiršanai un leksiskajai analīzei. Reizinot to ar 500 000 rindām un 30 kolonnām (15 miljoni šūnu), CPU patērē daudz vairāk ciklu, parsējot sintaksi, nekā apstrādājot domēna vērtības.
Kā XLSB kodē datus (BIFF12 binārais plūsma)
BIFF12 pilnīgi atmet teksta serializāciju. Tā vietā, lai izmantotu virkņu marķējumu, dati tiek sakārtoti kā secīga mainīga garuma bināro ierakstu secība:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Peldošā komata šūna BIFF12 neizmanto virkņu attēlojumus, piemēram, "98234.55". Tā tiek attēlota tieši:
- 2 baiti ieraksta ID (piemēram,
BrtCellRkvaiBrtCellReal) - 4 baiti kolonnas/rindas indeksiem
- 8 baiti, kas satur neapstrādātu, IEEE 754 dubultprecizitātes baitu struktūru
Kad jūsu parsētājs lasa XLSB failu, tas pilnīgi apiet leksisko parsēšanu. Tas lasa ieraksta galveni, paņem 8 neapstrādātos baitus no bufera, kopē tos tieši atmiņā un pārvieto rādītāju uz priekšu. Nav tagu, ko validēt, nav virknes‑uz‑skaitļa tipa pārveidojumu, un skaitlisko datu UTF‑8 atkodēšanas pārklājs ir nulle.
2. Kvantitatīvi veiktspējas rādītāji: disks, atmiņa un caurplūdība
Lai ilustrētu reālās pasaules ietekmi, apsveriet simulētu datu kopu, kas satur 750 000 rindas un 25 kolonnas (sajaukumu ar laika zīmēm, peldošā komata skaitļiem, veseliem skaitļiem un kategoriju kodiem).
Zemāk esošie testi novērtē identisku tabulu datu saglabāšanu gan kā XLSX, gan kā XLSB.
Testa vide
- CPU: AMD Ryzen 9 5900X (12 kodoli, 24 pavedieni)
- RAM: 64 GB DDR4‑3600
- Glabāšana: PCIe 4.0 NVMe SSD
- Izpildlaiks: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Galvenie veiktspējas rādītāji
| Metrika | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Uzlabojums |
|---|---|---|---|
| Faila izmērs uz diska | 128.4 MB | 68.2 MB | ~47% mazāk |
| Saglabāšanas / Serializācijas Laiks | 42.6 s | 14.1 s | 3.0x ātrāk |
| Lasīšanas Laiks (Python DOM Parsētājs) | 38.2 s | 8.9 s | 4.3x ātrāk |
| Lasīšanas laiks (Rust/C dzinējs) | 6.4 s | 1.9 s | 3.3x ātrāk |
| Maksimālā kaudzes piešķiršana lasīšanas laikā | ~1.85 GB | ~510 MB | ~72% samazinājums |
Kāpēc XLSB faili ir mazāki
Lai gan abi formāti izmanto standarta ZIP saspiešanu, binārie plūsmu dati tiek saspiesti daudz efektīvāk nekā pārblīvētais XML teksts:
- Redundanta sintakse tiek likvidēta: XML satur atkārtotas birkas (
<c r="AA1" s="1">) katrā ierakstā. Lai gan ZIP saspiešana mazinā atkārtoto virkņu, nesaspiestais datu plūsmas apjoms ir milzīgs. - Skaitļu blīvums: XML, skaitlim
12345678.9012nepieciešami 14 baiti ASCII teksta. BIFF12 formātā tas tiek saglabāts kā 8 baitu dubults (vai iepakots 4 baituRKierakstā, ja tas atbilst konkrētiem precizitātes noteikumiem).
3. Atmiņas patēriņš un atkritumu savākšanas spiediens
Web pakalpojumiem un mikroservisiem, kas apstrādā vienlaicīgus pieprasījumus, CPU ātrums ir tikai puse no cīņas; atmiņas nospiedums ir tas, kur lietojumprogrammas patiesi neizdodas.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Kad XML parsētājs apstrādā 100 MB XLSX failu, tam jāizveido tūkstošiem pārejošu virkņu tokenu, virkņu gabalu buferu un vārdnīcas meklējumu. Atkritumu savākšanas valodās (Java, C#, Go, Node.js, Python) tas rada ekstremālu kaudzes fragmentāciju un liek izpildlaikam bieži pārtraukt darbību atkritumu savākšanas (GC) pauzēs.
Tā kā XLSB parsēšana darbojas tieši uz fiksēta platuma baitu šķēlēm, parseri var nolasīt datus uz steka piešķirtām struktūrām vai atkārtoti lietojamiem baitu buferiem. Rezultātā ir būtiski samazināts atmiņas nosējs un nav nekāda izpildlaika piešķiršanas traucēšanas.
4. Izstrādātāja īstenošanas piemēri
Apskatīsim, kā izmantot XLSB vispārējās izstrādātāju rīku ķēdēs.
Python: migrācija no OpenPyXL uz Calamine / PyXLSB
Standarta pandas.read_excel('data.xlsx') pēc noklusējuma izmanto openpyxl, kas izveido smagu atmiņā esošu koku.
Lai apstrādātu lielus XLSB failus ar maksimālu ātrumu, izmantojiet Rust-dzinēto calamine dzinēju (pieejamu caur python-calamine un integrētu mūsdienu Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Ja jūs iterējat pār milzīgiem datu kopumiem rindas pa rindai, neielādējot visu matricu DataFrame, pyxlsb nodrošina vieglu straumēšanas iteratoru:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Augstas veiktspējas straumes uzņemšana
.NET vidē bibliotēkas kā ClosedXML vai EPPlus ir lieliskas standarta ģenerēšanai, bet lielu failu apstrādei bez atmiņas izsīkuma ExcelDataReader ar XLSB atbalstu ir ārkārtīgi ātrs:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Arhitektūras kompromisi: Kad NEJĀLIETO XLSB
Neskatoties uz pārspīlētajām veiktspējas priekšrocībām, XLSB nav vispārējais risinājums. Jums jāapsver vairāki operacionālie kompromisi, pirms to ieviest visā jūsu sistēmā:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosistēma un bibliotēku atbalsts
- XLSX: Universāls. Praktiski katra valoda, bibliotēka, SaaS rīks (Google Sheets, Airtable, Tableau) un tīmekļa parsētājs atbalsta OpenXML iebūvēti.
- XLSB: Mazāk izplatīts. Lai gan Excel, LibreOffice un izaugušas izstrādātāju bibliotēkas (
ExcelDataReader,pyxlsb,calamine,Aspose) to atbalsta, daudzas vieglas pakotnes vai tīri tīmekļa balstīti JavaScript parsētāji (piemēram, vecākasSheetJSversijas) ir ierobežoti vai tikai lasīšanas režīmā.
2. Git un versiju kontroles diffēšana
- XLSX: Tā kā tas satur teksta XML ZIP konteinerā, komandrindas utilītprogrammas un Git āķi var atpakot un formatēt XML, lai radītu lasāmus strukturālus diffus starp revīzijām.
- XLSB: Tīri bināri dati. Versiju kontroles sistēmas to apstrādā kā necaurredzamu bināru objektu, izslēdzot jebkādas iespējas veikt smalku diffēšanu vai līniju līmeņa sapludināšanu.
3. Tīmekļa klienta renderēšana
Ja jūsu arhitektūra balstās uz izklājlapu attēlošanu tieši pārlūkā, izmantojot WebAssembly vai klienta‑pusē JavaScript, XLSX parsētāji ir ievērojami briedāki un mazāk pakļauti neparastu attēlošanas kļūdu riskam nekā klienta‑pusē binārie parsētāji.
4. Trešo pušu uzņemšanas cauruļvadi
Ja eksportējat failus ārējiem uzņēmuma klientiem, daudzas stingras korporatīvās drošības politikas atzīmē .xlsb failus. Tā kā BIFF12 faili var saglabāt VBA makro komandas identiski kā .xlsm faili (nepieprasot atsevišķu paplašinājumu), daži e-pasta filtri un ugunsmūra skeneri izolē .xlsb augšupielādes kā potenciālus makro nesējus draudus.
6. Kopsavilkuma salīdzinājums: Kurš formāts uzvar?
| Īpaļība | XLSX | XLSB | Uzvarētājs |
|---|---|---|---|
| Lasīšanas / Parsēšanas ātrums | Mērens līdz slikts | Ātri kā zibens | XLSB |
| Rakstīšanas / Ģenerēšanas ātrums | CPU intensīvs | Ātrs | XLSB |
| Failu saspiešana | Labi | Izcils (~40-50% mazāks) | XLSB |
| Atmiņas piešķiršana | Augsts (Liels GC spiediens) | Zems (Tieša baitu lasīšana) | XLSB |
| Rīku savietojamība | Universāls | Augsts, bet selektīvs | XLSX |
| Drošības skenēšanas berze | Minimāls | Periodiski nepatiesi pozitīvi | XLSX |
| Makro iespēja | Nē (.xlsm nepieciešams) | Jā (Atbalsta makrokomandas iebūvēti) | Saistīt |
7. Izstrādātāja spriedums
Izmantojiet XLSX, ja:
- Faili ir mazi līdz vidēji lieli izmērā (< 50,000 rows).
- Jūsu failus jāiekļauj trešo pušu SaaS platformās vai patērētāju lietotnēs (piem., Google Sheets).
- Jūs nevarat kontrolēt gala klienta vidi, kas lasa failu.
Pārslēdzieties uz XLSB, ja:
- Jūs veidojat iekšējus cauruļvādus, grupas darbus, ETL sistēmas vai darbinieku uzdevumus, kas apstrādā milzīgus datu izvilkumus (> 100,000 rows).
- Jūsu serveri saskaras ar atmiņas izsīkuma (OOM) kļūdām, veicot izklājlapas serializāciju vai deserializāciju.
- Jums jāsamazina S3/Blob glabāšanas nospiedumi un tīkla pārsūtīšanas laiks lieliem periodiskajiem finanšu modeļiem vai datu eksportiem.
Pārslēgšanās uz XLSB bieži vien ir tik vienkārša kā konfigurācijas virknes maiņa jūsu eksportēšanas pakalpojumā, tomēr tā nodrošina 3‑ līdz 5‑reizes lielāku caurlaidību, kas parasti prasa nedēļas ilgu koda optimizāciju.
Biežāk uzdotie jautājumi (BUJ)
**Q1: Vai XLSB fails atbalsta tieši tādus pašus rindu un kolonnu ierobežojumus kā XLSX fails? Jā; gan XLSB, gan XLSX dalās tajā pašā režģa griestā – 1 048 576 rindas un 16 384 kolonnas katrā darblapā.
**Q2: Vai XLSB fails var droši saglabāt VBA makrokomandas, nemainot tā faila paplašinājumu?
Jā, atšķirībā no XLSX (kas, lai izpildītu kodu, jāuzglabā kā XLSM), XLSB atbalsta bināru VBA makro uzglabāšanu iebūvēti tajā pašā .xlsb faila formātā.
**Q3: Kāpēc saglabājot failu kā XLSB, tā izmērs samazinās, ja abi formāti jau ir ZIP saspiežami? XLSB likvidē garlaicīgus teksta marķēšanas tagus un kodē šūnu pozīcijas, ierakstus un neapstrādātas skaitliskās vērtības ciešos bināros baitu plūsmos, kas saspiest daudz blīvāk nekā vienkāršas XML virknes.
**Q4: Vai Google Sheets var tieši importēt un rediģēt XLSB failus?
Nē; Google Sheets nevar dabiski atvērt vai konvertēt .xlsb failus tieši, tāpēc tos jākonvertē uz .xlsx vai CSV pirms importēšanas.
**Q5: Vai XLSB faili ir vairāk pakļauti datu bojājumiem nekā XLSX faili? Lai gan XML failus dažkārt var manuāli pārbaudīt vai labot ar teksta redaktoru, ja tie ir daļēji bojāti, binārie BIFF12 plūsmu dati prasa stingras baitu nobīdes un ir grūti atjaunojami manuāli, ja struktūras sektori ir bojāti.