Kemas Kini Terakhir: 20 Ogos, 2026
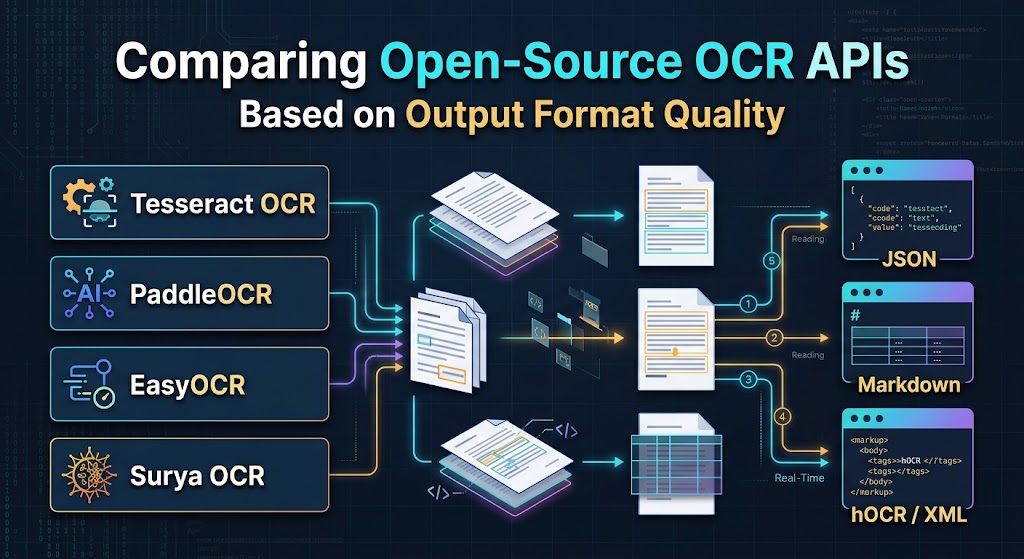
Membandingkan API OCR Sumber Terbuka Berdasarkan Kualiti Format Output
Apabila jurutera menilai enjin Pengecaman Aksara Optik (OCR), kadar ralat aksara (CER) dan kadar ralat perkataan (WER) biasanya mendominasi penanda aras. Walaupun ketepatan pengenalan adalah penting, ia hanya menyelesaikan separuh masalah dalam pengeluaran.
Jika anda sedang mengurai PDF berbilang lajur yang kompleks, mengekstrak item baris daripada resit, atau memasukkan kertas putih ke dalam paip penanaman LLM, tampungan teks mentah menghasilkan beban kerja kejuruteraan yang besar. Rentetan aksara tanpa kesedaran susun atur, susunan bacaan logik, atau data koordinat memaksa pasukan anda menulis pengurai heuristik yang rapuh.
Pembeza sebenar untuk aliran kerja dokumen moden ialah kualiti format output: sejauh mana enjin secara konsisten dan bersih menyampaikan koordinat, susunan bacaan, hierarki struktur, dan data jadual.
Berikut ialah perbandingan yang berfokus pada kejuruteraan bagi empat enjin OCR sumber terbuka terkemuka—Tesseract, PaddleOCR, EasyOCR, dan Surya OCR—menilai bagaimana output mereka berkelakuan dalam paip automatik.
Format Output Umum: Apa yang Sebenarnya Diperlukan Jurutera
Setiap pakej API OCR memaparkan teks yang dikesan secara berbeza. Memahami format-format ini membantu menentukan berapa banyak pemprosesan lanjutan yang diperlukan oleh aliran kerja anda:
- Plain Text (
.txt): Representasi paling mudah. Ia menghilangkan semua metadata kedudukan dan menggabungkan susun atur berbilang lajur menjadi bacaan mendatar, yang boleh mengacau perenggan. - Archival Standards (
hOCR,ALTO XML): Format berasaskan XML/HTML yang standard dalam arkib perpustakaan. Ia menyematkan koordinat, anggaran fon, dan penilaian keyakinan di dalam nod DOM. Sangat kukuh untuk pembinaan semula dokumen, tetapi berat untuk perkhidmatan mikro. - Structured JSON: Pilihan lalai untuk backend web moden. Menyampaikan tatasusunan koordinat (kotak sempadan atau poligon), penilaian keyakinan, dan struktur hierarki blok/garis/perkataan.
- Markdown (
.md) / HTML Tables: Standard moden untuk Retrieval-Augmented Generation (RAG). Mengekalkan bahagian semantik (tajuk, senarai, teks tebal) dan matriks tabular tanpa memerlukan pembinaan semula ruang menurunan.
1. Tesseract OCR
Diselenggarakan oleh Google, Tesseract tetap menjadi kuda kerja asas OCR sumber terbuka. Seni binaannya sangat bergantung pada algoritma segmentasi halaman tradisional yang disokong oleh enjin aksara berasaskan LSTM.
Format Output Asli
- Output Utama: Teks biasa, hOCR (HTML), ALTO XML, TSV (Nilai Dipisahkan Tab), dan PDF/A boleh cari.
- Kesedaran Susun Atur: Heuristik berasaskan peraturan melalui Mod Segmentasi Halaman (PSM).
Analisis Format Output
- Di Mana Ia Cemerlang: Eksport
TSVdanhOCRTesseract adalah piawai dan dapat diramalkan. Satu eksport TSV mengembalikan lajur berstruktur untuklevel,page_num,block_num,par_num,line_num,word_num,left,top,width,height, danconf. Jika anda menukar arkib kertas kepada PDF yang boleh dicari atau memerlukan pematuhan ketat kepada piawaian institusi, Tesseract mengendalikan ini secara asli tanpa kod lekap khusus. - Di Mana Ia Kurang: Tesseract tidak mempunyai API JSON asli. Menggunakan outputnya dalam Python atau Node.js memerlukan parsing fail XML/TSV atau menggunakan pembungkus seperti
pytesseract. Enjin susun aturnya juga menghadapi kesukaran dengan aliran kolumn bukan piawai, kerap mencampur teks dari kolumn bersebelahan melainkan potongan sempadan manual disediakan.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Disokong oleh kerangka kerja PaddlePaddle milik Baidu, PaddleOCR telah memperoleh penerimaan meluas kerana modelnya yang ringan, liputan berbilang bahasa yang luas, dan set alat analisis dokumen khusus (PP-Structure).
Format Output Asli
- Output Utama: Senarai/Pemeta Python, JSON mentah, lapisan visualisasi, dan HTML berstruktur melalui PP-Structure.
- Kesedaran Susun Atur: Tinggi (menggunakan model pembelajaran mendalam untuk penguraian susun atur, pengelasan orientasi, dan pemulihan jadual).
Analisis Format Output
- Di Mana Ia Cemerlang: PaddleOCR standard mengembalikan koordinat poligon 4 titik (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) bersama rentetan teks dan skor keyakinan. Ini mengendalikan teks yang condong atau melengkung dengan baik. Walau bagaimanapun, kekuatan sebenar terletak pada suite PP-Structure, yang mengesan kawasan susun atur (tajuk, teks, jadual, gambar) dan mengurai jadual secara langsung ke dalam rentetan HTML sah (<table>...</table>). Ini menghapuskan keperluan untuk mengira sel secara manual daripada kotak sempadan. - Di Mana Ia Kurang: API asas mengembalikan tatasusunan bersarang yang tidak mempunyai kunci sifat standard merentasi versi yang berbeza. Untuk aplikasi berstruktur, pembangun biasanya menulis penyesuai antara untuk menstandardkan nama medan (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Dibina atas PyTorch oleh JaidedAI, EasyOCR direka untuk penerimaan pemaju yang cepat. Ia menggabungkan CRAFT (Character Region Awareness for Text Detection) dengan rangkaian pengenalan pembelajaran mendalam ke dalam API minimal.
Format Output Asli
- Output Utama: Senarai Python yang mengandungi tuple koordinat, rentetan yang dikenali, dan nilai keyakinan.
- Kesedaran Susun Atur: Rendah hingga sederhana (penasaran baris teks sahaja; tiada penguraian struktur peringkat dokumen).
Analisis Format Output
- Di Mana Ia Cemerlang: Kesederhanaan objek kembali tidak tertandingi:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Memetakan output ini kepada respons REST standard atau menserialkannya secara langsung ke GeoJSON/skema khusus hanya memerlukan beberapa baris kod. Ia berfungsi dengan boleh dipercayakan pada teks dalam adegan semula jadi, plat nombor, dan potongan dokumen terasing.
- Di Mana Ia Kurang: EasyOCR tidak melakukan analisis susun atur dokumen secara holistik. Ia tidak mengenal pasti jadual, hierarki tajuk, atau urutan bacaan merentasi lajur kompleks. Menggunakan EasyOCR pada kertas akademik dua lajur sering menghasilkan kepingan teks yang berselang-seli melainkan digabungkan dengan model pengesanan susun atur huluan (seperti YOLO atau LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya ialah kerangka kerja OCR pembelajaran mendalam moden yang direka khusus untuk pemahaman dokumen kompleks dan saluran pengambilan LLM.
Format Output Asli
- Output Utama: Struktur JSON bermodel Pydantic, indeks urutan bacaan logik, wilayah sempadan susun atur, dan poligon pengesanan baris.
- Kesedaran Susun Atur: Sangat tinggi (analisis susun atur berasaskan pembelajaran mendalam dan penyusunan urutan bacaan).
Analisis Format Output
- Di Mana Ia Cemerlang: Surya secara langsung menangani cabaran kejuruteraan AI moden. Daripada menganggap dokumen dibaca dari atas ke bawah, kiri ke kanan, Surya menggunakan model khusus untuk meramalkan urutan bacaan. Ia mengumpulkan baris ke dalam blok semantik logik, mengendalikan rentang berbilang lajur secara semula jadi, dan menghasilkan struktur berjenis melalui Pydantic. Ini menjadikan pengambilan data ke dalam pangkalan data vektor dan penukar Markdown menjadi langsung dan boleh dipercayai.
- Di Mana Ia Kurang: Sebagai kerangka kerja berasaskan PyTorch yang lebih baru dan lebih berat, Surya memerlukan pengkomputeran GPU khusus untuk menandingi kadar aliran enjin C++ yang dioptimumkan seperti Tesseract atau model Paddle yang dikwantifikasi. Ia tidak menyasarkan standard arkib lama seperti hOCR atau ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Matriks Perbandingan Langsung
| Keupayaan / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Asli hOCR / ALTO XML | Sokongan Asli | Pihak ketiga sahaja | Tiada | Tiada |
| Geometri Kotak Pembatas | Selari paksi (x, y, w, h) | Poligon 4 titik | Poligon 4 titik | Poligon + Blok Susun Atur |
| Penguraian Jadual | Koordinat TSV sahaja | Rentetan jadual HTML | Tiada | Grid koordinat sel |
| Pengesanan Susunan Bacaan | Berasaskan peraturan (berhenti pada berbilang lajur) | Analisis susun atur ML | Pengelompokan baris asas | Model susunan bacaan khusus |
| Skema JSON Langsung | Memerlukan penukaran | Python Dict / JSON | Python List / JSON | Model Pydantic Bertipe |
| Sasaran Hilir Ideal | PDF Arkib, DMS Warisan | Data Borang/Resit, ERP | Skrip Pantas, Teks Adegan | Pengambilan LLM, Seni Bina RAG |
Cadangan Saluran: Mana Yang Perlu Anda Pilih?
- Pilih Tesseract jika keperluan pematuhan anda memerlukan hasil yang standard
hOCR,ALTO XML, atau PDF/A yang boleh dicari untuk rekod kerajaan atau arkib. - Pilih PaddleOCR jika anda memproses dokumen kewangan operasi (invois, resit, borang cukai) yang mengandungi jadual kompleks tanpa sempadan yang mesti ditukar kepada HTML atau hamparan.
- Pilih EasyOCR jika anda memerlukan perpustakaan ringan berasaskan Python untuk mengesan dan mengekstrak teks daripada imej semula jadi, papan tanda jalan, atau elemen UI yang dipotong tanpa kerumitan konfigurasi.
- Pilih Surya OCR jika anda menyuntik laporan perniagaan tidak berstruktur, kertas penyelidikan, dan panduan teknikal ke dalam LLM atau enjin carian vektor di mana susunan bacaan logik dan sempadan struktur yang bersih adalah penting.
Soalan Lazim (FAQ)
1. Format output OCR sumber terbuka yang mana paling mudah untuk dimasukkan ke dalam Model Bahasa Besar?
JSON yang menyedari susunan bacaan Surya OCR dan jadual HTML PP-Structure PaddleOCR menyediakan representasi paling bersih untuk konteks prompt LLM dan pengindeksan RAG.
2. Bolehkah Tesseract menghasilkan respons JSON secara asli tanpa alat pihak ketiga?
Tidak, Tesseract mengeluarkan teks, TSV, PDF, dan hOCR/ALTO XML secara asli; menghasilkan JSON memerlukan penukaran output TSV atau hOCR menggunakan pengurai antara.
3. Bagaimana koordinat poligon 4‑titik berbeza daripada kotak sempadan selari paksi?
Kotak selari paksi menggunakan [x, y, width, height] dengan andaian teks rata, manakala poligon 4-titik menyediakan empat pasangan koordinat untuk menutup dengan tepat teks yang diputar, condong, atau melengkung.
4. Enjin mana yang mengeluarkan struktur jadual secara langsung ke dalam kod dan bukannya koordinat longgar?
Modul PP-Structure PaddleOCR membina semula sempadan jadual yang dikesan menjadi tag jadual HTML lengkap (<table>, <tr>, <td>), mengelakkan matematik ruang tersuai.
5. Mengapa output EasyOCR standard sukar pada kertas saintifik berbilang lajur?
EasyOCR mengenal pasti baris teks berdasarkan kedekatan setempat dan bukannya hierarki susun atur global, menyebabkan teks dari lajur bersebelahan bercampur melainkan dibatasi oleh enjin susun atur luaran.