Terakhir Dikemas Kini: 30 Sep, 2026
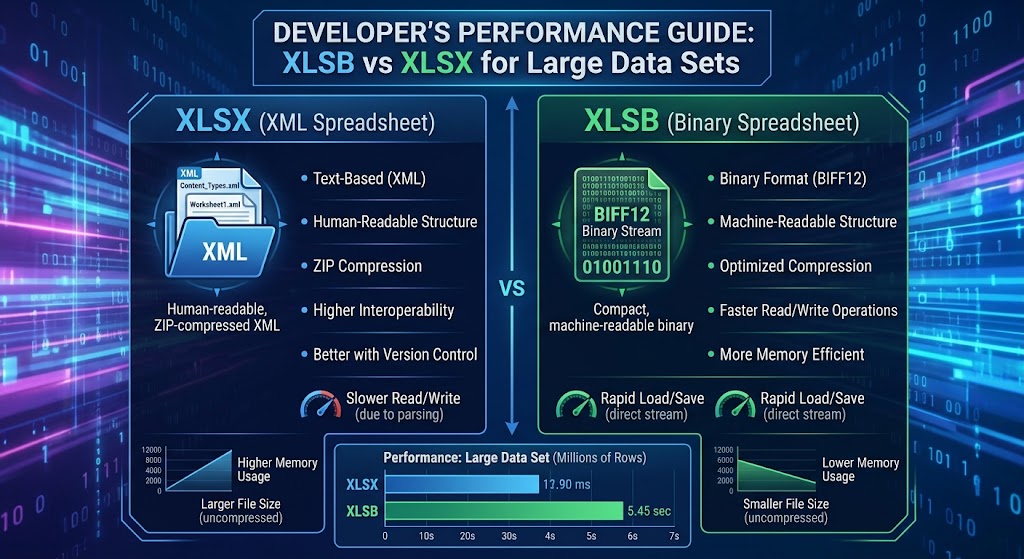
XLSB vs XLSX untuk Set Data Besar: Panduan Prestasi Pembangun
Jika anda membina paip data, enjin pelaporan backend, atau alat analitik yang berinteraksi dengan Microsoft Excel, anda mungkin telah menemui “halangan”.
Seorang pengguna memuat naik buku kerja 450,000 baris. Pelayan anda memulakan thread pekerja, penggunaan memori melonjak ke gigabait, pengumpulan sampah membekukan masa jalan, dan pelaksanaan anda tamat masa. Anda memeriksa muatan: ia adalah fail .xlsx standard.
Untuk menyelesaikan ini, pemaju sering menghabiskan hari-hari melaksanakan pemecahan, pengurai aliran, atau memindahkan fail ke pekerja latar belakang. Namun, salah satu pengoptimuman paling berkesan memerlukan tiada reka bentuk semula seni bina: menukar sambungan fail dari .xlsx kepada .xlsb.
Dalam panduan ini, kami menyelami selok-belok kedua-dua format, meneliti mengapa seni bina dalaman mereka menghasilkan ciri prestasi yang berbeza secara radikal, membandingkan penanda aras konkrit merentasi Python dan .NET, serta menggariskan peraturan jelas bila menggunakan buku kerja binari dalam produksi.
1. Di Sebalik Tabir: OpenXML vs. BIFF12
Untuk memahami mengapa prestasi berbeza begitu dramatik pada set data besar, kita mesti melihat bagaimana setiap format menyimpan rekod pada cakera.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Kedua-dua fail .xlsx dan .xlsb adalah kontena ZIP termampat yang mematuhi Open Packaging Conventions (OPC). Jika anda menamakan semula mana-mana fail kepada .zip dan mengekstraknya, anda akan melihat susun atur direktori yang biasa: _rels, docProps, dan xl/worksheets/.
Perbezaan kritikal terletak di dalam folder xl/worksheets/:
- XLSX menyimpan helaian sebagai teks XML biasa (
sheet1.xml). - XLSB menyimpan helaian sebagai aliran binari proprietari (
sheet1.bin), yang dikodkan menggunakan BIFF12 Microsoft (Binary Interchange File Format 12).
Bagaimana XLSX Menyandikan Data (XML DOM Beban)
Dalam helaian kerja XLSX, setiap sel diisytiharkan dengan tag XML yang jelas:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Apabila membaca baris ini, masa jalan anda mesti:
- Menyahmampat aliran deflate mentah menjadi teks.
- Menjanakan token dan menghurai aksara rentetan ke dalam DOM XML atau aliran acara SAX.
- Sahkan tag pembuka dan penutup (
<c>,</c>,<v>,</v>). - Selesaikan carian rentetan dari jadual
sharedStrings.xmlyang berasingan. - Huraikan teks ASCII
"98234.55"menjadi nombor titik terapung 64-bit IEEE 754.
Setiap sel tunggal menyebabkan beban CPU untuk penguraian rentetan, peruntukan rentetan, dan analisis leksikal. Gandakan ini ke atas 500,000 baris dan 30 lajur (15 juta sel), dan CPU membelanjakan jauh lebih banyak kitaran untuk menguraikan sintaks berbanding memproses nilai domain.
Bagaimana XLSB Menyandikan Data (BIFF12 Binary Stream)
BIFF12 membuang penserialan teks sepenuhnya. Daripada penanda rentetan, data disusun sebagai urutan berurutan rekod binari bersaiz berubah:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Sel titik terapung dalam BIFF12 tidak menggunakan representasi rentetan seperti "98234.55". Ia diwakili secara langsung:
- 2 bait untuk ID rekod (contoh,
BrtCellRkatauBrtCellReal) - 4 bait untuk indeks lajur/baris
- 8 bait yang mengandungi struktur bait mentah IEEE 754 berpresisi berganda
Apabila pengurai anda membaca fail XLSB, ia melangkau penguraian leksikal sepenuhnya. Ia membaca pengepala rekod, mengambil 8 bait mentah dari penimbal, menyalinnya terus ke memori, dan menggerakkan penunjuk ke hadapan. Tiada tag untuk disahkan, tiada penukaran jenis rentetan-ke-nombor, dan tiada beban penyahkodan UTF-8 untuk data berangka.
2. Penanda Kuantitatif: Cakera, Memori, dan Kelajuan
Untuk menggambarkan kesan dunia sebenar, pertimbangkan set data simulasi yang mengandungi 750,000 baris dan 25 lajur (campuran cap masa, nombor titik apung, integer, dan kod kategori).
Ujian di bawah menilai data tabular yang serupa disimpan sebagai XLSX dan XLSB.
Persekitaran Ujian
- CPU: AMD Ryzen 9 5900X (12 teras, 24 utas)
- RAM: 64 GB DDR4-3600
- Storan: PCIe 4.0 NVMe SSD
- Masa Jalan: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Metrik Prestasi Utama
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Penambahbaikan |
|---|---|---|---|
| Saiz Fail pada Cakera | 128.4 MB | 68.2 MB | ~47% lebih kecil |
| Masa Simpan / Serialisasi | 42.6 s | 14.1 s | 3.0x lebih cepat |
| Masa Baca (Python DOM parser) | 38.2 s | 8.9 s | 4.3x lebih cepat |
| Masa Baca (Enjin Rust/C) | 6.4 s | 1.9 s | 3.3x lebih cepat |
| Peruntukan Heap Puncak semasa Membaca | ~1.85 GB | ~510 MB | ~72% pengurangan |
Mengapa Fail XLSX Lebih Kecil
Walaupun kedua-dua format menggunakan pemampatan ZIP standard, aliran binari memampatkan dengan jauh lebih cekap berbanding teks XML yang berlebihan:
- Sintaks berlebihan dihapuskan: XML mengandungi tag berulang (
<c r=\"AA1\" s=\"1\">) pada setiap rekod. Walaupun pemampatan ZIP mengurangkan rentetan yang berulang, aliran data yang tidak dimampatkan sangat besar. - Ketumpatan numerik: Dalam XML, nombor
12345678.9012memerlukan 14 bait teks ASCII. Dalam BIFF12, ia disimpan sebagai double 8-bait (atau dipak dalam rekodRK4-bait jika ia memenuhi peraturan ketepatan tertentu).
3. Jejak Memori dan Tekanan Pengumpulan Sampah
Untuk perkhidmatan web dan mikroperkhidmatan yang mengendalikan permintaan serentak, kelajuan CPU hanyalah separuh daripada perjuangan; jejak memori adalah tempat aplikasi sebenarnya gagal.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Apabila pengurai XML memproses fail XLSX 100 MB, ia mesti mencipta beribu-ribu token rentetan sementara, penampan kepingan rentetan, dan carian kamus. Dalam bahasa yang mengumpul sampah (Java, C#, Go, Node.js, Python), ini menghasilkan fragmentasi timbunan yang melampau dan memaksa masa jalan ke jeda Pengumpulan Sampah (GC) yang kerap.
Kerana penapisan XLSB beroperasi secara langsung pada kepingan bait lebar tetap, parser dapat membaca data ke dalam struktur yang dialokasikan pada stack atau penampung bait yang boleh digunakan semula. Hasilnya ialah jejak memori yang berkurang secara dramatik dan tiada gangguan pada pengagih masa jalan.
4. Contoh Pelaksanaan Pembangun
Mari kita lihat bagaimana memanfaatkan XLSB dalam rantaian alat pemaju yang biasa.
Python: Berpindah dari OpenPyXL ke Calamine / PyXLSB
Standard pandas.read_excel('data.xlsx') secara lalai menggunakan openpyxl, yang membina pokok berat dalam memori.
Untuk memproses fail XLSB yang besar dengan kelajuan maksimum, gunakan enjin calamine yang dikuasakan oleh Rust (tersedia melalui python-calamine dan terintegrasi dalam Pandas moden):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Jika anda mengulangi set data besar baris demi baris tanpa memuatkan seluruh matriks ke dalam DataFrame, pyxlsb menyediakan iterator penstriman ringan:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Pengambilan Aliran Berprestasi Tinggi
Dalam .NET, perpustakaan seperti ClosedXML atau EPPlus sangat baik untuk penjanaan standard, tetapi untuk memasukkan fail besar tanpa kehabisan memori, ExcelDataReader dengan sokongan XLSB sangat pantas:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Pertukaran Seni Bina: Bila TIDAK Perlu Menggunakan XLSB
Walaupun mempunyai kelebihan prestasi yang luar biasa, XLSB bukanlah penyelesaian ajaib. Anda harus menimbang beberapa pertukaran operasi sebelum menguatkannya di seluruh tumpukan anda:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosistem dan Sokongan Pustaka
- XLSX: Serbaguna. Hampir setiap bahasa, perpustakaan, alat SaaS (Google Sheets, Airtable, Tableau), dan pengurai web menyokong OpenXML secara asli.
- XLSB: Kurang meluas. Walaupun Excel, LibreOffice, dan perpustakaan pembangun matang (
ExcelDataReader,pyxlsb,calamine,Aspose) menyokongnya, banyak pakej ringan atau pengurai JavaScript berasaskan web murni (seperti versi lamaSheetJS) mempunyai sokongan terhad atau hanya baca.
2. Git & Perbezaan Kawalan Versi
- XLSX: Oleh kerana ia mengandungi teks XML di dalam kontena ZIP, utiliti baris perintah dan hook Git dapat mengekstrak dan memformat XML untuk menghasilkan perbezaan struktur yang boleh dibaca antara komit.
- XLSB: Data binari tulen. Sistem kawalan versi menganggapnya secara ketat sebagai blob binari yang tidak dapat dilihat, menghapuskan sebarang kemungkinan perbezaan terperinci atau gabungan pada peringkat baris.
3. Rendering Klien Web
Jika seni bina anda bergantung pada rendering hamparan kerja secara langsung dalam penyemak imbas melalui WebAssembly atau JavaScript sisi klien, pengurai XLSX jauh lebih matang dan kurang terdedah kepada pepijat rendering kes-kes tepi berbanding pengurai binari sisi klien.
4. Saluran Pengambilan Pihak Ketiga
Jika anda mengeksport fail untuk pelanggan perusahaan luar, banyak dasar keselamatan korporat yang ketat menandakan fail .xlsb. Oleh kerana fail BIFF12 boleh menyimpan makro VBA dengan cara yang sama seperti fail .xlsm (tanpa memerlukan sambungan berasingan), beberapa penapis mel dan pengimbas firewall mengkarantina muatan naik .xlsb sebagai ancaman berpotensi yang mengandungi makro.
6. Perbandingan Ringkas: Format Mana yang Menang?
| Ciri | XLSX | XLSB | Pemenang |
|---|---|---|---|
| Kelajuan Baca / Huraikan | Sederhana hingga Lemah | Sangat Cepat | XLSB |
| Kelajuan Tulis / Penjanaan | Berintensiti CPU | Pantas | XLSB |
| Pemampatan Fail | Baik | Cemerlang (~40-50% lebih kecil) | XLSB |
| Peruntukan Memori | Tinggi (Tekanan GC berat) | Rendah (Pembacaan bait langsung) | XLSB |
| Interoperabiliti Alat | Sejagat | Tinggi, tetapi selektif | XLSX |
| Geseran Pengimbasan Keselamatan | Minimum | Positif palsu sesekali | XLSX |
| Keupayaan Makro | Tidak (.xlsm diperlukan) | Ya (Menyokong makro secara asli) | Ikatan |
7. Keputusan Pembangun
Gunakan XLSX apabila:
- Fail bersaiz kecil hingga sederhana (< 50,000 baris).
- Fail anda mesti diambil oleh platform SaaS pihak ketiga atau aplikasi pengguna (contoh, Google Sheets).
- Anda tidak dapat mengawal persekitaran klien akhir yang membaca fail.
Beralih kepada XLSB apabila:
- Anda sedang membina paip dalaman, kerja batch, sistem ETL, atau tugas pekerja yang mengendalikan ekstrak data besar (> 100,000 baris).
- Pelayan anda mengalami ralat memori habis (OOM) semasa penserialan atau penyahserian hamparan kerja.
- Anda perlu meminimumkan jejak storan S3/blob dan masa transit rangkaian untuk model kewangan berulang yang besar atau eksport data.
Pertukaran kepada XLSB selalunya semudah menukar rentetan konfigurasi dalam perkhidmatan eksport anda, namun ia memberikan peningkatan throughput sebanyak 3x hingga 5x yang biasanya memerlukan minggu-minggu pengoptimuman kod.
Soalan Lazim (FAQ)
**Q1: Adakah fail XLSB menyokong had baris dan lajur yang tepat sama seperti fail XLSX? Ya; kedua-dua XLSB dan XLSX berkongsi had atas grid yang sama tepat iaitu 1,048,576 baris dengan 16,384 lajur bagi setiap helaian kerja.
**Q2: Bolehkah fail XLSB menyimpan makro VBA dengan selamat tanpa menukar sambungan failnya?
Ya, tidak seperti XLSX (yang memerlukan penyimpanan sebagai XLSM untuk menjalankan kod), XLSB menyokong penyimpanan makro VBA binari secara asli dalam format fail .xlsb yang sama.
**Q3: Mengapa menyimpan fail sebagai XLSB mengurangkan saiznya jika kedua-dua format sudah dimampatkan dengan ZIP? XLSB menghapuskan tag penanda teks yang berlebihan dan mengekod kedudukan sel, rekod, dan nilai numerik mentah ke dalam aliran bait binari yang ketat yang memampatkan jauh lebih padat berbanding rentetan XML biasa.
**Q4: Bolehkah Google Sheets mengimport dan menyunting fail XLSB secara langsung?
Tidak; Google Sheets tidak dapat membuka atau menukar fail .xlsb secara asli, memerlukan anda menukarnya kepada .xlsx atau CSV sebelum mengimport.
**Q5: Adakah fail XLSB lebih cenderung kepada kerosakan data berbanding fail XLSX? Walaupun fail XML kadang-kadang boleh diperiksa atau dibaiki secara manual dengan penyunting teks apabila sebahagiannya rosak, aliran binari BIFF12 memerlukan offset bait yang ketat dan sukar dipulihkan secara manual jika sektor struktur rosak.