Laatst bijgewerkt: 20 aug. 2026
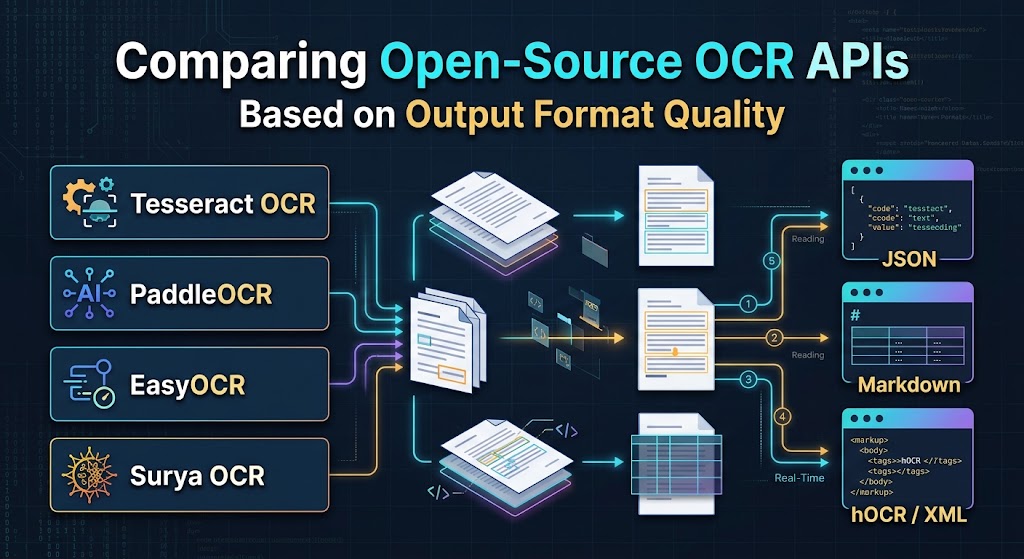
Vergelijken van Open-Source OCR API’s op basis van outputformaatkwaliteit
Wanneer ingenieurs Optical Character Recognition (OCR)-engines evalueren, domineren character error rate (CER) en word error rate (WER) meestal de benchmarks. Hoewel herkenningsnauwkeurigheid essentieel is, lost het slechts de helft van het probleem in productie op.
Als je complexe PDF’s met meerdere kolommen parseert, regelitems van bonnetjes extraheert, of whitepapers in een LLM-embedde-pijplijn opneemt, veroorzaken ruwe tekstdumpen enorme engineering overhead. Een reeks tekens zonder lay-outbewustzijn, logische leesvolgorde of coördinaten dwingt je team om fragiele heuristische parsers te schrijven.
De echte onderscheidende factor voor moderne documentworkflows is outputformaatkwaliteit: hoe consistent en schoon een engine coördinaten, leesvolgorde, structurele hiërarchie en tabelgegevens levert.
Hieronder staat een engineeringgerichte vergelijking van vier toonaangevende open-source OCR-engines—Tesseract, PaddleOCR, EasyOCR en Surya OCR—die evalueert hoe hun output zich gedraagt binnen geautomatiseerde pijplijnen.
De gangbare outputformaten: wat ingenieurs echt nodig hebben
Elke OCR API verpakt gedetecteerde tekst anders. Het begrijpen van deze formaten helpt bepalen hoeveel post-processing uw pipeline vereist:
- Platte Tekst (
.txt): De eenvoudigste weergave. Het verwijdert alle positionele metadata en zet meerkolomsindelingen om in horizontale leesvolgorde, wat alinea’s kan verwarren. - Archiveringsstandaarden (
hOCR,ALTO XML): XML/HTML-gebaseerde formaten die standaard zijn in bibliotheekarchivering. Ze embedden coördinaten, lettertype‑schattingen en betrouwbaarheidsbeoordelingen in DOM‑knooppunten. Zeer robuust voor documentreconstructie, maar omvangrijk voor microservices. - Gestructureerde JSON: De standaardkeuze voor moderne web‑backends. Levert coördinaat‑arrays (begrenzingskaders of polygonen), betrouwbaarheidsbeoordelingen en hiërarchische blok‑/lijn‑/woordstructuren.
- Markdown (
.md) / HTML‑tabellen: De moderne standaard voor Retrieval‑Augmented Generation (RAG). Behoudt semantische secties (koppen, lijsten, vetgedrukte tekst) en tabel‑matrixen zonder dat downstream ruimtelijke reconstructie nodig is.
1. Tesseract OCR
Onderhouden door Google, blijft Tesseract de fundamentele werkpaard van open‑source OCR. De architectuur leunt sterk op traditionele paginasegmentatie‑algoritmen, aangevuld met een LSTM‑gebaseerde tekenengine.
Native uitvoerformaten
- Primaire uitvoer: Platte tekst, hOCR (HTML), ALTO XML, TSV (Tab-gescheiden waarden), en doorzoekbare PDF/A.
- Lay-outbewustzijn: Regelgebaseerde heuristieken via Page Segmentation Modes (PSM).
Analyse van uitvoerformaten
- Waar het uitblinkt: De
TSV- enhOCR-exporten van Tesseract zijn gestandaardiseerd en voorspelbaar. Een enkele TSV-export levert gestructureerde kolommen voorlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightenconf. Als je papieren archieven converteert naar doorzoekbare PDF’s of strikte naleving van institutionele standaarden nodig hebt, verwerkt Tesseract dit native zonder aangepaste glue‑code. - Waar het tekortschiet: Tesseract heeft geen native JSON‑API. Het consumeren van de output in Python of Node.js vereist het parseren van XML/TSV‑bestanden of het gebruiken van wrappers zoals
pytesseract. De lay-outengine heeft ook moeite met niet‑standaard kolomstroom, waardoor tekst uit aangrenzende kolommen vaak wordt gemengd tenzij handmatige begrenzings‑croppen worden geleverd.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Ondersteund door het PaddlePaddle‑framework van Baidu, heeft PaddleOCR brede adoptie verworven dankzij zijn lichtgewicht modellen, uitgebreide meertalige dekking en toegewijde documentanalyse‑toolkit (PP-Structure).
Native uitvoerformaten
- Primaire Uitvoer: Python-lijsten/dictionaries, ruwe JSON, visualisatie-overlays en gestructureerde HTML via PP-Structure.
- Lay-outbewustzijn: Hoog (met gebruik van deep learning-modellen voor lay-out parsing, oriëntatieclassificatie en tabelherstel).
Analyse van uitvoerformaten
- Waar het uitblinkt: Standaard PaddleOCR retourneert 4-punts polygoncoördinaten (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) naast tekststrings en vertrouwensscores. Dit verwerkt scheve of gebogen tekst moeiteloos. Echter, de echte kracht ligt in de PP-Structure suite, die lay-out regio’s (titel, tekst, tabel, figuur) detecteert en tabellen direct parseert naar geldige HTML-strings (<table>...</table>). Dit elimineert de noodzaak om handmatig celspannen te berekenen vanuit begrenzingskaders. - Waar het tekortschiet: De basis-API retourneert geneste arrays die geen standaard eigenschaps-sleutels hebben in verschillende versies. Voor gestructureerde toepassingen schrijven ontwikkelaars meestal een tussenadapter om veldnamen te standaardiseren (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Bouwt op PyTorch van JaidedAI, EasyOCR is ontwikkeld voor snelle adoptie door ontwikkelaars. Het verpakt CRAFT (Character Region Awareness for Text Detection) met deep learning herkenningsnetwerken in een minimale API.
Native uitvoerformaten
- Primaire Uitvoer: Python-lijsten met tuples van coördinaten, herkende strings en vertrouwenswaarden.
- Lay-outbewustzijn: Laag tot matig (alleen tekstregeldetectie; geen documentniveau structurele parsing).
Analyse van uitvoerformaten
- Waar het uitblinkt: De eenvoud van het retourobject is ongeëvenaard:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Het in kaart brengen van deze output naar een standaard REST-respons of het direct serialiseren naar GeoJSON/aangepaste schema’s vereist slechts een paar regels code. Het presteert betrouwbaar bij natuurlijke scène-tekst, kentekenplaten en geïsoleerde documentuitsneden.
- Waar het tekortschiet: EasyOCR voert geen holistische documentlay-outanalyse uit. Het identificeert geen tabellen, kophiërarchieën of leesvolgordes over complexe kolommen. Het gebruik van EasyOCR op een tweekoloms academisch artikel levert vaak door elkaar geweven tekstfragmenten op, tenzij het wordt gecombineerd met een upstream lay-outdetectiemodel (zoals YOLO of LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya is een modern deep-learning OCR-framework dat specifiek is ontworpen voor complexe documentbegrip en LLM-innamepijplijnen.
Native uitvoerformaten
- Primaire Uitvoer: Pydantic-gestructureerde JSON-structuren, logische leesvolgorde-indexen, lay-out begrenzingsgebieden en lijn-detectiepolygonen.
- Lay-outbewustzijn: Uitzonderlijk hoog (deep-learning-gebaseerde lay-outanalyse en sortering van leesvolgorde).
Analyse van uitvoerformaten
- Waar het uitblinkt: Surya pakt direct de uitdagingen van moderne AI-engineering aan. In plaats van ervan uit te gaan dat documenten van boven naar beneden, links naar rechts worden gelezen, zet Surya een speciaal model in om de leesvolgorde te voorspellen. Het groepeert regels in logische semantische blokken, behandelt multi‑kolomspannes op natuurlijke wijze, en levert getypte structuren via Pydantic. Dit maakt downstream ingestie in vector‑databases en Markdown‑converters direct en betrouwbaar.
- Waar het tekortschiet: Als een nieuwer, zwaarder PyTorch‑gebaseerd framework vereist Surya toegewijde GPU‑rekenkracht om de doorvoersnelheid van geoptimaliseerde C++‑engines zoals Tesseract of gekwantificeerde Paddle‑modellen te evenaren. Het richt zich niet op legacy archiveringsstandaarden zoals hOCR of ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Head-to-Head vergelijkingsmatrix
| Capaciteit / Formaat | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Native hOCR / ALTO XML | Native-ondersteuning | Alleen via derden | Geen | Geen |
| Bounding Box-geometrie | As-uitgelijnd (x, y, w, h) | 4-punts polygoon | 4-punts polygoon | Polygoon + lay-outblokken |
| Tabelparsing | Alleen coördinaat-TSV | HTML-tabelstrings | Geen | Celcoördinatieroosters |
| Detectie van leesvolgorde | Regelgebaseerd (onderbreekt bij meerdere kolommen) | ML lay-outanalyse | Basislijngroepering | Specifiek leesvolgorde-model |
| Directe JSON-schema’s | Vereist conversie | Python Dict / JSON | Python List / JSON | Getypte Pydantic-modellen |
| Ideale downstream-doel | Archief-PDF’s, Legacy DMS | Formulier-/Ontvangstgegevens, ERP’s | Snelle scripts, scène-tekst | LLM-inname, RAG-architecturen |
Pipeline‑aanbevelingen: welke moet je kiezen?
- Kies Tesseract als uw nalevingsvereisten gestandaardiseerde
hOCR,ALTO XMLof doorzoekbare PDF/A-leveringen voor overheids- of archiefdocumenten eisen. - Kies PaddleOCR als u operationele financiële documenten (facturen, bonnetjes, belastingformulieren) verwerkt die complexe, randloze tabellen bevatten die naar HTML of spreadsheets moeten worden geconverteerd.
- Kies EasyOCR als u een lichtgewicht, Python-achtige bibliotheek nodig heeft om tekst te detecteren en te extraheren uit natuurlijke afbeeldingen, verkeersborden of bijgesneden UI‑elementen zonder configuratie‑gedoe.
- Kies Surya OCR als u ongestructureerde bedrijfsrapporten, onderzoeksartikelen en technische handleidingen in een LLM of vector‑zoekmachine stopt, waarbij logische leesvolgorde en schone structurele grenzen van het grootste belang zijn.
Veelgestelde vragen (FAQ)
1. Welk open‑source OCR‑uitvoerformaat is het gemakkelijkst om in te voeren in grote taalmodellen?
De leesvolgorde‑bewuste JSON van Surya OCR en de HTML‑tabellen van PaddleOCR PP-Structure bieden de schoonste weergaven voor LLM‑promptcontexten en RAG‑indexering.
2. Kan Tesseract JSON‑responses native produceren zonder tools van derden?
Nee, Tesseract levert tekst, TSV, PDF en hOCR/ALTO XML van nature; het produceren van JSON vereist het converteren van de TSV- of hOCR-uitvoer met behulp van een tussenliggende parser.
3. Hoe verschillen 4‑punts polygoncoördinaten van as‑uitgelijnde begrenzingskaders?
Asymmetrisch uitgelijnde vakken gebruiken [x, y, width, height] onder de veronderstelling van platte tekst, terwijl 4-punts polygonen vier coördinaatparen bieden om gedraaide, scheve of gebogen tekstregels nauwkeurig af te sluiten.
4. Welke engine levert tabelstructuren direct in code in plaats van losse coördinaten?
De PP-Structure module van PaddleOCR reconstrueert gedetecteerde tabelranden tot volledige HTML-tabeltags (<table>, <tr>, <td>), waardoor aangepaste ruimtemathematica wordt vermeden.
5. Waarom heeft de standaard EasyOCR-uitvoer moeite met wetenschappelijke artikelen met meerdere kolommen?
EasyOCR identificeert tekstregels op basis van lokale nabijheid in plaats van globale lay-out hiërarchie, waardoor tekst uit aangrenzende kolommen verstrengeld raakt tenzij begrensd door een externe lay-out engine.