Laatst bijgewerkt: 30 sep, 2026
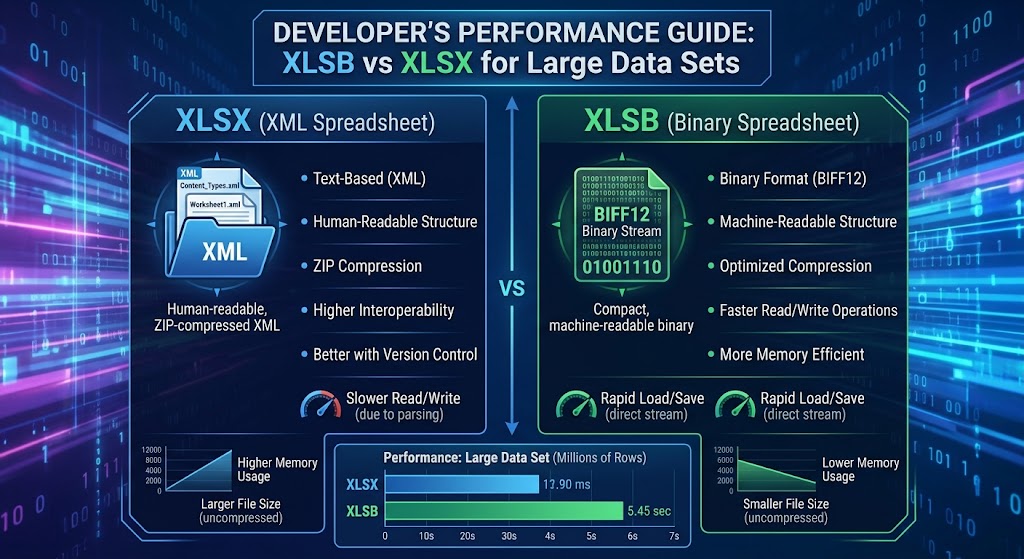
XLSB vs XLSX voor grote datasets: Een prestatiegids voor ontwikkelaars
Als je data‑pipelines, backend‑rapportage‑engines of analysetools bouwt die met Microsoft Excel communiceren, ben je waarschijnlijk tegen "the wall." aangelopen.
Een gebruiker uploadt een werkmap van 450.000 rijen. Je server start worker‑threads, het geheugenverbruik stijgt tot gigabytes, garbage collection bevriest de runtime, en je uitvoering loopt time‑out. Je inspecteert de payload: het is een standaard .xlsx‑bestand.
Om dit op te lossen, besteden ontwikkelaars vaak dagen aan het implementeren van chunking, streaming‑parsers of het offloaden van bestanden naar achtergrond‑workers. Toch vereist een van de meest effectieve optimalisaties geen enkele architecturale herontwerp: het wijzigen van de bestandsextensie van .xlsx naar .xlsb.
In deze gids duiken we onder de motorkap van beide formaten, onderzoeken we waarom hun interne architecturen radicaal verschillende prestatiekenmerken opleveren, vergelijken we concrete benchmarks voor Python en .NET, en schetsen we duidelijke regels voor wanneer binaire werkmappen in productie moeten worden ingezet.
1. Onder de motorkap: OpenXML vs. BIFF12
Om te begrijpen waarom de prestaties zo dramatisch uiteenlopen bij grote datasets, moeten we kijken hoe elk formaat records op schijf opslaat.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Zowel .xlsx- als .xlsb-bestanden zijn gecomprimeerde ZIP-containers die voldoen aan de Open Packaging Conventions (OPC). Als je een van de bestanden hernoemt naar .zip en het uitpakt, zie je een bekende mapstructuur: _rels, docProps en xl/worksheets/.
Het cruciale verschil zit in de map xl/worksheets/:
- XLSX slaat bladen op als platte XML-tekst (
sheet1.xml). - XLSB slaat bladen op als propriëtaire binaire streams (
sheet1.bin), gecodeerd met Microsoft’s BIFF12 (Binary Interchange File Format 12).
Hoe XLSX gegevens codeert (XML DOM Overhead)
In een XLSX-werkblad wordt elke cel gedeclareerd met expliciete XML-tags:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Bij het lezen van deze rij moet je runtime:
- Decomprimeer de ruwe deflate-stroom naar tekst.
- Tokeniseer en parse tekenreeks‑karakters naar een XML DOM‑ of SAX‑gebeurtenisstroom.
- Valideer openings- en sluitings‑tags (
<c>,</c>,<v>,</v>). - Los tekenreeks‑opzoekingen op uit een aparte
sharedStrings.xml‑tabel. - Parseer de ASCII‑tekst
"98234.55"naar een IEEE 754 64‑bit floating‑point‑getal.
Elke enkele cel veroorzaakt CPU‑overhead voor tekenreeks‑parsen, tekenreeks‑allocatie en lexicale analyse. Vermenigvuldig dit over 500.000 rijen en 30 kolommen (15 miljoen cellen), en de CPU besteedt veel meer cycli aan het parseren van syntaxis dan aan het verwerken van domeinwaarden.
Hoe XLSB gegevens codeert (BIFF12 Binary Stream)
BIFF12 gooit tekstserialisatie volledig weg. In plaats van tekenreeks‑markup worden gegevens gerangschikt als een opeenvolgende reeks variabele‑lengte binaire records:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Een floating‑point‑cel in BIFF12 gebruikt geen tekenreeks‑representaties zoals "98234.55". Deze wordt direct weergegeven:
- 2 bytes voor de record‑ID (bijv.
BrtCellRkofBrtCellReal) - 4 bytes voor kolom‑/rij‑indexen
- 8 bytes die de ruwe, IEEE 754 double-precision byte-structuur bevatten
Wanneer uw parser een XLSB‑bestand leest, slaat hij de lexicale parsing volledig over. Hij leest de record‑header, pakt de 8 ruwe bytes uit de buffer, kopieert ze rechtstreeks naar het geheugen en verplaatst de pointer vooruit. Er zijn geen tags om te valideren, geen string‑naar‑nummer typeconversies, en nul UTF‑8‑decodeer‑overhead voor numerieke gegevens.
2. Kwantitatieve benchmarks: schijf, geheugen en doorvoersnelheid
Om de impact in de praktijk te illustreren, beschouw een gesimuleerde dataset die 750.000 rijen en 25 kolommen bevat (een mix van tijdstempels, zwevende-kommagetallen, gehele getallen en categoriecijfers).
De onderstaande tests evalueren identieke tabelgegevens die zowel als XLSX als XLSB zijn opgeslagen.
Testomgeving
- CPU: AMD Ryzen 9 5900X (12 kernen, 24 threads)
- RAM: 64 GB DDR4‑3600
- Opslag: PCIe 4.0 NVMe SSD
- Runtime: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Kernprestatiestatistieken
| Metriek | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Verbetering |
|---|---|---|---|
| Bestandsgrootte op schijf | 128.4 MB | 68.2 MB | ~47% kleiner |
| Opslaan / Serialisatietijd | 42.6 s | 14.1 s | 3,0x sneller |
| Leestijd (Python DOM-parser) | 38.2 s | 8.9 s | 4,3x sneller |
| Leestijd (Rust/C Engine) | 6.4 s | 1.9 s | 3,3x sneller |
| Piekheapallocatie tijdens lezen | ~1.85 GB | ~510 MB | ~72% reductie |
Waarom XLSB-bestanden kleiner zijn
Hoewel beide formaten standaard ZIP-compressie gebruiken, comprimeren binaire streams veel efficiënter dan opgeblazen XML-tekst:
- Redundante syntaxis wordt geëlimineerd: XML bevat repetitieve tags (
<c r="AA1" s="1">) in elk enkel record. Terwijl ZIP-compressie herhaalde strings vermindert, is de ongecomprimeerde datastroom enorm. - Numerieke dichtheid: In XML vereist het getal
12345678.901214 bytes ASCII-tekst. In BIFF12 wordt het opgeslagen als een 8-byte double (of verpakt in een 4-byteRK-record als het binnen specifieke precisieregels past).
3. Geheugenvoetafdruk en druk op Garbage Collection
Voor webservices en microservices die gelijktijdige verzoeken afhandelen, is CPU-snelheid slechts de helft van de strijd; geheugengebruik is waar applicaties daadwerkelijk falen.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Wanneer een XML-parser een XLSX-bestand van 100 MB verwerkt, moet hij duizenden tijdelijke string‑tokens, string‑slice‑buffers en woordenboek‑opzoekingen aanmaken. In garbage‑collected talen (Java, C#, Go, Node.js, Python) veroorzaakt dit extreme heap‑fragmentatie en dwingt het de runtime tot frequente Garbage Collection (GC)-pauzes.
Omdat XLSB-parsing direct werkt op byte‑slices met vaste breedte, kunnen parsers gegevens lezen in stack‑gealloceerde structuren of herbruikbare byte‑buffers. Het resultaat is een dramatisch verkleinde geheugen‑voetafdruk en geen thrashing van de runtime‑allocator.
4. Voorbeeldimplementaties voor ontwikkelaars
Laten we bekijken hoe we XLSB kunnen benutten in gangbare ontwikkelaarstoolchains.
Python: Migreren van OpenPyXL naar Calamine / PyXLSB
Standaard gebruikt pandas.read_excel('data.xlsx') openpyxl, wat een zware in‑memory boom opbouwt.
Om grote XLSB‑bestanden met maximale snelheid te verwerken, gebruik je de Rust‑aangedreven calamine‑engine (beschikbaar via python-calamine en geïntegreerd in moderne Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Als je enorme datasets rij voor rij doorloopt zonder de volledige matrix in een DataFrame te laden, biedt pyxlsb een lichtgewicht streaming‑iterator:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: High-Performance Stream Inname
In .NET zijn bibliotheken zoals ClosedXML of EPPlus uitstekend voor standaardgeneratie, maar voor het inlezen van grote bestanden zonder geheugenuitputting is ExcelDataReader met XLSB‑ondersteuning uitzonderlijk snel:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Architecturale Afwegingen: Wanneer XLSB NIET te gebruiken
Ondanks de overweldigende prestatievoordelen is XLSB geen wondermiddel. Je moet verschillende operationele afwegingen overwegen voordat je het door je hele stack heen afdwingt:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ecosysteem- en Bibliotheekondersteuning
- XLSX: Universeel. Vrijwel elke programmeertaal, bibliotheek, SaaS‑tool (Google Sheets, Airtable, Tableau) en web‑parser ondersteunt OpenXML van nature.
- XLSB: Minder alomtegenwoordig. Terwijl Excel, LibreOffice en volwassen ontwikkelaarsbibliotheken (
ExcelDataReader,pyxlsb,calamine,Aspose) het ondersteunen, hebben veel lichtgewicht pakketten of pure web‑gebaseerde JavaScript‑parsers (zoals oudere versies vanSheetJS) beperkte of alleen‑lezen ondersteuning.
2. Git & Versiebeheer Diffing
- XLSX: Omdat het tekst‑XML bevat binnen een ZIP‑container, kunnen commandoregel‑hulpmiddelen en Git‑hooks het zip‑bestand uitpakken en de XML formatteren om leesbare structurele verschillen tussen commits te genereren.
- XLSB: Pure binaire data. Versiebeheersystemen behandelen het strikt als een ondoorzichtige binaire blob, waardoor elke mogelijkheid voor gedetailleerde diff’s of regel‑niveau merges wordt geëlimineerd.
3. Webclient-weergave
Als uw architectuur afhankelijk is van het direct weergeven van spreadsheets in de browser via WebAssembly of client‑side JavaScript, zijn XLSX‑parsers aanzienlijk rijper en minder vatbaar voor randgeval‑renderingsbugs dan client‑side binaire parsers.
4. Derde-partij Innamepijplijnen
Als u bestanden exporteert voor externe bedrijfsklanten, markeren veel strenge bedrijfsbeveiligingsbeleid .xlsb‑bestanden. Omdat BIFF12‑bestanden VBA‑macro’s op dezelfde manier kunnen opslaan als .xlsm‑bestanden (zonder een aparte extensie te vereisen), plaatsen sommige e‑mailfilters en firewall‑scanners .xlsb‑uploads in quarantaine als potentiële macro‑bevatende bedreigingen.
6. Samenvattende Vergelijking: Welk Formaat Wint?
| Functie | XLSX | XLSB | Winnaar |
|---|---|---|---|
| Leessnelheid / parse‑snelheid | Matig tot slecht | Razendsnel | XLSB |
| Schrijf‑ / generatiesnelheid | CPU‑intensief | Snel | XLSB |
| Bestandscompressie | Goed | Uitstekend (~40-50% kleiner) | XLSB |
| Geheugenallocatie | Hoog (Zware GC-druk) | Laag (Direct byte lezen) | XLSB |
| Interoperabiliteit van tools | Universeel | Hoog, maar selectief | XLSX |
| Wrijving bij beveiligingsscanning | Minimaal | Af en toe valse positieven | XLSX |
| Macro-mogelijkheid | Nee (.xlsm vereist) | Ja (ondersteunt macro’s native) | Gelijkspel |
7. Het Oordeel van de Ontwikkelaar
Gebruik XLSX wanneer:
- Bestanden zijn klein tot middelgroot (< 50.000 rijen).
- Je bestanden moeten worden ingelezen door SaaS-platformen van derden of consumentenapps (bijv. Google Sheets).
- Je kunt de omgeving van de eindgebruiker die het bestand leest niet beheersen.
Schakel over naar XLSB wanneer:
- Je bouwt interne pipelines, batchtaken, ETL-systemen of worker-taken die enorme data-extracties verwerken (> 100.000 rijen).
- Uw servers krijgen out-of-memory (OOM)-fouten tijdens het serialiseren of deserialiseren van spreadsheets.
- U moet de opslagvoetafdrukken van S3/blob en de netwerktijd voor grote terugkerende financiële modellen of data‑exports minimaliseren.
De overstap naar XLSB is vaak zo simpel als het wijzigen van een configuratiestring in uw exportservice, maar levert wel de 3‑ tot 5‑voudige doorvoersnelheidstoename op die normaal weken aan code‑optimalisatie vereist.
Veelgestelde vragen (FAQ)
**Q1: Ondersteunt een XLSB-bestand exact dezelfde rij‑ en kolomlimieten als een XLSX-bestand? Ja; zowel XLSB als XLSX delen exact dezelfde rasterlimiet van 1.048.576 rijen bij 16.384 kolommen per werkblad.
**Q2: Kan een XLSB‑bestand veilig VBA‑macro’s opslaan zonder de bestandsextensie te wijzigen?
Ja, in tegenstelling tot XLSX (dat moet worden opgeslagen als XLSM om code uit te voeren), ondersteunt XLSB native binaire VBA‑macroopslag binnen hetzelfde .xlsb‑bestandsformaat.
**Q3: Waarom verkleint het opslaan van een bestand als XLSB de bestandsgrootte als beide formaten al ZIP‑gecomprimeerd zijn? XLSB elimineert uitgebreide tekstopmaak‑tags en codeert celposities, records en ruwe numerieke waarden in compacte binaire byte‑streams die veel dichter comprimeren dan gewone XML‑strings.
**Q4: Kan Google Sheets XLSB‑bestanden direct importeren en bewerken?
Nee; Google Sheets kan .xlsb‑bestanden niet rechtstreeks openen of converteren, waardoor je ze eerst moet omzetten naar .xlsx of CSV voordat je ze importeert.
**Q5: Zijn XLSB‑bestanden gevoeliger voor gegevenscorruptie dan XLSX‑bestanden? Hoewel XML‑bestanden soms handmatig kunnen worden geïnspecteerd of gerepareerd met een teksteditor bij gedeeltelijke corruptie, vereisen binaire BIFF12‑streams strikte byte‑offsets en zijn ze moeilijk handmatig te herstellen als structurele sectoren beschadigd zijn.