Ostatnia aktualizacja: 20 sierpnia 2026
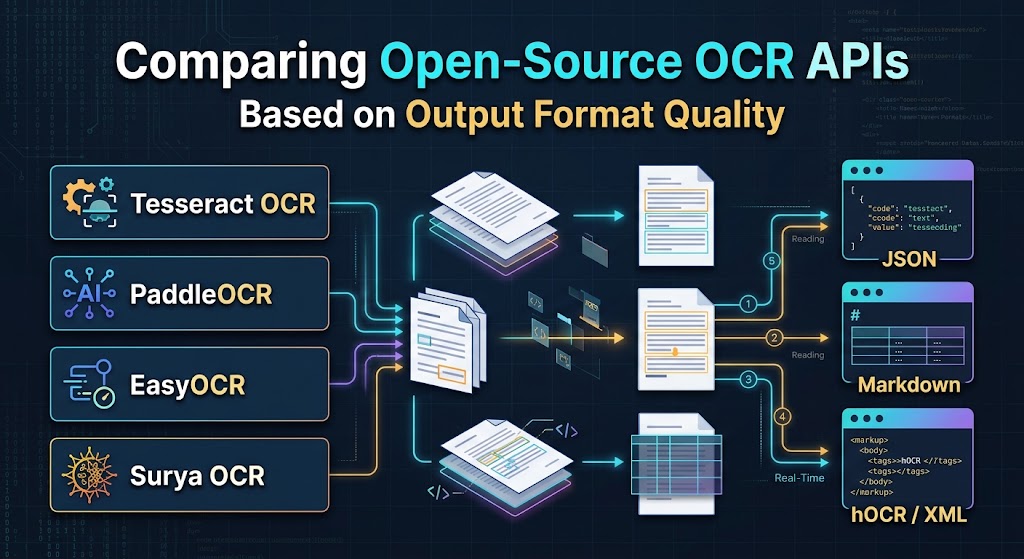
Porównanie otwartych API OCR pod kątem jakości formatu wyjściowego
Kiedy inżynierowie oceniają silniki rozpoznawania znaków optycznych (OCR), wskaźniki błędu znaków (CER) i błędu słów (WER) zazwyczaj dominują w benchmarkach. Choć dokładność rozpoznawania jest istotna, rozwiązuje ona tylko połowę problemu w produkcji.
Jeśli parsujesz złożone, wielokolumnowe pliki PDF, wyodrębniasz pozycje z paragonów lub wprowadzisz białe księgi do potoku osadzania LLM, surowe zrzuty tekstu generują ogromne obciążenie inżynieryjne. Ciąg znaków bez świadomości układu, logicznej kolejności czy danych współrzędnych zmusza zespół do pisania kruchego parsera heurystycznego.
Prawdziwym wyróżnikiem nowoczesnych przepływów dokumentów jest jakość formatu wyjściowego: jak konsekwentnie i czysto silnik dostarcza współrzędne, kolejność czytania, hierarchię strukturalną oraz dane tabelaryczne.
Poniżej znajduje się porównanie skoncentrowane na inżynierii czterech wiodących silników OCR open source — Tesseract, PaddleOCR, EasyOCR i Surya OCR — oceniające, jak ich wyniki zachowują się w zautomatyzowanych potokach.
Popularne formaty wyjściowe: Czego naprawdę potrzebują inżynierowie
Każde API OCR pakietuje wykryty tekst inaczej. Zrozumienie tych formatów pomaga określić, ile post‑procesingu wymaga Twój pipeline:
- Plain Text (
.txt): Najprostsza reprezentacja. Usuwa wszystkie metadane pozycyjne i scala układy wielokolumnowe w odczyty poziome, co może pomieszać akapity. - Archival Standards (
hOCR,ALTO XML): Formaty oparte na XML/HTML, standardowe w archiwizacji bibliotecznej. Osadzają współrzędne, szacunki czcionek i oceny pewności w węzłach DOM. Niezwykle solidne dla rekonstrukcji dokumentów, ale ciężkie dla mikroserwisów. - Structured JSON: Domyślny wybór dla nowoczesnych backendów webowych. Dostarcza tablice współrzędnych (ramki ograniczające lub wielokąty), oceny pewności oraz hierarchiczne struktury bloków/wierszy/słów.
- Markdown (
.md) / HTML Tables: Nowoczesny standard dla Retrieval‑Augmented Generation (RAG). Zachowuje sekcje semantyczne (nagłówki, listy, pogrubiony tekst) oraz macierze tabelaryczne bez konieczności późniejszej rekonstrukcji przestrzennej.
1. Tesseract OCR
Utrzymywany przez Google, Tesseract pozostaje podstawowym koniem roboczym otwarto‑źródłowego OCR. Jego architektura mocno opiera się na tradycyjnych algorytmach segmentacji stron, uzupełnionych o silnik znakowy oparty na LSTM.
Natywne formaty wyjściowe
- Podstawowe wyniki: Tekst zwykły, hOCR (HTML), ALTO XML, TSV (wartości oddzielone tabulatorem) i przeszukiwalny PDF/A.
- Świadomość układu: Heurystyki oparte na regułach poprzez tryby segmentacji stron (PSM).
Analiza formatu wyjściowego
- Gdzie się wyróżnia: Eksporty
TSVihOCRTesseracta są standaryzowane i przewidywalne. Pojedynczy eksport TSV zwraca strukturalne kolumny dlalevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heighticonf. Jeśli konwertujesz archiwa papierowe na przeszukiwalne PDF-y lub potrzebujesz ścisłego przestrzegania standardów instytucjonalnych, Tesseract obsługuje to natywnie bez własnego kodu łączącego. - Gdzie ma braki: Tesseract nie posiada natywnego API JSON. Konsumpcja jego wyjścia w Pythonie lub Node.js wymaga parsowania plików XML/TSV lub użycia wrapperów takich jak
pytesseract. Jego silnik układu również ma trudności z niestandardowym przepływem kolumn, często mieszając tekst z sąsiednich kolumn, chyba że dostarczone zostaną ręczne przycięcia ograniczające.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Wspierany przez framework PaddlePaddle firmy Baidu, PaddleOCR zyskał szerokie zastosowanie dzięki swoim lekkim modelom, rozległemu wsparciu wielu języków oraz dedykowanemu zestawowi narzędzi do analizy dokumentów (PP-Structure).
Natywne formaty wyjściowe
- Główne wyniki: Python lists/dictionaries, raw JSON, visualization overlays, and structured HTML via PP-Structure.
- Świadomość układu: Wysoka (z użyciem modeli deep learning do parsowania układu, klasyfikacji orientacji i odzyskiwania tabel).
Analiza formatu wyjściowego
- Gdzie się wyróżnia: Standardowy PaddleOCR zwraca współrzędne wielokąta 4‑punktowego (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) wraz z ciągami tekstowymi i wynikami pewności. To radzi sobie z pochyłym lub zakrzywionym tekstem. Jednak prawdziwą siłą jest zestaw PP-Structure, który wykrywa regiony układu (tytuł, tekst, tabela, rysunek) i parsuje tabele bezpośrednio do prawidłowych ciągów HTML (<table>...</table>). To eliminuje konieczność ręcznego obliczania rozpiętości komórek z ramki ograniczającej. - Gdzie ma ograniczenia: Podstawowe API zwraca zagnieżdżone tablice, które nie mają standardowych kluczy właściwości w różnych wersjach. Dla aplikacji strukturalnych programiści zazwyczaj piszą pośredni adapter, aby ustandaryzować nazwy pól (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Zbudowany na PyTorch przez JaidedAI, EasyOCR jest przeznaczony do szybkiego przyjęcia przez programistów. Pakietuje CRAFT (Character Region Awareness for Text Detection) wraz z sieciami rozpoznawania opartymi na deep learning w minimalne API.
Natywne formaty wyjściowe
- Główne wyniki: listy Pythona zawierające krotki współrzędnych, rozpoznane ciągi znaków oraz wartości pewności.
- Świadomość układu: Niska do umiarkowanej (wykrywanie jedynie linii tekstu; brak parsowania struktury na poziomie dokumentu).
Analiza formatu wyjściowego
- Gdzie się wyróżnia: Prostota zwracanego obiektu jest nieporównywalna:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Mapowanie tego wyniku do standardowej odpowiedzi REST lub serializacja bezpośrednio do GeoJSON/niestandardowych schematów wymaga zaledwie kilku linii kodu. Działa niezawodnie na tekście w naturalnych scenach, tablicach rejestracyjnych oraz wyodrębnionych fragmentach dokumentów.
- Gdzie ma braki: EasyOCR nie wykonuje holistycznej analizy układu dokumentu. Nie rozpoznaje tabel, hierarchii nagłówków ani kolejności czytania w złożonych kolumnach. Stosowanie EasyOCR na dwukolumnowym artykule naukowym często generuje splątane fragmenty tekstu, chyba że jest połączone z modelem wykrywania układu (takim jak YOLO lub LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya jest nowoczesnym frameworkiem OCR opartym na głębokim uczeniu, zaprojektowanym specjalnie do zrozumienia złożonych dokumentów oraz pipeline’ów wprowadzania LLM.
Natywne formaty wyjściowe
- Główne wyniki: Struktury JSON modelowane przy użyciu Pydantic, indeksy logicznego porządku czytania, regiony ograniczające układ oraz wielokąty wykrywania linii.
- Świadomość układu: Niezwykle wysoka (analiza układu oparta na głębokim uczeniu i sortowanie kolejności czytania).
Analiza formatu wyjściowego
- Gdzie się wyróżnia: Surya bezpośrednio rozwiązuje wyzwania współczesnego inżynierii AI. Zamiast zakładać, że dokumenty są czytane od góry do dołu, od lewej do prawej, Surya wykorzystuje dedykowany model do przewidywania kolejności czytania. Grupuje linie w logiczne bloki semantyczne, naturalnie obsługuje rozciąganie na wiele kolumn i generuje typowane struktury za pomocą Pydantic. Dzięki temu dalsze przetwarzanie do baz wektorowych i konwerterów Markdown jest bezpośrednie i niezawodne.
- Gdzie ma braki: Jako nowszy, bardziej zasobożerny framework oparty na PyTorch, Surya wymaga dedykowanego GPU, aby dorównać wydajności zoptymalizowanych silników C++ takich jak Tesseract czy kwantyzowanych modeli Paddle. Nie jest przeznaczony dla starszych standardów archiwizacji, takich jak hOCR lub ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Macierz porównawcza (twarz w twarz)
| Możliwość / Format | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Natywny hOCR / ALTO XML | Natywne wsparcie | Tylko zewnętrzne | Brak | Brak |
| Geometria ramki ograniczającej | Wyrównane do osi (x, y, w, h) | Wielokąt 4‑punktowy | Wielokąt 4‑punktowy | Wielokąt + bloki układu |
| Parsowanie tabeli | Tylko współrzędne TSV | Ciągi tabel HTML | Brak | Siatki współrzędnych komórek |
| Wykrywanie kolejności czytania | Oparte na regułach (przerywa przy wielokolumnowości) | Analiza układu ML | Podstawowe grupowanie linii | Dedykowany model kolejności odczytu |
| Bezpośrednie schematy JSON | Wymaga konwersji | Python Dict / JSON | Python List / JSON | Typowane modele Pydantic |
| Idealny cel downstream | Archiwalne PDF-y, starsze systemy DMS | Dane formularzy/paragonów, systemy ERP | Szybkie skrypty, tekst sceniczny | Ingestia LLM, architektury RAG |
Zalecenia dotyczące potoku: który wybrać?
- Wybierz Tesseract jeśli Twoje wymagania zgodności wymagają standardowych
hOCR,ALTO XMLlub przeszukiwalnych dostaw PDF/A dla dokumentów rządowych lub archiwalnych. - Wybierz PaddleOCR jeśli przetwarzasz operacyjne dokumenty finansowe (faktury, paragony, formularze podatkowe) zawierające złożone, bezramkowe tabele, które muszą zostać przekonwertowane do HTML lub arkuszy kalkulacyjnych.
- Wybierz EasyOCR jeśli potrzebujesz lekkiej, pytoniowej biblioteki do wykrywania i wyodrębniania tekstu z naturalnych obrazów, znaków drogowych lub przyciętych elementów interfejsu użytkownika bez problemów konfiguracyjnych.
- Wybierz Surya OCR jeśli wprowadzisz nieustrukturyzowane raporty biznesowe, prace naukowe i przewodniki techniczne do LLM lub silnika wyszukiwania wektorowego, gdzie logiczna kolejność czytania i czyste granice strukturalne są kluczowe.
Najczęściej zadawane pytania (FAQ)
1. Który otwartoźródłowy format wyjściowy OCR jest najłatwiejszy do wprowadzenia do dużych modeli językowych?
JSON świadomy kolejności czytania Surya OCR oraz tabele HTML PP-Structure PaddleOCR zapewniają najczystsze reprezentacje dla kontekstów podpowiedzi LLM i indeksowania RAG.
2. Czy Tesseract może natywnie generować odpowiedzi w formacie JSON bez użycia narzędzi zewnętrznych?
Nie, Tesseract natywnie generuje tekst, TSV, PDF oraz hOCR/ALTO XML; aby uzyskać JSON, należy przekonwertować jego wyjście TSV lub hOCR przy użyciu pośredniego parsera.
3. Czym różnią się współrzędne wielokąta 4‑punktowego od prostokątnych ram ograniczających (axis-aligned bounding boxes)?
Prostokąty wyrównane do osi używają [x, y, width, height] zakładając płaski tekst, podczas gdy wielokąty czteropunktowe dostarczają cztery pary współrzędnych, aby dokładnie otoczyć obrócone, skośne lub zakrzywione linie tekstu.
4. Który silnik generuje struktury tabel bezpośrednio w kodzie, a nie luźne współrzędne?
Moduł PP-Structure w PaddleOCR odtwarza wykryte granice tabeli w pełne znaczniki HTML tabeli (<table>, <tr>, <td>), unikając własnych obliczeń przestrzennych.
5. Dlaczego standardowe wyjście EasyOCR ma problemy z wielokolumnowymi artykułami naukowymi?
EasyOCR identyfikuje linie tekstu na podstawie lokalnej bliskości, a nie globalnej hierarchii układu, co powoduje splatanie się tekstu z sąsiednich kolumn, chyba że zostanie ograniczony przez zewnętrzny silnik układu.