Ostatnia aktualizacja: 20 sierpnia 2026
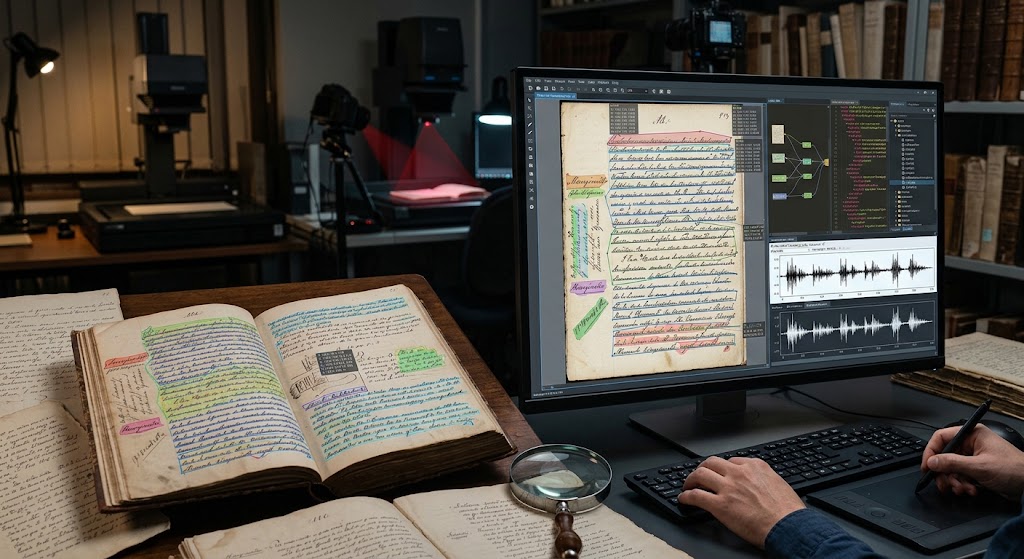
Formaty plików OCR dla dokumentów historycznych i odręcznych
Zachowanie dziedzictwa kulturowego poprzez digitalizację wkroczyło w renesans. Podczas gdy wczesne systemy rozpoznawania znaków optycznych (OCR) były projektowane do przetwarzania nieskazitelnych, maszynowo drukowanych dokumentów z XX wieku, współczesne instytucje dziedzictwa kulturowego stoją przed znacznie bardziej złożonym i bogatym wyzwaniem: średniowiecznymi rękopisami, XIX‑wieczną korespondencją pisma odręcznego, kruchemi iluminowanymi foliosami oraz stulecznymi rejestrami.
Transkrypcja dokumentów historycznych nie polega już tylko na wyodrębnianiu zwykłego tekstu ASCII. Wymaga uchwycenia kontekstu—fizycznej geometrii strony, krzywych linii bazowych, korekt przenikania atramentu, marginaliów, skrótów oraz niepewności paleograficznej. Ta specjalistyczna dziedzina, często klasyfikowana jako Rozpoznawanie Ręcznego Tekstu (HTR), zależy w dużym stopniu od formatu pliku używanego do przechowywania i wymiany zarówno współrzędnych obrazu, jak i warstw tekstowych.
Wybranie niewłaściwego schematu może usunąć istotne dane linii bazowych, zakłócić dopasowanie do manifestów IIIF (International Image Interoperability Framework) lub uniemożliwić długoterminowe zachowanie cyfrowe. Oto ostateczny przewodnik po wiodących formatach plików OCR i HTR dla dokumentów historycznych, ich mocnych stronach strukturalnych oraz o tym, jak określić właściwy wybór dla Twojego potoku archiwizacyjnego.
Dylemat historyczny: dlaczego Zwykły tekst i standardowe PDF-y zawodzą
OCR maszynowo drukowane często generuje proste pliki .txt lub “sandwich” PDF‑y z ukrytymi warstwami tekstu pod skanem. Dla historycznych rękopisów i pisma kursywą, te wyniki zawodzą z trzech podstawowych powodów:
- Tekst nieliniowy i złożone układy: Historyczni skrybowie nie trzymali się schludnych prostokątnych siatek. Tekst spływa w marginesy, owija się wokół iluminowanych inicjałów, przeplata się między wstawionymi korektami interliniowymi lub biegnie pionowo wzdłuż grzbietu.
- Zakrzywione i pochyłe linie bazowe: Pismo odręczne rzadko podąża za sztywną poziomą osią. Silniki HTR takie jak Transkribus, Kraken i eScriptorium opierają się na wielokątnych liniach bazowych zamiast prostokątnych ram, aby interpretować skrypty bogate w ligatury.
- Złożoność paleograficzna i metadane: Badania archiwalne wymagają śledzenia skrótów, historycznych wariantów ortograficznych, uszkodzonych odczytów oraz ocen pewności na poziomie linii. Standardowe formaty dokumentów pomijają tę szczegółowość.
Aby zachować wierność oryginalnemu artefaktowi, społeczność archiwalna opiera się na ustrukturyzowanych schematach XML zaprojektowanych do zachowania topologii układu wraz z przepisanym tekstem.
1. PAGE XML: Złoty standard rozpoznawania tekstu odręcznego (HTR)
Opracowany przez laboratorium badawcze PRImA (Pattern Recognition & Image Analysis), PAGE XML (Page Analysis and Groundtruth Elements) jest powszechnie uważany za najnowocześniejszy format do rozpoznawania tekstu odręcznego i zaawansowanej analizy układu.
Podstawowa architektura
PAGE XML traktuje fizyczny dokument jako strukturę hierarchiczną:
PcGts(Korzeń)Page(Wymiary obrazu i ogólna kolejność czytania)TextRegion(Akapity, nagłówki, notatki marginalne, słowa kluczowe)TextLineCoords(Współrzędne wielokąta wokół linii)Baseline(Seria punktów podążająca za rzeczywistą linią bazową pisma)TextEquiv(Rozpoznany tekst, z opcjonalnymi miarami pewności)
Dlaczego wyróżnia się w przypadku rękopisów historycznych
- Precyzja wielokątów i polilinii: Zamiast zmuszać znaki do prostokątnych ram, PAGE XML używa wielopunktowych granic wielokątów i ciągłych linii bazowych. Zapobiega to nakładaniu się kursywnych górnych i dolnych części znaków, które mogłyby zakłócać segmentację.
- Szczegółowe typy strukturalne: Regiony mogą być precyzyjnie klasyfikowane (np.
marginalia,drop-capital,signature-mark,header,editorial-note). - Szeroki ekosystem oprogramowania: Służy jako podstawowy wewnętrzny i eksportowy schemat dla flagowych platform HTR, takich jak Transkribus, eScriptorium, i Kraken.
2. ALTO XML: Potęga bibliotek i archiwów
ALTO (Analyzed Layout and Text Object) jest otwartym standardem XML utrzymywanym przez Bibliotekę Kongresu i szeroko przyjętym przez biblioteki narodowe, w tym Bibliothèque nationale de France (BnF) oraz British Library.
Podstawowa architektura
ALTO strukturyzuje układ hierarchicznie od Page do PrintSpace, w dół do TextBlock, TextLine i String (poszczególne słowa lub tokeny). Jest często pakowany wewnątrz opakowania METS (Metadata Encoding and Transmission Standard), aby powiązać metadane strukturalne z obrazami wysokiej rozdzielczości.
Kluczowe mocne strony i przypadki użycia
- Masowe przepływy cyfryzacji: ALTO został zaprojektowany z myślą o cyfryzacji gazet i książek na skalę przemysłową. Czytelnie koduje atrybuty czcionki, współrzędne na poziomie słowa, pewność znaków oraz spacje.
- Wsparcie nowoczesnego HTR (ALTO 4): Wcześniejsze wersje ALTO mocno opierały się na prostokątnych współrzędnych (
HPOS,VPOS,WIDTH,HEIGHT). Jednak od wersji ALTO 4, schemat wprowadził wielokąty<Shape>oraz linie bazowe polilinii, zamykając funkcjonalną lukę w stosunku do PAGE XML dla materiałów odręcznych. - Długoterminowa konserwacja: Ponieważ jest to oficjalny standard wspierany przez międzynarodowe konsorcja bibliotek, ALTO zapewnia długoterminową stabilność oraz kompatybilność wsteczną na poziomie archiwalnym.
3. hOCR: Standard lekki, najpierw internetowy
Stworzony przez Thomasa Breuela, hOCR przyjmuje pragmatyczne podejście: zamiast tworzyć zupełnie nowy schemat XML, osadza metadane układu i transkrypcji bezpośrednio w semantycznym HTML/XHTML przy użyciu mikroformatów i atrybutów klasy.
Przykładowa składnia
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">Incipit</span>
      </span>
    </p>
  </div>
</div>
Zalety i wady materiałów historycznych
- Zalety: Przeglądarki mogą renderować go natywnie. Łatwo go przekształcić przy użyciu czystego CSS i JavaScript, a jest domyślnym formatem strukturalnym eksportu dla silników takich jak Tesseract.
- Wady: Natychmiastowe wsparcie dla złożonych, dowolnych krzywych bazowych z wieloma punktami jest ograniczone. Choć praktyczne dla wczesnych dzieł drukowanych (inkunabuły lub czyste druki), hOCR ma trudności z nieregularnymi układami rękopisów i wielowarstwowymi marginaliami.
4. TEI-XML: Wzorzec akademicki i cyfrowych nauk humanistycznych
Format Text Encoding Initiative (TEI) nie jest ściśle formatem wyjściowym silnika OCR; jest to natomiast wiodący standard dla krytycznych edycji cyfrowych oraz naukowej reprezentacji tekstów literackich i historycznych.
Łączenie OCR/HTR z TEI
Nowoczesne potoki rzadko kończą się na surowym rozpoznawaniu znaków. Uczonymi używanymi narzędziami są m.in. Transkribus TEI Exporter lub zautomatyzowane potoki XSLT, które przekształcają pliki PAGE XML lub ALTO do XML zgodnego z TEI:
- Skróty są rozwijane (
<choice><abbr>...</abbr><expan>...</expan></choice>). - Usunięcia, dodatki i rękopisy są formalnie klasyfikowane (
<add>,<del>,<handShift>). - Dane układu są zachowywane wraz z analizą literacką przy użyciu elementów
<facsimile>i<surface>.
Jeśli Twój projekt historyczny ma na celu stworzenie interaktywnej krytycznej edycji lub semantycznie przeszukiwalnego archiwum naukowego, konwersja danych OCR/HTR do TEI-XML jest często niezbędnym końcowym krokiem.
Macierz porównawcza: formaty OCR/HTR w skrócie
| Cecha / Kryterium | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| Główna domena | Odręczne HTR & rękopisy | Masowa digitalizacja bibliotek | Web OCR & lekka wyszukiwarka | Naukowe wydania krytyczne |
| Podstawowe wsparcie | Natywne, wielopunktowe polilinie | Obsługiwane (od v4.0) | Podstawowe (nachylenie/przesunięcie) | Poprzez mapowanie facsimile |
| Nieregularne wielokąty | Pełny | Pełny | Ograniczone | Poprzez elementy współrzędnych |
| Ekosystem narzędziowy | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, przeglądarki internetowe | Oxygen, TEI Publisher |
| Organizacja Standaryzacyjna | PRImA Group / Open | Biblioteka Kongresu | Specyfikacja społeczności | TEI Consortium |
Praktyczne rekomendacje: wybór Twojego archiwalnego potoku
Aby ustanowić wydajny, przyszłościowy proces cyfryzacji:
- Dla czystych rękopisów i archiwów: Standaryzuj transkrypcję i ekstrakcję układu przy użyciu PAGE XML. Jego obliczanie linii bazowej i konturowanie wielokątów radzą sobie z niestandardowymi pismami ręcznymi przy minimalnej utracie danych.
- Dla dużych bibliotek i mieszanych zbiorów: Wybierz ALTO XML (v4.2 lub wyższą) w połączeniu z METS. To zapewnia płynną integrację ze standardowymi architekturami repozytoriów cyfrowych oraz systemami zarządzania zasobami cyfrowymi (DAMS).
- Do prezentacji internetowej i indeksów pełnotekstowych: Użyj hOCR lub wyprowadź lekkie struktury GeoJSON/Web Annotation z PAGE XML, aby zasilić interaktywne przeglądarki IIIF (takie jak Mirador lub Universal Viewer) z dynamicznymi nakładkami tekstowymi w przeglądarce.
- Dla edycji naukowych i badań paleograficznych: Wygeneruj swoje dane referencyjne w formacie PAGE XML, przeprowadź rozpoznawanie i przekaż wynik przez automatyczny konwerter, aby wygenerować TEI-XML do oznaczania edytorskiego.
Dopasowując możliwości strukturalne tych formatów do wymagań paleograficznych twojego materiału źródłowego, zapewniasz, że każde pociągnięcie, skrót i historyczna niuans pozostaną odczytywalne przez kolejne wieki.
Najczęściej zadawane pytania (FAQ)
Q1. Jaka jest podstawowa różnica między standardowym OCR a HTR? OCR rozpoznaje jednolitą, maszynowo drukowaną typografię, podczas gdy HTR (Handwritten Text Recognition) wykorzystuje głębokie sieci neuronowe do dekodowania ciągłego, zmiennego ludzkiego pisma ręcznego i zakrzywionych linii bazowych.
Q2. Czy Tesseract OCR może generować PAGE XML lub ALTO jako wynik dla dokumentów historycznych? Tak, Tesseract może generować natywny ALTO XML i wyjście hOCR, a zewnętrzne wrappery mogą konwertować te wyniki do PAGE XML.
Q3. Dlaczego linie bazowe są ważniejsze niż ramki ograniczające w transkrypcji ręcznego tekstu? Linie bazowe śledzą naturalną, falującą linię ludzkiego pisma, umożliwiając oprogramowaniu oddzielenie nakładających się górnych i dolnych części liter, które kolidują wewnątrz sztywnych ramek ograniczających.
Q4. Jak standard IIIF współdziała z tymi formatami plików OCR? IIIF udostępnia obrazy wysokiej rozdzielczości poprzez otwarte API internetowe, podczas gdy formaty takie jak ALTO lub PAGE XML dostarczają dane współrzędnych, które można przekształcić w adnotacje IIIF Content Search.
Q5. Który format pliku jest najłatwiejszy do bezpośredniej konwersji na przeszukiwalny PDF? Zarówno hOCR, jak i ALTO XML mogą być połączone z oryginalnymi obrazami stron, aby stworzyć przeszukiwalne pliki PDF z podwójną warstwą przy użyciu narzędzi takich jak OCRmyPDF.