Ostatnia aktualizacja: 30 wrz, 2026
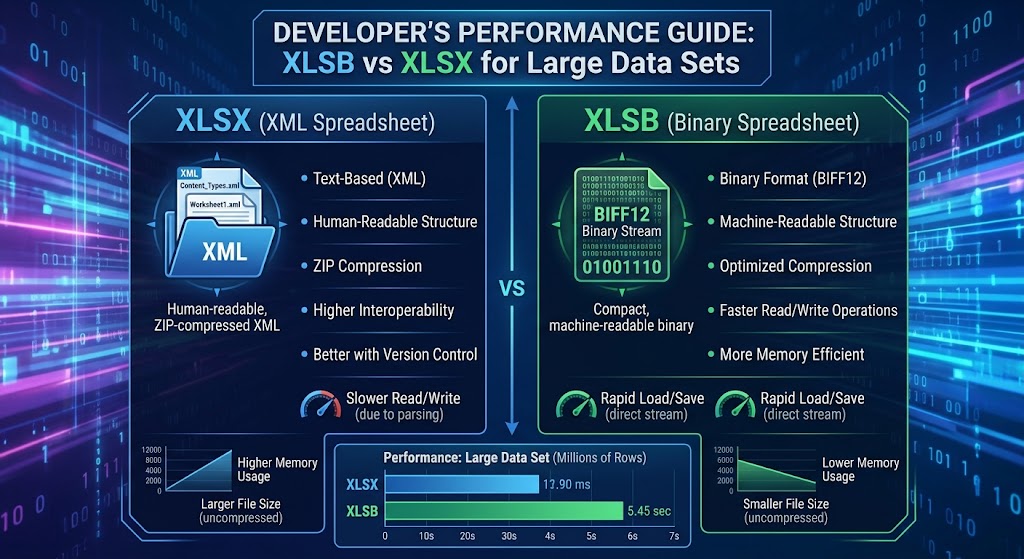
XLSB vs XLSX dla dużych zestawów danych: Przewodnik wydajnościowy dla programistów
Jeśli budujesz potoki danych, silniki raportowania backendowego lub narzędzia analityczne, które współpracują z Microsoft Excel, prawdopodobnie natrafiłeś na “ścianę”.
Użytkownik przesyła skoroszyt z 450 000 wierszami. Twój serwer uruchamia wątki robocze, zużycie pamięci rośnie do gigabajtów, zbieranie śmieci zamraża środowisko uruchomieniowe, a Twoje wykonanie przekracza limit czasu. Sprawdzasz ładunek: to standardowy plik .xlsx.
Aby to rozwiązać, programiści często spędzają dni na implementacji podziału na fragmenty, parserów strumieniowych lub przenoszeniu plików do pracowników w tle. Jednak jedna z najskuteczniejszych optymalizacji nie wymaga żadnej przebudowy architektury: zmiana rozszerzenia pliku z .xlsx na .xlsb.
W tym przewodniku zagłębiamy się w szczegóły obu formatów, analizujemy, dlaczego ich wewnętrzne architektury dają radykalnie różne charakterystyki wydajności, porównujemy konkretne benchmarki w Pythonie i .NET oraz przedstawiamy jasne zasady, kiedy wdrażać binarne skoroszyty w środowisku produkcyjnym.
1. Pod maską: OpenXML vs. BIFF12
Aby zrozumieć, dlaczego wydajność tak dramatycznie różni się przy dużych zestawach danych, musimy przyjrzeć się, jak każdy format przechowuje rekordy na dysku.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Zarówno pliki .xlsx, jak i .xlsb są skompresowanymi kontenerami ZIP zgodnymi z Open Packaging Conventions (OPC). Jeśli zmienisz nazwę któregoś z plików na .zip i rozpakujesz go, zobaczysz znany układ katalogów: _rels, docProps i xl/worksheets/.
Kluczowa różnica znajduje się wewnątrz folderu xl/worksheets/:
- XLSX przechowuje arkusze jako zwykły tekst XML (
sheet1.xml). - XLSB przechowuje arkusze jako własnościowe strumienie binarne (
sheet1.bin), kodowane przy użyciu BIFF12 firmy Microsoft (Binary Interchange File Format 12).
Jak XLSX koduje dane (narzut XML DOM)
W arkuszu XLSX każda komórka jest zadeklarowana przy użyciu explicite znaczników XML:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Podczas odczytywania tego wiersza, Twój runtime musi:
- Rozpakować surowy strumień deflate do tekstu.
- Tokenizować i parsować znaki ciągu do drzewa XML DOM lub strumienia zdarzeń SAX.
- Zweryfikuj otwierające i zamykające tagi (
<c>,</c>,<v>,</v>). - Rozwiąż odwołania do ciągów znaków z osobnej tabeli
sharedStrings.xml. - Przetwórz tekst ASCII
"98234.55"na 64‑bitową liczbę zmiennoprzecinkową IEEE 754.
Każda pojedyncza komórka generuje narzut CPU związany z parsowaniem ciągów, alokacją ciągów i analizą leksykalną. Pomnóż to przez 500 000 wierszy i 30 kolumn (15 milionów komórek), a procesor spędza znacznie więcej cykli na parsowanie składni niż na przetwarzanie wartości domenowych.
Jak XLSB koduje dane (strumień binarny BIFF12)
BIFF12 całkowicie pomija serializację tekstu. Zamiast oznaczeń ciągów, dane są układane jako kolejna sekwencja binarnych rekordów o zmiennej długości:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Komórka zmiennoprzecinkowa w BIFF12 nie używa reprezentacji tekstowych, takich jak "98234.55". Jest reprezentowana bezpośrednio:
- 2 bajty na identyfikator rekordu (np.
BrtCellRklubBrtCellReal) - 4 bajty na indeksy kolumny/wiersza
- 8 bajtów zawierających surową strukturę bajtów podwójnej precyzji IEEE 754
Gdy twój parser odczytuje plik XLSB, całkowicie pomija analizę leksykalną. Odczytuje nagłówek rekordu, pobiera 8 surowych bajtów z bufora, kopiuje je bezpośrednio do pamięci i przesuwa wskaźnik do przodu. Nie ma tagów do walidacji, nie zachodzi konwersja typu z łańcucha na liczbę i nie ma żadnego narzutu dekodowania UTF-8 dla danych liczbowych.
2. Ilościowe benchmarki: dysk, pamięć i przepustowość
Aby zilustrować rzeczywisty wpływ, rozważ symulowany zestaw danych zawierający 750,000 rows and 25 columns (mieszankę znaczników czasu, liczb zmiennoprzecinkowych, liczb całkowitych i kodów kategorii).
Poniższe testy oceniają identyczne dane tabelaryczne zapisane zarówno jako XLSX, jak i XLSB.
Środowisko testowe
- CPU: AMD Ryzen 9 5900X (12 rdzeni, 24 wątki)
- RAM: 64 GB DDR4-3600
- Pamięć: PCIe 4.0 NVMe SSD
- Czas wykonania: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Kluczowe metryki wydajności
| Metryka | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Ulepszenie |
|---|---|---|---|
| Rozmiar pliku na dysku | 128.4 MB | 68.2 MB | ~47% mniejsze |
| Czas zapisu / serializacji | 42.6 s | 14.1 s | 3.0x szybciej |
| Czas odczytu (parser DOM w Pythonie) | 38.2 s | 8.9 s | 4.3x szybciej |
| Czas odczytu (silnik Rust/C) | 6.4 s | 1.9 s | 3.3x szybciej |
| Maksymalna alokacja sterty podczas odczytu | ~1.85 GB | ~510 MB | ~72% redukcji |
Dlaczego pliki XLSB są mniejsze
Podczas gdy oba formaty używają standardowej kompresji ZIP, strumienie binarne kompresują znacznie wydajniej niż rozbudowany tekst XML:
- Redundantna składnia jest usuwana: XML zawiera powtarzalne znaczniki (
<c r=\"AA1\" s=\"1\">) w każdym rekordzie. Choć kompresja ZIP łagodzi powtarzające się ciągi, nieskompresowany strumień danych jest ogromny. - Gęstość numeryczna: W XML liczba
12345678.9012wymaga 14 bajtów tekstu ASCII. W BIFF12 jest przechowywana jako podwójna precyzja 8‑bajtowa (lub spakowana do 4‑bajtowego rekorduRK, jeśli spełnia określone reguły precyzji).
3. Ślad pamięci i obciążenie zbierania śmieci
Dla usług internetowych i mikrousług obsługujących jednoczesne żądania, prędkość CPU to tylko połowa walki; zużycie pamięci to miejsce, w którym aplikacje naprawdę zawodzą.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Gdy parser XML przetwarza plik XLSX o wielkości 100 MB, musi utworzyć tysiące efemerycznych tokenów znakowych, buforów fragmentów łańcuchów i wyszukiwań w słowniku. W językach z automatycznym zarządzaniem pamięcią (Java, C#, Go, Node.js, Python) powoduje to ekstremalną fragmentację sterty i wprowadza środowisko wykonawcze w częste przerwy związane z Garbage Collection (GC).
Ponieważ parsowanie XLSB działa bezpośrednio na wycinkach bajtów o stałej szerokości, parsery mogą odczytywać dane do struktur alokowanych na stosie lub wielokrotnego użytku buforów bajtowych. Rezultatem jest dramatycznie zmniejszony ślad pamięciowy i zerowe obciążenie alokatora w czasie działania.
4. Przykłady implementacji programisty
Spójrzmy, jak wykorzystać XLSB w typowych łańcuchach narzędzi deweloperskich.
Python: migracja z OpenPyXL do Calamine / PyXLSB
Standardowe pandas.read_excel('data.xlsx') domyślnie używa openpyxl, który buduje ciężkie drzewo w pamięci.
Aby przetwarzać duże pliki XLSB z maksymalną prędkością, użyj silnika calamine napędzanego przez Rust (dostępnego poprzez python-calamine i zintegrowanego z nowoczesnym Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Jeśli iterujesz po ogromnych zestawach danych wiersz po wierszu, nie ładując całej macierzy do DataFrame, pyxlsb zapewnia lekki iterator strumieniowy:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Wysokowydajne przetwarzanie strumieniowe
W .NET biblioteki takie jak ClosedXML czy EPPlus są świetne do standardowego generowania, ale do wczytywania dużych plików bez wyczerpania pamięci, ExcelDataReader z obsługą XLSB jest wyjątkowo szybki:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Kompromisy architektoniczne: Kiedy NIE używać XLSB
Mimo przytłaczających korzyści wydajnościowych, XLSB nie jest rozwiązaniem uniwersalnym. Powinieneś rozważyć kilka operacyjnych kompromisów przed wprowadzeniem go w całym stosie:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosystem i wsparcie bibliotek
- XLSX: Uniwersalny. Praktycznie każdy język, biblioteka, narzędzie SaaS (Google Sheets, Airtable, Tableau) oraz parser internetowy natywnie obsługuje OpenXML.
- XLSB: Mniej powszechny. Choć Excel, LibreOffice i dojrzałe biblioteki deweloperskie (
ExcelDataReader,pyxlsb,calamine,Aspose) go obsługują, wiele lekkich pakietów lub czysto internetowych parserów JavaScript (np. starsze wersjeSheetJS) ma ograniczone lub tylko do odczytu wsparcie.
2. Git i różnicowanie w kontroli wersji
- XLSX: Ponieważ zawiera tekstowy XML wewnątrz kontenera ZIP, narzędzia wiersza poleceń i hooki Git mogą rozpakować i sformatować XML, aby generować czytelne różnice strukturalne między commitami.
- XLSB: Czyste dane binarne. Systemy kontroli wersji traktują go ściśle jako nieprzezroczysty binarny blob, eliminując wszelką możliwość szczegółowego porównywania różnic lub scalania na poziomie linii.
3. Renderowanie po stronie klienta
Jeśli Twoja architektura opiera się na renderowaniu arkuszy kalkulacyjnych bezpośrednio w przeglądarce za pomocą WebAssembly lub JavaScript po stronie klienta, parsery XLSX są znacznie bardziej dojrzałe i mniej podatne na błędy renderowania w skrajnych przypadkach niż parsery binarne po stronie klienta.
4. Zewnętrzne potoki ingestji
Jeśli eksportujesz pliki dla zewnętrznych klientów korporacyjnych, wiele rygorystycznych polityk bezpieczeństwa firm flaguje pliki .xlsb. Ponieważ pliki BIFF12 mogą przechowywać makra VBA identycznie jak pliki .xlsm (bez konieczności osobnego rozszerzenia), niektóre filtry poczty i skanery zaporowe kwarantannują przesyłane pliki .xlsb jako potencjalne zagrożenia zawierające makra.
6. Podsumowanie porównania: Który format wygrywa?
| Funkcja | XLSX | XLSB | Zwycięzca |
|---|---|---|---|
| Szybkość odczytu / parsowania | Umiarkowana do słabej | Błyskawicznie szybka | XLSB |
| Szybkość zapisu / generowania | Wymagający dużego zużycia CPU | Szybki | XLSB |
| Kompresja plików | Dobre | Świetny (~40-50% mniejszy) | XLSB |
| Alokacja pamięci | Wysoki (Silny nacisk na GC) | Niski (Bezpośrednie odczytywanie bajtów) | XLSB |
| Interoperacyjność narzędzi | Uniwersalny | Wysoki, ale selektywny | XLSX |
| Opór przy skanowaniu bezpieczeństwa | Minimalny | Okazjonalne fałszywe alarmy | XLSX |
| Możliwość makr | Nie (.xlsm wymagany) | Tak (Obsługuje makra natywnie) | Remis |
7. Orzeczenie programisty
Użyj XLSX, gdy:
- Pliki są małe‑do‑średniego rozmiaru (< 50,000 wierszy).
- Twoje pliki muszą być przetwarzane przez platformy SaaS firm trzecich lub aplikacje konsumenckie (np. Google Sheets).
- Nie możesz kontrolować środowiska końcowego klienta odczytującego plik.
Przejdź na XLSB, gdy:
- Budujesz wewnętrzne potoki, zadania wsadowe, systemy ETL lub zadania pracowników obsługujące masywne ekstrakcje danych (> 100,000 wierszy).
- Twoje serwery napotykają błędy braku pamięci (OOM) podczas serializacji lub deserializacji arkusza kalkulacyjnego.
- Musisz zminimalizować zużycie pamięci w S3/blob oraz czas transferu sieciowego dla dużych, powtarzających się modeli finansowych lub eksportów danych.
Przejście na XLSB jest często tak proste, jak zmiana ciągu konfiguracyjnego w usłudze eksportu, a jednocześnie zapewnia przyrost przepustowości od 3x do 5x, który zwykle wymaga tygodni optymalizacji kodu.
Najczęściej zadawane pytania (FAQ)
**Q1: Czy plik XLSB obsługuje dokładnie takie same limity wierszy i kolumn jak plik XLSX? Tak; zarówno XLSB, jak i XLSX mają dokładnie ten sam limit siatki: 1 048 576 wierszy i 16 384 kolumn na arkusz.
**Q2: Czy plik XLSB może bezpiecznie przechowywać makra VBA bez zmiany rozszerzenia pliku?
Tak, w przeciwieństwie do XLSX (który wymaga zapisu jako XLSM, aby uruchomić kod), XLSB natywnie obsługuje binarne przechowywanie makr VBA w tym samym formacie pliku .xlsb.
**Q3: Dlaczego zapisanie pliku jako XLSB zmniejsza jego rozmiar, jeśli oba formaty są już skompresowane przy użyciu ZIP? XLSB eliminuje rozbudowane znaczniki tekstowe i koduje pozycje komórek, rekordy oraz surowe wartości liczbowe w zwarte strumienie bajtów binarnych, które kompresują się znacznie gęściej niż zwykłe ciągi XML.
**Q4: Czy Google Sheets może importować i edytować pliki XLSB bezpośrednio?
Nie; Google Sheets nie może natywnie otwierać ani konwertować plików .xlsb bezpośrednio, wymaga konwersji ich do .xlsx lub CSV przed importem.
**Q5: Czy pliki XLSB są bardziej podatne na uszkodzenia danych niż pliki XLSX? Podczas gdy pliki XML można czasami ręcznie przeglądać lub naprawiać w edytorze tekstu, gdy są częściowo uszkodzone, binarne strumienie BIFF12 wymagają ścisłych offsetów bajtowych i są trudne do ręcznego odzyskania, jeśli uszkodzone są sektory strukturalne.