Última atualização: 30 Set, 2026
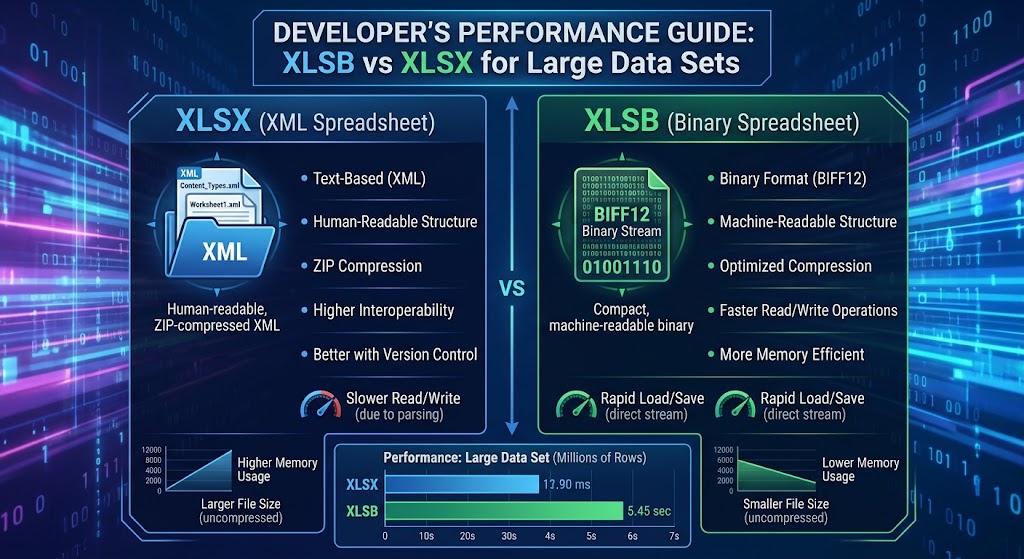
XLSB vs XLSX para Conjuntos de Dados Grandes: Um Guia de Desempenho para Desenvolvedores
Se você cria pipelines de dados, motores de relatórios backend ou ferramentas de análise que se integram ao Microsoft Excel, provavelmente já bateu “a parede”.
Um usuário envia uma planilha com 450.000 linhas. Seu servidor cria threads de trabalho, o consumo de memória dispara para gigabytes, a coleta de lixo congela o tempo de execução e sua execução expira. Você inspeciona o payload: é um arquivo padrão .xlsx.
Para resolver isso, os desenvolvedores costumam passar dias implementando fragmentação, analisadores de streaming ou descarregando arquivos para workers em segundo plano. No entanto, uma das otimizações mais eficazes não requer nenhuma reformulação arquitetural: mudar a extensão do arquivo de .xlsx para .xlsb.
Neste guia, mergulhamos nos bastidores de ambos os formatos, examinamos por que suas arquiteturas internas produzem características de desempenho radicalmente diferentes, comparamos benchmarks concretos em Python e .NET e delineamos regras claras para quando implantar planilhas binárias em produção.
1. Por Dentro: OpenXML vs. BIFF12
Para entender por que o desempenho diverge tão drasticamente em grandes conjuntos de dados, precisamos observar como cada formato armazena registros no disco.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Tanto os arquivos .xlsx quanto os .xlsb são contêineres ZIP compactados que seguem as Open Packaging Conventions (OPC). Se você renomear qualquer um dos arquivos para .zip e extraí‑lo, verá uma estrutura de diretórios familiar: _rels, docProps e xl/worksheets/.
A diferença crucial está dentro da pasta xl/worksheets/:
- XLSX armazena planilhas como texto XML simples (
sheet1.xml). - XLSB armazena planilhas como fluxos binários proprietários (
sheet1.bin), codificados usando o BIFF12 da Microsoft (Binary Interchange File Format 12).
Como o XLSX codifica dados (sobrecarga do DOM XML)
Em uma planilha XLSX, cada célula é declarada com tags XML explícitas:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Ao ler esta linha, seu runtime deve:
- Descompactar o fluxo bruto deflate em texto.
- Tokenizar e analisar os caracteres da string em um DOM XML ou em um fluxo de eventos SAX.
- Validar tags de abertura e fechamento (
<c>,</c>,<v>,</v>). - Resolver buscas de strings a partir de uma tabela
sharedStrings.xmlseparada. - Analisar o texto ASCII
"98234.55"em um número de ponto flutuante de 64 bits IEEE 754.
Cada célula individual impõe overhead de CPU para análise de strings, alocação de strings e análise léxica. Multiplique isso por 500.000 linhas e 30 colunas (15 milhões de células), e a CPU gasta muito mais ciclos analisando sintaxe do que processando valores de domínio.
Como o XLSB codifica dados (fluxo binário BIFF12)
O BIFF12 descarta a serialização de texto completamente. Em vez de marcação de strings, os dados são organizados como uma sequência sequencial de registros binários de comprimento variável:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Uma célula de ponto flutuante no BIFF12 não usa representações de string como "98234.55". Ela é representada diretamente:
- 2 bytes para o ID do registro (por exemplo,
BrtCellRkouBrtCellReal) - 4 bytes para índices de coluna/linha
- 8 bytes contendo a estrutura bruta de bytes de precisão dupla IEEE 754
Quando seu analisador lê um arquivo XLSB, ele ignora completamente a análise léxica. Ele lê o cabeçalho do registro, captura os 8 bytes brutos do buffer, copia‑os diretamente para a memória e avança o ponteiro. Não há tags para validar, nem conversões de tipo de string para número, e zero sobrecarga de decodificação UTF‑8 para dados numéricos.
2. Métricas quantitativas: Disco, Memória e Taxa de transferência
Para ilustrar o impacto no mundo real, considere um conjunto de dados simulado contendo 750,000 linhas e 25 colunas (uma mistura de timestamps, números de ponto flutuante, inteiros e códigos de categoria).
Os testes abaixo avaliam dados tabulares idênticos salvos como XLSX e XLSB.
Ambiente de teste
- CPU: AMD Ryzen 9 5900X (12 núcleos, 24 threads)
- RAM: 64 GB DDR4-3600
- Armazenamento: PCIe 4.0 NVMe SSD
- Tempo de execução: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Métricas de desempenho principais
| Métrica | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Melhoria |
|---|---|---|---|
| Tamanho do Arquivo no Disco | 128.4 MB | 68.2 MB | ~47% menor |
| Salvar / Tempo de Serialização | 42.6 s | 14.1 s | 3.0x mais rápido |
| Tempo de Leitura (parser DOM Python) | 38.2 s | 8.9 s | 4.3x mais rápido |
| Tempo de Leitura (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x mais rápido |
| Alocação Máxima de Heap durante a Leitura | ~1.85 GB | ~510 MB | ~72% redução |
Por que os arquivos XLSB são menores
Embora ambos os formatos usem compressão ZIP padrão, fluxos binários comprimem muito mais eficientemente que texto XML inchado:
- A sintaxe redundante é eliminada: XML contém tags repetitivas (
<c r="AA1" s="1">) em cada registro. Embora a compressão ZIP mitigue strings repetidas, o fluxo de dados não comprimido é massivo. - Densidade numérica: No XML, o número
12345678.9012requer 14 bytes de texto ASCII. No BIFF12, ele é armazenado como um double de 8 bytes (ou compactado em um registroRKde 4 bytes se atender a regras específicas de precisão).
3. Pegada de memória e pressão de coleta de lixo
Para serviços web e microsserviços que lidam com solicitações concorrentes, a velocidade da CPU é apenas metade da batalha; a pegada de memória é onde as aplicações realmente falham.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Quando um analisador XML processa um arquivo XLSX de 100 MB, ele deve criar milhares de tokens de string efêmeros, buffers de fatias de string e buscas em dicionário. Em linguagens com coleta de lixo (Java, C#, Go, Node.js, Python), isso gera extrema fragmentação do heap e empurra o tempo de execução para pausas frequentes de coleta de lixo (GC).
Como a análise de XLSB opera diretamente em fatias de bytes de largura fixa, os analisadores podem ler dados em estruturas alocadas na pilha ou em buffers de bytes reutilizáveis. O resultado é uma pegada de memória drasticamente reduzida e zero sobrecarga do alocador em tempo de execução.
4. Exemplos de Implementação para Desenvolvedores
Vamos ver como aproveitar o XLSB nas cadeias de ferramentas comuns dos desenvolvedores.
Python: Migrando do OpenPyXL para Calamine / PyXLSB
O padrão pandas.read_excel('data.xlsx') usa openpyxl por padrão, que cria uma árvore pesada em memória.
Para processar arquivos XLSB grandes com velocidade máxima, use o motor calamine alimentado por Rust (disponível via python-calamine e integrado ao Pandas moderno):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Se você estiver iterando sobre conjuntos de dados massivos linha a linha sem carregar toda a matriz em um DataFrame, pyxlsb fornece um iterador de streaming leve:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Ingestão de Fluxo de Alto Desempenho
No .NET, bibliotecas como ClosedXML ou EPPlus são ótimas para geração padrão, mas para ingerir arquivos grandes sem esgotar a memória, ExcelDataReader com suporte a XLSB é excepcionalmente rápido:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Compromissos Arquiteturais: Quando NÃO usar XLSB
Apesar de suas vantagens de desempenho avassaladoras, o XLSB não é uma solução mágica. Você deve ponderar várias compensações operacionais antes de adotá-lo em toda a sua pilha:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Suporte ao Ecossistema e Bibliotecas
- XLSX: Universal. Virtualmente todas as linguagens, bibliotecas, ferramentas SaaS (Google Sheets, Airtable, Tableau) e analisadores web suportam OpenXML nativamente.
- XLSB: Menos onipresente. Embora o Excel, LibreOffice e bibliotecas de desenvolvedores maduras (
ExcelDataReader,pyxlsb,calamine,Aspose) o suportem, muitos pacotes leves ou analisadores JavaScript puramente baseados na web (como versões mais antigas doSheetJS) têm suporte limitado ou somente leitura.
2. Diferenças no Git e Controle de Versão
- XLSX: Porque contém XML de texto dentro de um contêiner ZIP, utilitários de linha de comando e hooks do Git podem descompactar e formatar o XML para gerar diffs estruturais legíveis entre commits.
- XLSB: Dados binários puros. Sistemas de controle de versão tratam‑no estritamente como um blob binário opaco, eliminando qualquer possibilidade de diffs granulares ou mesclagens ao nível de linha.
3. Renderização no Cliente Web
Se sua arquitetura depende de renderizar planilhas diretamente no navegador via WebAssembly ou JavaScript do lado do cliente, os analisadores XLSX são significativamente mais maduros e menos propensos a bugs de renderização em casos extremos do que os analisadores binários do lado do cliente.
4. Pipelines de Ingestão de Terceiros
Se você estiver exportando arquivos para clientes empresariais externos, muitas políticas corporativas de segurança rigorosas sinalizam arquivos .xlsb. Como os arquivos BIFF12 podem armazenar macros VBA de forma idêntica aos arquivos .xlsm (sem exigir uma extensão separada), alguns filtros de e‑mail e scanners de firewall colocam em quarentena os uploads de .xlsb como possíveis ameaças contendo macros.
6. Comparação Resumida: Qual Formato Vence?
| Recurso | XLSX | XLSB | Vencedor |
|---|---|---|---|
| Velocidade de Leitura / Análise | Moderada a Ruim | Extremamente Rápida | XLSB |
| Velocidade de Escrita / Geração | Intensivo em CPU | Rápido | XLSB |
| Compressão de Arquivo | Bom | Excelente (~40-50% menor) | XLSB |
| Alocação de Memória | Alta (Pressão de GC pesada) | Baixa (Leitura direta de bytes) | XLSB |
| Interoperabilidade de Ferramentas | Universal | Alta, mas seletiva | XLSX |
| Atrito na Varredura de Segurança | Mínimo | Falsos positivos ocasionais | XLSX |
| Capacidade de Macro | Não (.xlsm necessário) | Sim (Suporta macros nativamente) | Empate |
7. O Veredicto do Desenvolvedor
Use XLSX quando:
- Os arquivos são de tamanho pequeno a moderado (< 50.000 linhas).
- Seus arquivos devem ser ingeridos por plataformas SaaS de terceiros ou aplicativos de consumo (por exemplo, Google Sheets).
- Você não pode controlar o ambiente do cliente final que lê o arquivo.
Mude para XLSB quando:
- Você está construindo pipelines internos, jobs em lote, sistemas ETL ou tarefas de worker que lidam com extrações massivas de dados (> 100.000 linhas).
- Seus servidores estão encontrando erros de falta de memória (OOM) durante a serialização ou desserialização de planilhas.
- Você precisa minimizar a pegada de armazenamento S3/blob e o tempo de trânsito de rede para grandes modelos financeiros recorrentes ou exportações de dados.
A mudança para XLSB costuma ser tão simples quanto alterar uma string de configuração no seu serviço de exportação, mas oferece ganhos de desempenho de 3x a 5x que normalmente exigiriam semanas de otimização de código.
Perguntas Frequentes (FAQ)
**Q1: Um arquivo XLSB suporta os mesmos limites exatos de linhas e colunas que um arquivo XLSX? Sim; tanto o XLSB quanto o XLSX compartilham o mesmo limite de grade de 1.048.576 linhas por 16.384 colunas por planilha.
**Q2: Um arquivo XLSB pode armazenar macros VBA com segurança sem mudar sua extensão de arquivo?
Sim, ao contrário do XLSX (que requer salvar como XLSM para executar código), o XLSB suporta nativamente o armazenamento binário de macros VBA dentro do mesmo formato de arquivo .xlsb.
**Q3: Por que salvar um arquivo como XLSB reduz seu tamanho se ambos os formatos já são comprimidos em ZIP? XLSB elimina tags de marcação de texto verbosas e codifica posições de células, registros e valores numéricos brutos em fluxos binários compactos que comprimem muito mais densamente do que strings XML simples.
**Q4: O Google Sheets pode importar e editar arquivos XLSB diretamente?
Não; o Google Sheets não pode abrir ou converter arquivos .xlsb nativamente, exigindo que você os converta para .xlsx ou CSV antes de importar.
**Q5: Os arquivos XLSB são mais propensos a corrupção de dados do que arquivos XLSX? Embora arquivos XML possam às vezes ser inspecionados ou reparados manualmente com um editor de texto quando parcialmente corrompidos, fluxos binários BIFF12 exigem deslocamentos de bytes estritos e são difíceis de recuperar manualmente se setores estruturais forem danificados.