Последнее обновление: 30 сент., 2026
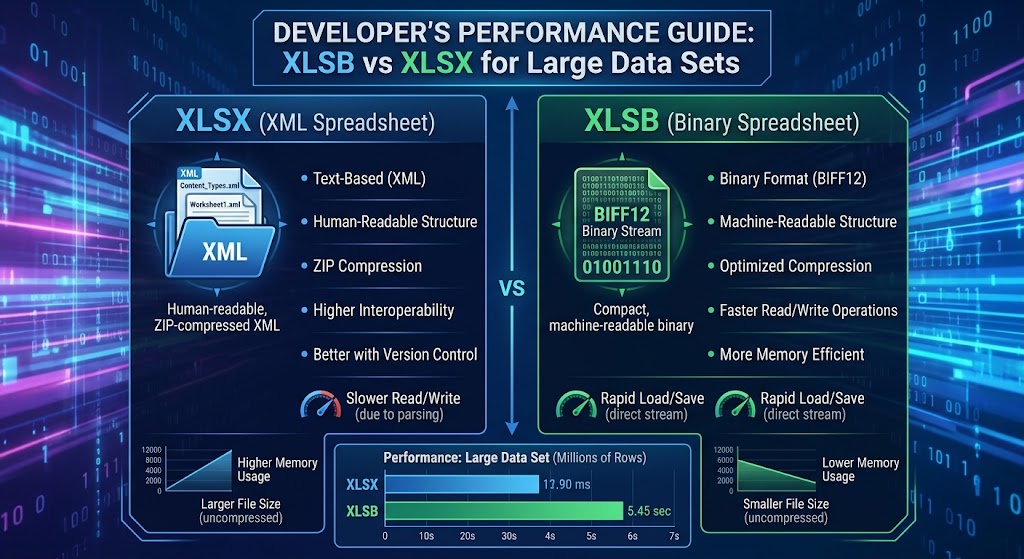
XLSB vs XLSX для больших наборов данных: Руководство разработчика по производительности
Если вы создаёте конвейеры данных, серверные движки отчетности или аналитические инструменты, взаимодействующие с Microsoft Excel, вы, вероятно, столкнулись с «стеной».
Пользователь загружает книгу с 450 000 строками. Ваш сервер поднимает рабочие потоки, потребление памяти резко возрастает до гигабайтов, сборка мусора замораживает выполнение, и ваш процесс истекает по времени. Вы проверяете полезные данные: это стандартный файл .xlsx.
Чтобы решить эту проблему, разработчики часто тратят дни на внедрение разбиения на части, потоковых парсеров или перенаправление файлов в фоновые задачи. Однако одна из самых эффективных оптимизаций не требует никакого переосмысления архитектуры: изменение расширения файла с .xlsx на .xlsb.
В этом руководстве мы заглянем под капот обоих форматов, изучим, почему их внутренние архитектуры дают радикально разные характеристики производительности, сравним конкретные бенчмарки для Python и .NET и изложим чёткие правила, когда использовать бинарные книги в продакшене.
1. Под капотом: OpenXML vs. BIFF12
Чтобы понять, почему производительность так резко различается на больших наборах данных, нам нужно посмотреть, как каждый формат хранит записи на диске.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Оба файла .xlsx и .xlsb являются сжатыми ZIP‑контейнерами, соответствующими Open Packaging Conventions (OPC). Если переименовать любой из файлов в .zip и извлечь его, вы увидите знакомую структуру каталогов: _rels, docProps и xl/worksheets/.
Ключевое различие находится внутри папки xl/worksheets/:
- XLSX хранит листы как обычный XML‑текст (
sheet1.xml). - XLSB хранит листы как проприетарные бинарные потоки (
sheet1.bin), закодированные с использованием BIFF12 от Microsoft (Binary Interchange File Format 12).
Как XLSX кодирует данные (XML DOM Overhead)
В листе XLSX каждая ячейка объявляется с помощью явных XML‑тегов:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
При чтении этой строки ваша среда выполнения должна:
- Разжать исходный поток deflate в текст.
- Токенизировать и разобрать символьные строки в XML‑DOM или поток событий SAX.
- Проверьте открывающие и закрывающие теги (
<c>,</c>,<v>,</v>). - Разрешите поиск строк в отдельной таблице
sharedStrings.xml. - Разберите ASCII‑текст
\"98234.55\"в 64‑битное число с плавающей запятой по стандарту IEEE 754.
Каждая отдельная ячейка требует затрат процессора на разбор строк, их выделение и лексический анализ. Умножьте это на 500 000 строк и 30 столбцов (15 млн ячеек), и процессор тратит значительно больше тактов на разбор синтаксиса, чем на обработку значений домена.
Как XLSB кодирует данные (BIFF12 Binary Stream)
BIFF12 полностью отбрасывает сериализацию текста. Вместо разметки строк данные располагаются в виде последовательной последовательности бинарных записей переменной длины:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Ячейка с плавающей точкой в BIFF12 не использует строковые представления, такие как \"98234.55\". Она представлена напрямую:
- 2 байта для идентификатора записи (например,
BrtCellRkилиBrtCellReal) - 4 байта для индексов столбца/строки
- 8 байт, содержащих необработанную структуру байтов двойной точности IEEE 754
Когда ваш парсер читает файл XLSB, он полностью обходится без лексического разбора. Он читает заголовок записи, захватывает 8 необработанных байт из буфера, копирует их напрямую в память и перемещает указатель вперёд. Нет тегов для проверки, нет преобразований строк в числа, и нулевые затраты на декодирование UTF-8 для числовых данных.
2. Количественные бенчмарки: диск, память и пропускная способность
Чтобы проиллюстрировать реальное влияние, рассмотрим симулированный набор данных, содержащий 750,000 строк и 25 столбцов (смесь меток времени, чисел с плавающей точкой, целых чисел и кодов категорий).
Ниже приведённые тесты оценивают одинаковые табличные данные, сохранённые как в формате XLSX, так и в XLSB.
Тестовая среда
- CPU: AMD Ryzen 9 5900X (12 ядер, 24 потока)
- RAM: 64 ГБ DDR4-3600
- Хранилище: PCIe 4.0 NVMe SSD
- Среда выполнения: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Ключевые метрики производительности
| Метрика | XLSX (OpenXML) | XLSB (BIFF12) | Изменение / Улучшение |
|---|---|---|---|
| Размер файла на диске | 128.4 MB | 68.2 MB | ~47% меньше |
| Сохранение / Время сериализации | 42.6 s | 14.1 s | в 3,0 раза быстрее |
| Время чтения (парсер DOM на Python) | 38.2 s | 8.9 s | в 4,3 раза быстрее |
| Время чтения (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x быстрее |
| Пиковое распределение кучи во время чтения | ~1.85 GB | ~510 MB | ~72% сокращение |
Почему файлы XLSB меньше
Хотя оба формата используют стандартное ZIP-сжатие, бинарные потоки сжимаются гораздо эффективнее, чем раздутый XML‑текст:
- Избыточный синтаксис устранён: XML содержит повторяющиеся теги (
<c r="AA1" s="1">) в каждой записи. Хотя ZIP‑сжатие уменьшает повторяющиеся строки, несжатый поток данных огромен. - Плотность чисел: В XML число
12345678.9012требует 14 байт ASCII‑текста. В BIFF12 оно хранится как 8‑байтовый double (или упаковано в 4‑байтовую записьRK, если соответствует определённым правилам точности).
3. Потребление памяти и нагрузка сборки мусора
Для веб‑сервисов и микросервисов, обрабатывающих одновременные запросы, скорость процессора — лишь половина задачи; потребление памяти — то, где приложения действительно терпят неудачу.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Когда XML‑парсер обрабатывает файл XLSX размером 100 МБ, ему приходится создавать тысячи эфемерных строковых токенов, буферов срезов строк и словарных запросов. В языках с автоматическим управлением памяти (Java, C#, Go, Node.js, Python) это приводит к сильной фрагментации кучи и заставляет среду выполнения часто делать паузы для сборки мусора (GC).
Поскольку разбор XLSB работает напрямую с фиксированными по ширине байтовыми срезами, парсеры могут считывать данные в структуры, размещённые в стеке, или в переиспользуемые байтовые буферы. В результате значительно снижается потребление памяти и нулевое “thrashing” рантайм‑аллокатора.
4. Примеры реализации разработчика
Рассмотрим, как использовать XLSB в типичных цепочках инструментов разработчика.
Python: переход от OpenPyXL к Calamine / PyXLSB
Стандартный вызов pandas.read_excel('data.xlsx') по умолчанию использует openpyxl, который создает тяжёлое дерево в памяти.
Чтобы обрабатывать большие файлы XLSB с максимальной скоростью, используйте движок calamine, написанный на Rust (доступен через python-calamine и интегрирован в современные версии Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Если вы перебираете огромные наборы данных построчно, не загружая всю матрицу в DataFrame, pyxlsb предоставляет лёгкий потоковый итератор:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Высокопроизводительное потоковое потребление
В .NET библиотеки такие как ClosedXML или EPPlus отлично подходят для стандартной генерации, но для чтения больших файлов без исчерпания памяти ExcelDataReader с поддержкой XLSB работает исключительно быстро:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Архитектурные компромиссы: Когда НЕ следует использовать XLSB
Несмотря на его огромные преимущества в производительности, XLSB не является панацеей. Перед тем как внедрять его во всей инфраструктуре, следует оценить несколько эксплуатационных компромиссов:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Экосистема и поддержка библиотек
- XLSX: Универсальный. Практически каждый язык, библиотека, SaaS‑инструмент (Google Sheets, Airtable, Tableau) и веб‑парсер поддерживают OpenXML из коробки.
- XLSB: Менее распространённый. Хотя Excel, LibreOffice и зрелые библиотеки разработчиков (
ExcelDataReader,pyxlsb,calamine,Aspose) поддерживают его, многие лёгкие пакеты или чисто веб‑ориентированные JavaScript‑парсеры (например, более старые сборкиSheetJS) имеют ограниченную или только для чтения поддержку.
2. Сравнение в Git и системах контроля версий
- XLSX: Поскольку он содержит текстовый XML внутри ZIP‑контейнера, утилиты командной строки и Git‑хуки могут распаковывать и форматировать XML, создавая читаемые структурные различия между коммитами.
- XLSB: Чисто бинарные данные. Системы контроля версий рассматривают его как непрозрачный бинарный блоб, исключая любую возможность детального сравнения различий или слияний на уровне строк.
3. Отображение в веб‑клиенте
Если ваша архитектура полагается на непосредственное отображение электронных таблиц в браузере через WebAssembly или клиентский JavaScript, парсеры XLSX значительно более зрелые и менее подвержены ошибкам рендеринга в крайних случаях по сравнению с клиентскими бинарными парсерами.
4. Сторонние конвейеры потребления
Если вы экспортируете файлы для внешних корпоративных клиентов, многие строгие политики корпоративной безопасности помечают файлы .xlsb. Поскольку файлы BIFF12 могут хранить макросы VBA так же, как файлы .xlsm (без необходимости отдельного расширения), некоторые почтовые фильтры и сканеры межсетевых экранов помещают загрузки .xlsb в карантин как потенциальные угрозы с макросами.
6. Сводное сравнение: Какой формат выигрывает?
| Функция | XLSX | XLSB | Победитель |
|---|---|---|---|
| Скорость чтения / разбора | Умеренно до плохой | Молниеносно быстро | XLSB |
| Скорость записи / генерации | Требовательный к процессору | Быстро | XLSB |
| Сжатие файлов | Хорошо | Отлично (~40-50% smaller) | XLSB |
| Выделение памяти | Высокий (Сильное давление GC) | Низкий (Прямое чтение байтов) | XLSB |
| Взаимодействие инструментов | Универсальная | Высокий, но избирательный | XLSX |
| Трудности сканирования безопасности | Минимальный | Редкие ложные срабатывания | XLSX |
| Возможности макросов | Нет (.xlsm требуется) | Да (Поддерживает макросы из коробки) | Связать |
7. Вердикт разработчика
Используйте XLSX, когда:
- Файлы небольшие‑среднего размера (< 50 000 строк).
- Ваши файлы должны быть импортированы сторонними SaaS‑платформами или потребительскими приложениями (например, Google Sheets).
- Вы не можете контролировать среду конечного клиента, читающего файл.
Перейдите на XLSB, когда:
- Вы создаёте внутренние конвейеры, пакетные задания, ETL‑системы или рабочие задачи, обрабатывающие огромные извлечения данных (> 100 000 строк).
- Ваши серверы сталкиваются с ошибками нехватки памяти (OOM) во время сериализации или десериализации таблиц.
- Вам необходимо минимизировать объём хранилища S3/blob и время передачи по сети для больших периодических финансовых моделей или экспорта данных.
Переход на XLSB часто сводится к простому изменению строки конфигурации в вашем сервисе экспорта, однако он обеспечивает прирост пропускной способности от 3 до 5 раз, который обычно требует недель оптимизации кода.
Часто задаваемые вопросы (FAQ)
**Q1: Поддерживает ли файл XLSB те же самые ограничения по строкам и столбцам, что и файл XLSX? Да; оба формата XLSB и XLSX имеют одинаковый предел сетки — 1 048 576 строк и 16 384 столбца на лист.
**Q2: Может ли файл XLSB безопасно хранить макросы VBA без изменения расширения файла?
Да, в отличие от XLSX (для выполнения кода требуется сохранять как XLSM), XLSB нативно поддерживает бинарное хранение макросов VBA внутри того же формата файла .xlsb.
**Q3: Почему сохранение файла в формате XLSB уменьшает его размер, если оба формата уже сжаты ZIP? XLSB устраняет громоздкие текстовые теги разметки и кодирует позиции ячеек, записи и необработанные числовые значения в компактные бинарные потоки байтов, которые сжимаются гораздо плотнее, чем обычные строки XML.
**Q4: Может ли Google Sheets импортировать и редактировать файлы XLSB напрямую?
Нет; Google Sheets не может напрямую открывать или конвертировать файлы .xlsb, поэтому необходимо преобразовать их в .xlsx или CSV перед импортом.
**Q5: Склонны ли файлы XLSB к более частому повреждению данных, чем файлы XLSX? В то время как XML‑файлы иногда можно вручную просмотреть или восстановить с помощью текстового редактора при частичном повреждении, бинарные потоки BIFF12 требуют точных байтовых смещений и их сложно восстановить вручную, если повреждены структурные сектора.